无界随机博弈中的均衡学习:高斯转移下的新方法

提出基于高斯过程与有限博弈精炼的无界随机博弈均衡学习框架并给出收敛保证。
该论文针对无界状态空间下的一般和随机博弈均衡学习难题,提出了一种新的理论框架与算法。问题设定中状态位于欧几里得空间且无界,转移概率由未知非线性漂移函数与高斯噪声决定,动作集为紧集。作者设计了一个交替迭代算法:先用单条轨迹数据构建高斯过程后验模型以估计漂移函数及其不确定性,再在当前模型下将博弈离散化为有限博弈求解均衡,并逐步精炼区域。理论方面,论文证明当均衡选择稳定且 GP 模型在 KL 散度意义下一致精确时,诱导值函数在指定区域上一致收敛到真实均衡值,策略趋向近似纳什行为。GP 估计器的收敛率由后验不确定性、核信息增益和联合状态维度共同决定。数值实验验证了核函数选择与状态维度对收敛速度的显著影响,与理论预测吻合。该工作将均衡学习从有界状态空间推广到无界场景,为多智能体强化学习与博弈论交叉领域提供了新起点。
在现实世界中,多智能体决策往往发生在状态空间没有明确边界的复杂环境中——从经济市场的价格波动到机器人群体的协同控制,系统状态可能无限延伸,而决策者之间的交互持续不断。这种场景下,如何从数据中学习均衡策略,一直是博弈论与机器学习交叉领域的核心难题。
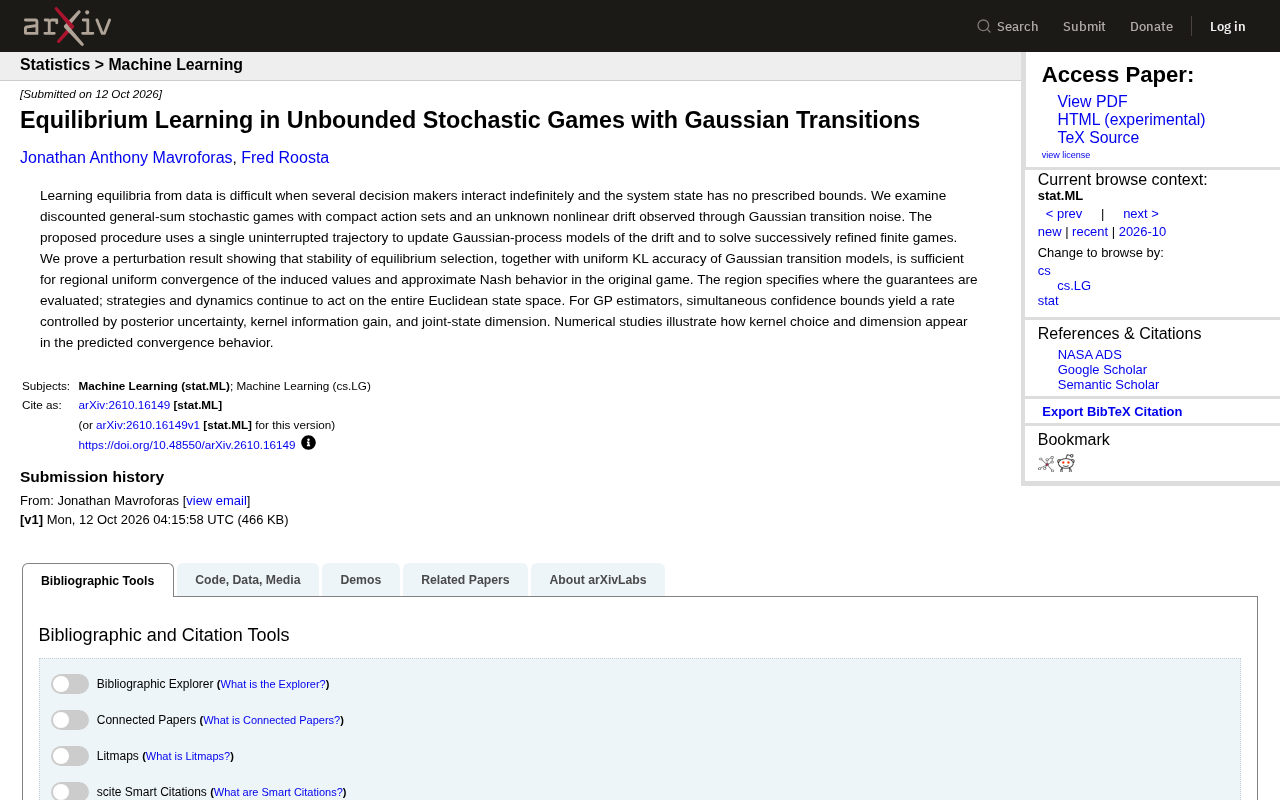
近日,一篇题为《Equilibrium Learning in Unbounded Stochastic Games with Gaussian Transitions》的研究论文,针对这一挑战提出了新的理论框架与算法。该工作聚焦于折扣一般和随机博弈(discounted general-sum stochastic games),其中动作集为紧集,系统状态在欧几里得空间上无界,且转移概率由未知的非线性漂移项与高斯噪声共同决定。
问题设定:无界状态与未知动态
传统随机博弈的均衡学习通常假设状态空间有限或紧致,从而便于值函数的收敛性分析。然而,当状态空间无界时,值函数可能发散,策略的稳定性也面临根本性挑战。论文作者将问题建模为:状态 $s \in \mathbb{R}^d$,动作集 $A_i$ 为紧集,转移核为 $P(s'|s,a) = \mathcal{N}(s' | f(s,a), \Sigma)$,其中 $f$ 是未知的非线性漂移函数,$\Sigma$ 为已知或可估计的噪声协方差。
决策者通过一条不间断的轨迹与环境交互,观测到带噪声的状态转移。目标是学习一个近似纳什均衡策略,使得在状态空间的某个区域上,值函数与真实均衡值一致。
折扣一般和随机博弈(discounted general-sum stochastic games)是随机博弈的一个变体:多个决策者(智能体)在离散时间步上同时选择动作,系统状态按转移概率演化,每个智能体获得各自的即时奖励。与零和博弈不同,一般和博弈中智能体的利益并非完全对立,均衡概念通常采用纳什均衡——任何一方都无法通过单方面改变策略来提升自身回报。“折扣”指未来奖励按折扣因子 $\gamma \in [0,1)$ 指数衰减,这保证了无限期回报总和在适当条件下有界,从而使值函数良定义。当状态空间无界时,折扣因子成为值函数不发散的关键:即便即时奖励随状态增长,只要增长速率受控且 $\gamma<1$,值函数仍可能保持有限。
紧集(compact set)是拓扑学中的概念,指一个集合既是有界的又是闭的(在欧几里得空间中与此等价)。动作集为紧集意味着智能体可选择的动作范围虽然可能连续且无限多,但不会无限延伸,且包含所有极限点。这一假设在算法分析中至关重要:它保证了最优动作的存在性(连续函数在紧集上取到极值),也使得策略空间的弱紧性等性质可用于均衡存在性证明。若动作集非紧,均衡可能不存在,或算法可能收敛到无穷远处的退化策略。
方法核心:高斯过程模型与逐步精炼的有限博弈
作者提出的算法框架包含两个交替进行的步骤:
-
高斯过程(GP)建模:利用单条轨迹上的观测数据,对未知漂移函数 $f$ 建立高斯过程后验模型。GP 不仅提供均值预测,还给出后验不确定性(方差),这是后续置信边界的基础。
-
有限博弈求解:在当前 GP 模型下,将原无界博弈在状态空间的一个有限区域内离散化,求解一个有限博弈的均衡。该有限博弈的解随后被用于指导策略更新,并逐步精炼区域范围。
这种“模型学习—有限博弈求解”的交替迭代,使得算法能够在探索与利用之间取得平衡,同时利用 GP 的不确定性量化来保证收敛。
高斯过程(Gaussian Process, GP)是一种定义在连续域上的随机过程,其任意有限个点的取值服从联合高斯分布。在机器学习中,GP 常用作贝叶斯非参数回归工具:给定观测数据,GP 后验给出对未知函数在任意查询点的预测均值与方差。预测均值可视为对漂移函数 $f$ 的最佳估计,而方差则量化了该点附近的不确定性——数据稀疏处方差大,数据密集处方差小。这种不确定性量化是算法安全探索的理论基础:置信边界(如均值的 $\pm$ 若干倍标准差)以高概率覆盖真实函数值。GP 的行为由核函数(协方差函数)决定,核函数编码了函数的平滑性、周期性等先验假设。常用的平方指数核假设函数无限可微,而 Matérn 核通过平滑参数控制可微阶数,更贴近物理系统的真实动态。
信息增益(information gain)在 GP 框架下指后验分布相对于先验分布的熵减少量,衡量一次观测能带来多少关于未知函数的信息。在收敛率分析中,累积信息增益 $\gamma_T$ 刻画了 $T$ 步后 GP 模型不确定性的总缩减量。对于常见核函数,$\gamma_T$ 随 $T$ 的增长速率(次线性)直接决定了遗憾界或估计误差的收敛速度。当状态维度 $d$ 增大时,$\gamma_T$ 通常增长更快(例如平方指数核下约为 $O((\log T)^d)$),意味着高维空间中需要更多样本才能达到同等精度,这解释了论文中“维度上升导致收敛变慢”的理论预测。
理论保证:扰动分析与收敛率
论文的核心理论贡献在于一个扰动结果:如果均衡选择是稳定的,并且高斯转移模型在 KL 散度意义下具有一致精度,那么诱导值函数将在某个指定区域上一致收敛到真实值,且策略趋向于近似纳什行为。这里,“区域”指定了保证成立的范围,但策略与动态仍在整个欧几里得空间上作用。
对于 GP 估计器,作者推导了同时置信边界,其收敛率由三项因素控制:后验不确定性、核函数的信息增益(information gain),以及联合状态维度。这一结果揭示了核选择与维度如何影响收敛速度——例如,在更高维度下,信息增益增长更快,导致收敛率下降。
KL 散度(Kullback-Leibler divergence)是衡量两个概率分布差异的非对称度量,定义为 $D_{KL}(P|Q)=\mathbb{E}_P[\log(P/Q)]$。在论文语境中,“高斯转移模型在 KL 散度意义下具有一致精度”意味着:算法所使用的高斯转移核 $\mathcal{N}(s'|\hat{f}(s,a),\Sigma)$ 与真实转移核 $\mathcal{N}(s'|f(s,a),\Sigma)$ 之间的 KL 散度在整个相关区域上被一致地控制在一个小量以内。由于两个高斯分布均值不同而协方差相同时,KL 散度正比于均值差的平方,因此这一条件本质上要求 GP 对漂移函数 $f$ 的估计误差在区域内一致地小。该假设是连接统计估计误差与博弈均衡偏差的桥梁:转移模型的精度通过扰动分析传播到值函数和策略的精度上。
同时置信边界(simultaneous confidence bound)与逐点置信边界不同,它要求在整个状态-动作空间(或无限多个点上)同时以高概率成立,而非仅对单个固定点成立。在 GP 回归中,逐点置信区间容易构造,但无限多个点的联合覆盖需要更精细的工具,如对再生核希尔伯特空间(RKHS)范数进行控制。论文推导的同时置信边界形如 $|f(s,a)-\hat{f}(s,a)| \leq \beta_t \sigma_t(s,a)$,其中 $\sigma_t$ 是后验标准差,$\beta_t$ 是随步数 $t$ 缓慢增长的置信系数(通常依赖信息增益 $\gamma_t$ 和维度 $d$)。这一边界的成立使得算法可以在每一步选择乐观估计(面对不确定性时采取乐观策略),从而在理论上保证有效探索。
数值实验:核函数与维度的影响
论文通过数值研究验证了理论预测。实验显示,不同核函数(如平方指数核与 Matérn 核)会导致不同的收敛行为,且随着状态维度增加,收敛所需的样本量显著上升。这些结果与理论分析中“核信息增益”和“联合状态维度”的作用相吻合。
意义与展望
这项工作的价值在于将均衡学习从有界状态空间推广到无界场景,并给出了严格的收敛保证。尽管当前分析依赖于高斯转移噪声和稳定均衡选择等假设,但它为后续研究打开了多个方向:例如,如何处理非高斯噪声、如何在线调整区域划分、以及如何将方法扩展到部分可观测场景。
对于多智能体强化学习与博弈论交叉领域的研究者而言,这篇论文提供了一个兼具理论深度与算法可行性的新起点。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。