无锁索引树如何实现扩展:规避线程切换与停顿

David Lomet 系统阐述了以 Notices 机制解决无锁 B-tree 高争用下冗余构建浪费的设计思路。
微软研究院院士 David Lomet 在技术分享中系统讲解了无锁索引树的演进思路。传统闩锁在高负载下导致线程碰撞与切换,BW-Tree 用 CAS 加 Delta 更新解决了互斥瓶颈,但多线程同时竞争合并时仍会产生大量无用功。为此,Lomet 提出「Notices」机制:线程先用低成本操作竞争「执行权」,赢家发布 Notice 后再独自完成昂贵的合并工作,其他线程则继续在 Notice 之上堆叠 Delta,互不干扰。这一思路同样延伸到 B-tree 最难的节点分裂与合并操作中,配合过渡状态和 epoch 内存回收机制,在不引入锁的前提下保证了正确性与高扩展性。
数据库领域泰斗 David Lomet(微软研究院数据库研究组创始人、美国国家工程院院士)在一场技术分享中,系统阐述了无锁(Latch-Free)索引树的设计思路。这场演讲延续了他在微软主导的 BW-Tree 工作,并引入了一个名为「通知(Notices)」的新机制,用以解决高并发场景下的扩展性瓶颈。
本文梳理其核心观点:为什么传统闩锁(latch)会限制扩展、无锁技术的基础原理、Delta 更新与合并策略的局限,以及 Notices 如何在高争用下显著降低无用功。
为什么闩锁会成为扩展的瓶颈
Lomet 首先厘清了一个关键认知:在高负载下,热点数据反而会拖累性能。低负载时,热点数据让缓冲池缓存和硬件缓存更高效;但当系统逼近性能极限时,高更新率带来的数据争用就会成为限制因素。
问题的根源在于传统闩锁方案依赖互斥。更新需要通过闩锁获得独占访问,这会同时干扰写入和读取——读取也必须加锁以防被更新干扰。结果就是在极高负载下,线程彼此碰撞、相互阻塞。
一旦发生碰撞,代价远比代码表面看起来的要高:线程要么进入自旋锁(stall),要么执行一次线程切换(约消耗数千条指令),要么下沉到操作系统层去处理 IO。Lomet 特别指出,即便是 SQL Server 自带的 OS 层,线程切换成本同样无法回避。真实的代码执行路径因此远比字面长度要长。
正是这个原因,微软的内存数据库系统 Hekaton 选择了无锁技术,并由 Lomet 团队提供了配套的 BW-Tree。
无锁基础:Compare-and-Swap 的双刃剑
无锁技术的核心工具是 Compare-and-Swap(CAS,比较并交换)。它通过原子操作将一个指针从旧状态切换到新状态——前提是旧状态自上次读取后未发生改变,否则操作失败。最终只有一个线程能成功安装新状态。
CAS 的精髓在于:失败的线程不会被阻塞,而是可以转去做其他有用的工作。这与闩锁的「死等」形成鲜明对比。但无锁并非万灵药,它有两个隐患:
- 多个线程可能冗余地构建相同的新状态;
- 如果新状态构建成本高昂,大量失败线程所做的工作就全部白费。
Lomet 强调,在高争用场景下,这种「无用功」可能和一次线程切换一样昂贵。换句话说,如果无锁技术使用不当,扩展性照样会受限。
CAS 在现代 CPU 上通常以单条指令实现(如 x86 的 CMPXCHG),由硬件保证原子性,无需操作系统介入。它是构建无锁数据结构的基石:线程在修改前先读取当前值作为「期望值」,修改完成后用 CAS 尝试将指针从期望值切换到新值——若此间其他线程抢先修改过该指针,CAS 失败,本线程须重试。这套机制从根本上消除了互斥等待,但也引入了 ABA 问题:指针值从 A 变为 B 再变回 A,CAS 无法感知中间发生的变化,可能错误地认为状态未改变。BW-Tree 通过映射表(Mapping Table)间接寻址规避了这一问题——CAS 操作的是映射表中的槽位指针,页面本身从不被原地修改,配合 epoch 机制确保旧版本在所有线程都不再引用之前不会被回收。
Delta 更新与合并:BW-Tree 的策略与局限
BW-Tree 引入的 Delta 更新大幅降低了构建新状态的成本。其做法是:映射表中的指针不再直接指向页面,而是通过 CAS 指向一个 Delta 更新节点,该 Delta 再指向旧页面。Delta 记录的是对页面的增量修改,因此构建成本极低。
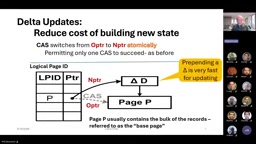
但 Delta 更新会损害读性能。单个 Delta 影响不大,可随着更新累积,Delta 会不断堆叠,读取时需要线性遍历整条 Delta 链。由于页面搜索极为频繁,这对性能有显著副作用。
解决办法是周期性地「合并(consolidation)」:将所有 Delta 与基础页面重新构建成一个专为读取优化的「合并页面」,再通过 CAS 安装替换掉带有长 Delta 链的旧结构。合并本身也是无锁的,同样依靠 CAS 完成。
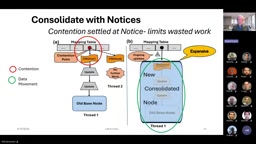
Lomet 将 Delta 更新比作一个「待处理更新队列」,系统把这些更新批量应用到基础页面上,而非逐条处理,从而摊薄了大规模重组的成本。「Delta 更新 + 合并」是一个相当有用的策略,但它仍有问题:当多个线程同时竞争执行合并时,只有赢家的工作有效,其余线程的合并全是浪费。
Notices:竞争「安装权」而非「安装结果」
这正是新机制 Notices 要解决的核心问题。传统做法是线程各自构建新页面、再竞争安装,输家的构建工作全部作废。Notices 的思路则是——让线程先竞争「执行这项工作的权利」。
赢得竞争的线程并不立刻安装新页面,而是先在争用点发布一个 Notice(通知),告诉其他线程「这个活我接了」。其他线程看到 Notice 后,就不再去构建冗余的新状态,而是把自己的 Delta 更新堆叠在 Notice 之上,继续各自的工作。
关键原则是:在发布 Notice 之前,尽量少做工作。因为 Notice 发布前的工作在竞争失败时都会作废,所以应把昂贵的工作尽可能推迟到争用解决之后。这样一来,唯一会被浪费的工作就只是「尝试发布 Notice」本身。
Notice 发布后,它会保护其下方的旧状态不被修改,赢家线程可以在「离线」状态下从容构建合并页面——这是最昂贵的部分,但只由一个线程完成。话说回来,其他线程的持续更新仍可通过 Delta 堆叠在 Notice 之上,互不干扰。
值得一提的是读写竞态(race condition)的处理。遍历旧状态的线程对新合并节点的安装是「无感」的,它会继续沿旧路径执行。系统通过 epoch(纪元)机制管理内存的分配与回收,保证旧状态会一直存在,直到没有任何线程还能看到它。Lomet 坦言,这类竞态在几乎所有并发控制方法中都存在——包括闩锁——实现者必须做好应对准备。读取看到的可能不是最新状态,但永远是一个有效状态。
应对结构修改:分裂与合并的挑战
合并操作只涉及单个节点,相对简单。真正的难点在于 B-tree 风格的结构修改操作(SMO),它们涉及多个节点,Notices 必须额外提供「过渡状态(transition state)」。
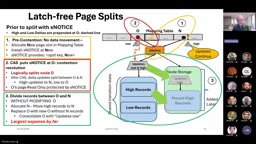
节点分裂:发布 Notice 前只做极少的准备工作——为新节点分配一个映射表槽位(stub),并让其指向包含分裂键和新节点地址的分裂 Notice。争用点是对旧节点执行 CAS 安装 S-Notice。安装后,S-Notice 会指引更新流向:低键更新去旧节点,高键更新去新节点。昂贵的工作——复制高键记录和高键 Delta 到新节点——都发生在争用解决之后,且只由一个线程完成。Lomet 指出,这正是对 BW-Tree 的改进:昂贵工作被推迟到了争用解决之后。
这里同样涉及过渡状态。类似 B-link 树的做法,旧页面会短暂同时持有新旧两份数据,随后惰性地移除高键记录。线程必须理解这种过渡状态,知道旧页面中暂时包含了逻辑上不属于它的记录。
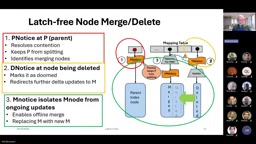
节点合并:这历来是 B-tree 最难的部分。流程需要多个 Notice 协同:先在父索引节点发布 P-Notice,冻结子树状态、阻止父节点分裂并解决争用;在被删除节点上发布 D-Notice,将后续更新重定向到吸收节点;在合并节点上发布 M-Notice,保护待合并状态。
三类 Notice 分工明确:P-Notice 决定谁来执行合并;D-Notice 阻止对被删节点的进一步更新;M-Notice 保护合并状态不被干扰。只有 M-Notice 下方的内容会被纳入最终合并状态,之上堆叠的更新则包括了原本发往被删节点和合并节点的更新。昂贵的合并工作同样只由赢得 P-Notice 的单个线程完成。
B-link 树(B-tree 的一种变体,由 Lehman 和 Yao 于 1981 年提出)是处理并发结构修改的经典参考。其核心思想是在每个节点中增加一个指向右兄弟节点的「链接指针」,并记录该节点的高键(high key)。当分裂正在进行时,即使父节点尚未更新,沿着链接指针向右扫描就能找到目标键所在的新节点,从而避免了分裂操作必须原子地同时修改子节点和父节点的需求。这将原本需要多步原子操作的 SMO 转化为可以分阶段完成的过渡状态,代价是读取可能需要多跟一跳右向链接。Lomet 在 Notices 的节点分裂设计中借鉴了这一思路——旧节点短暂同时持有新旧两份数据,线程须理解过渡状态并能沿指针找到正确位置,与 B-link 树的处理哲学一脉相承。
延伸思考:内存管理与缓存效率
Lomet 最后补充了几点。内存管理必须确保线程只看到「之前状态」或「之后状态」,绝不出现破碎的中间态——BW-Tree 用 epoch 机制实现,他认为这是处理此类问题最高效的方式。
无锁机会并不局限于访问方法。在日志结构存储中,分配缓冲区空间使用了 fetch-and-increment 原子指令:两个线程竞争时都能成功,一个拿到低位缓冲区、一个拿到高位,皆大欢喜。这种批量写入不仅减少了存储写入次数,还能用极简单的方式管理。
他还提到一个未展开的方向:硬件内存缓存效率。访问非缓存主存可能耗费 100 个甚至更多周期,因此像当年与 Jim Gray 合作的 AlphaSort 那样做到缓存友好,同样是性能关键。Lomet 笑称「已经给你们透露太多了」,这部分留作后续。
Epoch(纪元)机制是无锁系统中管理内存安全回收的主流方案,解决的是「何时可以安全释放旧版本对象」这一核心难题。其基本思路是:系统维护一个全局纪元计数器,每个线程在访问共享数据前登记当前纪元,退出时注销。被替换的旧对象不会立即释放,而是被标记为「待回收」并附上退役时的纪元号。当所有活跃线程的纪元号都推进到旧对象退役纪元之后,可以确定没有任何线程还持有该对象的引用,此时才真正释放内存。与引用计数相比,epoch 机制的读取路径几乎无开销(仅需读写一个线程本地变量),且天然避免了循环引用问题;代价是回收存在延迟,在线程长期不退出临界区时可能积累大量待回收对象。Hekaton 和 BW-Tree 均采用了这一机制。
相关推荐

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。