无线GPU破解本地AI两大难题:Wi-Sci实测解析

Wi-Sci用私有协议和SSD调度,让无线GPU和千亿模型在消费级硬件上跑通。
Wi-Sci展示了一套无线GPU计算方案,通过自研协议将PCIe级通信压缩到Wi-Fi带宽,使笔记本能远程调用RTX 5090以92帧运行游戏。同时,它利用MoE模型的稀疏激活特性,结合专家对齐分块、热专家驻留、计算拆分和调度器预加载四项优化,让32GB显存的设备以8-15 tokens/秒运行7500亿参数的DeepSeek 4.1 Flash。调度器还支持多AI应用快速切换,切换时间从18秒降至4-8秒,实现家庭多设备共享GPU。尽管目前为工程样机且速度有波动,但展示了消费级硬件运行超大模型的可行性。
一台“不属于你”的GPU,正在改写本地AI的规则
想象一下:你的轻薄本突然在任务管理器里显示出一块RTX 5090,并且真的能用它跑《赛博朋克2077》和Blender渲染。这不是远程桌面,也不是云游戏——游戏逻辑仍在本地运行,只是GPU通过Wi-Fi远程调用。更夸张的是,一台只有32GB显存的设备,居然能全质量运行7500亿参数的DeepSeek广告 4.1 Flash模型,而传统方案需要超过500GB内存。
这就是Wi-Sci(Wireless Computing Infrastructure)展示的场景。YouTube创作者Chuck在深度体验后直言:“这玩意儿根本说不通,但它就是 works。”本文基于他的实测视频,拆解这套方案如何用自研协议和SSD调度,同时解决无线GPU通信和超大模型本地推理两个看似无解的问题。
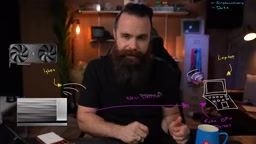
无线GPU如何骗过操作系统
自研协议替代PCIe:从“不可能”到“够用”
桌面级GPU依赖PCIe与主机通信,带宽高达每秒512吉比特,响应时间不到一微秒。而Wi-Fi的理论带宽仅每秒1吉比特左右,往返延迟约1.5毫秒——看似很小,但Chuck用一个类比点破了问题:如果PCIe传递一张图片需要1秒,Wi-Fi就需要25分钟。游戏每秒钟要交换数千次指令和数据,按这个延迟,画面会卡成幻灯片。
Wi-Sci的解法不是提升带宽,而是减少通信量。他们开发了一套私有协议,核心思路是“让GPU和主机少说话”:
- 指令批量压缩:将多个指令打包压缩后发送,不等待确认;
- 增量数据传输:只发送变化的数据,避免重复传输;
- 预测性应答:GPU不等主机提问就提前发送可能需要的响应;
- 视频流压缩回传:GPU将渲染结果压缩后传回笔记本。
这四招把原本需要的每秒8吉比特带宽压缩到约400兆比特。实测中,笔记本以92帧/秒运行《赛博朋克2077》,Wi-Fi占用稳定在400兆比特左右。
PCIe(Peripheral Component Interconnect Express)是当前计算机主板与GPU、SSD等高速外设之间的标准串行总线。其带宽随代际翻倍:PCIe 4.0 x16 双向带宽约每秒64吉比特,而文章提到的每秒512吉比特对应的是PCIe 5.0/6.0多通道聚合或GPU内部互联(如NVLink)级别的数据。更关键的是延迟:PCIe的往返延迟在亚微秒级,而Wi-Fi的往返延迟在毫秒级,两者相差三个数量级。这种延迟差异对游戏渲染管线是致命的,因为GPU需要与CPU频繁同步每帧的绘制指令和资源状态。因此,Wi-Sci的私有协议必须从根本上改变通信模式,而非简单压缩数据。
伪装驱动:让笔记本“相信”自己有一块5090
光有协议还不够。操作系统和游戏必须认为这块GPU是本地设备,否则无法调用。Wi-Sci安装了一个“假驱动”,让Windows和游戏引擎将远程GPU识别为本地PCIe设备。Chuck在任务管理器中看到5090赫然在列,游戏全程没有察觉异常。
这套方案的本质是把GPU变成网络服务,但保持本地调用的语义。对于游戏场景,它依赖的是“前端本地、后端远程”的架构——游戏逻辑、输入输出都在笔记本上,只有渲染计算被卸载到无线GPU。
本地AI的“内存墙”与SSD救场
大模型为什么跑不动:显存与内存的鸿沟
当前最强的开源本地模型(如Kimi K3、GLM 5.3、DeepSeek 4.1)已经接近前沿闭源模型的智能水平,但代价是巨大的内存需求。以DeepSeek 4.1 Flash为例,全质量运行需要超过500GB内存。即便是配备512GB内存的Mac Studio也难以舒适运行,更不用说消费级GPU的32GB显存。
传统方案只能把模型权重放在SSD上,按需加载。但SSD的速度远低于显存:RTX 5090的显存带宽约每秒1.8TB,DDR5内存约每秒90GB,而SSD仅每秒14GB。更致命的是,LLM推理时每次生成一个token(词元)都需要传输大量权重,且SSD对小块随机读取的性能极差——实际有效带宽可能降至每秒1-5吉比特,导致每个词耗时数秒甚至数分钟。
MoE模型带来转机,但还不够
DeepSeek 4.1 Flash是混合专家(MoE)模型,拥有384个专家,每次生成token只激活其中6个。这意味着每次只需传输约15GB的权重,而非全部508GB。理论上,这能把每个token的生成时间从“不可用”拉低到十几秒——依然太慢。
问题在于:路由器(router)动态选择专家,无法预知下一词会用到哪6个,因此整个模型必须保持可访问。如果全部放在SSD上,随机读取的瓶颈依然存在。
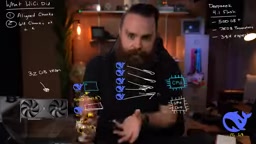
混合专家(Mixture of Experts, MoE)是一种稀疏激活的模型架构。传统稠密模型在每个token生成时都会调用全部参数,而MoE模型将前馈网络拆分为多个“专家”子网络,并通过一个可学习的路由器(router)为每个token动态选择少数几个专家参与计算。例如DeepSeek 4.1 Flash有384个专家,但每个token只激活6个,这使得单次推理的计算量和权重读取量大幅降低。然而,路由器的选择是数据依赖的,无法在推理前预知,因此所有专家权重必须保持可访问。这给存储带来了挑战:活跃专家需要快速读取,非活跃专家也不能被完全丢弃。Wi-Sci的优化正是围绕如何高效管理这些专家权重展开的。
Wi-Sci的四项优化:让SSD跑出接近内存的速度
Wi-Sci针对SSD推理做了四项工程优化,每一项都直击痛点:
- 专家对齐分块:重写模型文件,使每个专家大小一致且按64块对齐,大幅提升SSD顺序读取效率,带宽从每秒1GB提升到约每秒11.5GB。
- 热专家驻留:将最常被选中的专家常驻在VRAM和RAM中,只有约1GB的专家需要从SSD实时拉取。
- 计算拆分:来自SSD或RAM的权重由CPU处理,来自VRAM的权重由GPU处理,避免数据搬运。
- 调度器预加载:在应用切换时提前将模型从SSD调入内存,减少等待。
实测中,DeepSeek 4.1 Flash在Wi-Sci盒子上达到约8-15 tokens/秒的生成速度,且大部分专家命中GPU缓存。Chuck用自定义可视化工具展示了专家选择过程:61%的响应来自GPU,SSD读取速度稳定在10GB/秒以上。
SSD的随机读取性能远低于顺序读取,这是NAND闪存的物理特性决定的。当读取请求分散在不同闪存块时,SSD需要频繁切换页和块,导致有效带宽骤降。文章提到的“专家对齐分块”本质上是将模型文件重新布局,使每个专家的权重在SSD上连续存储,并按闪存页大小(如64KB)对齐,从而将随机读取转化为顺序读取。此外,“热专家驻留”利用了MoE模型中专家选择的偏斜分布——少数专家被频繁调用,将这些专家常驻在VRAM/RAM中,可以避免大量SSD读取。计算拆分则是一种异构计算策略:CPU处理来自SSD/RAM的权重,GPU处理VRAM中的权重,减少数据在PCIe总线上的搬运开销。这些优化共同将SSD的有效带宽从每秒1GB提升到约11.5GB。
“家庭GPU”愿景:共享调度器的实战表现
GPU为什么不会共享
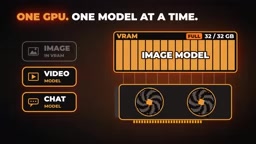
GPU天生不擅长多任务共享。当一个模型(如图像生成)占满32GB显存时,切换到另一个模型需要将前者完全换出,再从SSD加载后者。这个过程可能耗时十几秒,体验割裂。Wi-Sci的调度器试图解决这个问题:它把不活跃的模型“停泊”到SSD,但保留快速恢复的上下文。当用户切回时,模型从SSD快速载入,而不是从头加载。
Chuck用一段演示对比了有无调度器的差异:从图像模型切回聊天模型,无调度器时需要约17-18秒,有调度器时仅需约4秒;反向切换从约18秒降至约8.6秒。虽然仍有延迟,但已经进入可用范围。
多设备同时调用:Mac、手机、平板都能用
在演示中,一台Mac通过Wi-Fi连接Wi-Sci盒子,使用Figma生成图像、用Love Art生成视频、用DaVinci Resolve渲染视频。GPU在多个任务间调度,虽然不能真正并行,但切换成本被大幅降低。Chuck认为,这种“家庭GPU”模式让手机、平板、笔记本都能共享一块桌面级GPU,类似于早年全家共用一台电脑的场景。
现实局限与行业意义
Wi-Sci目前是早期工程样机,Chuck收到的版本装在塞满气泡膜的行李箱里。产品提供RTX 5090和5060 Ti两个版本,已经开放预订,预计八周后发货。实测中,无线游戏和本地大模型推理都跑通了,但仍有波动:生成速度在3-15 tokens/秒之间浮动,取决于专家命中率和缓存状态。
从行业视角看,Wi-Sci的价值不在于某一项技术突破,而在于系统级整合:用私有协议解决无线延迟、用文件格式优化释放SSD带宽、用调度器实现GPU分时复用。这三者叠加,让“消费级硬件跑千亿级模型”从不可能变为勉强可用。
Chuck在视频结尾的感慨或许代表了多数观众的感受:“我全程都在怀疑,但它确实在工作。”对于本地AI爱好者,这提供了一条不依赖云端的全新路径;对于硬件行业,它提示了GPU共享化和无线化的可能性。当然,这一切还需要等待量产验证和生态适配。
相关推荐

GPT-Image 2.6双版本发布:速度与精度的双重升级
OpenAI发布GPT-Image 2.6,包含Flare和Sunburst两个版本,Flare主打更快生成速度,Sunburst处理复杂提示词与密集信息图。API新增标记编辑、SVG和GIF支持,让图像生成更可迭代、可编辑、可集成。

罗伯特·卡罗:如何让知情人开口,揭开约翰逊金钱政治的隐秘逻辑
普利策奖得主罗伯特·卡罗分享采访约翰·康纳利的经验,揭示如何通过追问约翰逊资金批注细节,让知情人说出本不该说的政治资金运作逻辑。

Sam Altman就RAM言论大转弯:"真让人恼火"
Sam Altman因关于RAM的争议性言论引发社区反弹,随后态度出现180度反转并回应"真让人恼火"。本文梳理事件脉络,分析内存为何成为AI行业的敏感话题,以及高管快速转向背后的公关逻辑与对开发者的实际启示。