无需训练数据的扩散模型:格点场论采样新突破

研究提出数据自由训练方案,让扩散模型仅凭未归一化密度即可学会从格点场论平衡态分布中采样。
格点场论中从平衡态分布采样是核心瓶颈,传统HMC方法成本随系统尺寸急剧上升。扩散模型虽为生成式采样器,但其标准去噪分数匹配训练需要目标分布样本,这恰是想要解决的采样问题。最新研究提出"数据自由训练"方案,基于目标分数恒等式,利用未归一化概率密度(作用量已知)构造训练目标,无需任何先验采样数据。通过重要性加权和无加权两种实现路径,在二维φ⁴理论的对称相、临界相和破缺相中,数据自由训练达到与HMC参考数据训练相当的性能。该方法将扩散模型从"加速器"推向"自举器",但目前限于二维标量场论,向四维规范理论推广仍面临参数化复杂度和训练稳定性等挑战。
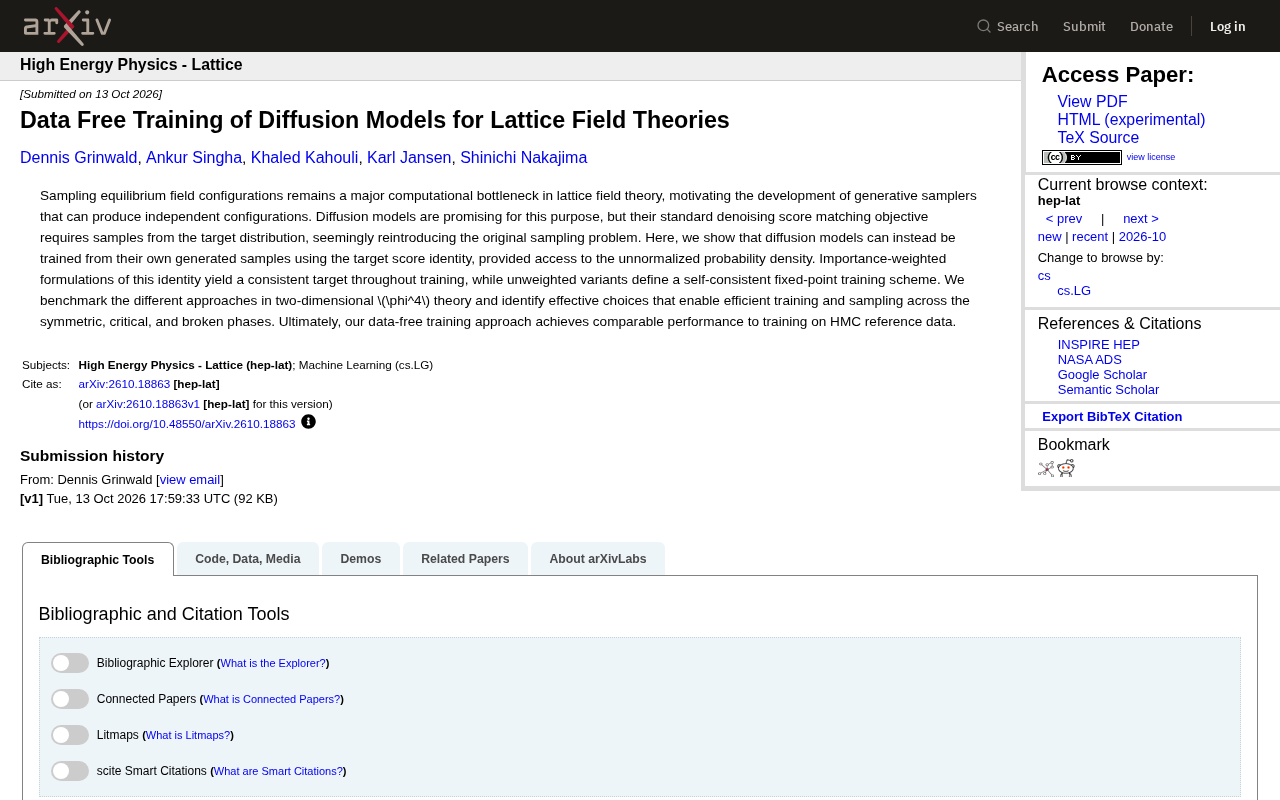
格点场论中,从平衡态分布采样场构型一直是计算物理的核心瓶颈。传统方法如混合蒙特卡洛(HMC)虽然成熟,但生成独立构型的计算成本随系统尺寸急剧上升。扩散模型作为生成式采样器展现出潜力,但其标准去噪分数匹配目标需要从目标分布中采样——这恰恰又回到了原始难题。一篇最新研究提出了"数据自由训练"方案,让扩散模型仅凭自身生成的样本即可完成训练,并在二维 φ⁴ 理论中取得了与 HMC 参考数据训练相当的性能。
核心矛盾:训练扩散模型为何需要"答案"?
扩散模型的学习过程依赖于去噪分数匹配(denoising score matching)。简单来说,模型需要学会从带噪构型中恢复原始构型,而这一过程要求训练数据本身来自目标分布。在格点场论中,目标分布正是我们想要采样的平衡态分布。这就形成了一个逻辑闭环:要训练采样器,先得会采样。
传统解决方案是用 HMC 生成参考数据集,再用这些数据训练扩散模型,最后用训练好的模型快速生成大量独立构型。这种方式虽然有效,但并没有真正绕开 HMC 的计算开销——只是把成本转移到了训练阶段。对于临界区域或大体积系统,HMC 的自相关时间可能极长,生成足够训练数据的代价依然高昂。
去噪分数匹配(Denoising Score Matching, DSM) 是扩散模型训练的核心目标函数。其基本思想是:先对真实数据施加不同强度的高斯噪声,再训练网络预测被添加噪声的梯度方向——这个梯度恰好正比于扰动后分布的分数函数。数学上,DSM 将难以直接计算的分数匹配损失转化为一个可操作的回归问题,而回归的目标值直接来自被噪声污染的真实数据点。因此,训练集必须由目标分布的样本构成,否则网络学到的是错误分布的分数。这一依赖性正是扩散模型应用于格点场论时的根本障碍:目标分布本身就是未知的平衡态分布,在 HMC 之外没有廉价采样手段。DSM 的这一结构也解释了为何早期工作必须先用 HMC 生成训练集,再训练扩散模型,形成"先采样、后加速"的两阶段流程。
混合蒙特卡洛(Hybrid Monte Carlo, HMC) 是格点场论中生成平衡态构型的标准算法。它利用哈密顿动力学演化场构型,并通过 Metropolis 接受-拒绝步骤保证采样正确性。HMC 的突出优点是能够利用作用量的梯度信息,因此在连续场论中比传统 Metropolis 算法效率高得多。然而,HMC 仍属于马尔可夫链蒙特卡洛方法,生成的相邻构型之间存在自相关:要获得一个统计独立的样本,必须间隔足够多的演化步。在临界点附近,自相关时间随系统体积发散(临界慢化),使得 HMC 的采样成本急剧上升。这种"自相关瓶颈"正是扩散模型等生成式方法试图突破的靶点,也是数据自由训练方案价值最大的应用场景。
目标分数恒等式:用未归一化密度替代训练数据
该研究的切入点是一个被称为"目标分数恒等式"(target score identity)的数学关系。扩散模型需要学习的分数函数是概率密度对构型的梯度。关键洞察在于:如果能够获得未归一化的概率密度(在格点场论中,作用量已知,因此这一条件天然满足),就可以构造一个恒等式,将分数函数表示为当前模型预测与密度梯度之间的自洽关系。
这意味着模型不再需要外部数据来定义训练目标。每一轮训练中,模型从自身生成的样本出发,利用目标分数恒等式计算损失并更新参数。论文探索了两种实现路径:重要性加权版本在训练全程提供一致的目标,而无加权变体则定义了一个自洽的定点训练方案。两者各有优劣,前者理论上更稳定,后者实现更简洁。
分数函数(score function) 在生成模型中指概率密度对构型变量的对数梯度,即 ∇_x log p(x)。它不依赖于密度的归一化常数,因此只要知道未归一化的概率密度(在格点场论中即 exp(−S[φ]),其中 S 为欧几里得作用量),就原则上可以获得分数函数。扩散模型的反向生成过程正是通过学习这个分数函数,将噪声逐步还原为目标分布的样本。正因为分数函数对归一化常数不敏感,它天然适合格点场论——配分函数的计算本身就是一个难题,而分数函数绕开了它。目标分数恒等式进一步利用这一性质,将分数函数表示为模型预测与密度梯度之间的自洽关系,从而无需从目标分布中抽样即可构造训练目标。这一恒等式是数据自由训练能够成立的数学基础,其形式与统计物理中的力匹配、得分匹配等方法有内在联系。
重要性加权(importance weighting) 在机器学习中用于纠正训练分布与目标分布之间的偏差。在数据自由训练的重要性加权版本中,模型自身生成的样本来自一个与目标分布有偏差的分布,通过给每个样本赋予适当权重,可以使得加权后的损失函数在期望上等价于在目标分布上的损失,从而提供一致的目标。这种一致性的代价是权重可能具有较大方差,尤其是当模型生成的分布与目标分布差距较大时,权重会变得极端,导致训练不稳定。无加权变体则放弃一致性保证,转而定义自洽的定点条件:在最优解处,模型生成的分布与目标分布重合,损失函数自动取极小值,因此可以通过迭代更新逐步逼近定点。两种路径的取舍反映了生成模型训练中稳定性与简洁性的经典张力。
二维 φ⁴ 理论基准:对称、临界与破缺相的表现
研究团队在二维 φ⁴ 标量场论上进行了系统基准测试,覆盖了对称相、临界相和破缺相三种典型物理区域。这三个区域对采样器的挑战各不相同:对称相中场构型涨落较小,相对容易采样;临界相存在长程关联,自相关时间长,是传统方法的难点;破缺相则涉及真空选择和非微扰效应。
实验结果表明,经过适当设计的数据自由训练方案能够在所有三个区域实现高效训练和采样。更重要的是,其采样质量与使用 HMC 参考数据训练的扩散模型相当。这意味着在不需要任何先验采样数据的前提下,扩散模型已经能够胜任格点场论的采样任务。
数据自由训练的实际意义与局限
从方法论角度看,这项工作将扩散模型在科学计算中的角色从"加速器"推向了"自举器"。传统思路是用扩散模型替代 HMC 的采样步骤,但训练仍依赖 HMC 数据;新方案则完全切断了这一依赖,使扩散模型成为真正独立的采样工具。对于 HMC 难以高效处理的区域——如接近临界点的大体积系统——这一特性尤其有价值。
不过,当前验证仍局限于二维 φ⁴ 理论。向四维规范场论推广时,未归一化密度的获取虽然形式上可行(作用量已知),但分数函数的参数化复杂度、训练稳定性以及模式坍缩风险都可能显著增加。此外,重要性加权版本的计算开销和方差控制也是实际部署时需要权衡的因素。论文作者也指出,不同变体的选择需要根据具体物理区域进行调整,尚未形成通用配方。
对格点场论计算范式的潜在影响
如果数据自由训练能够在更高维度和更复杂的规范理论中保持有效性,它将改变格点场论的计算流程。研究人员不再需要为每个参数点单独运行昂贵的 HMC 来生成训练集,而是可以直接训练一个采样器,再用它生成物理观测所需的独立构型。这对于需要扫描大量参数空间的研究(如相图绘制、连续极限外推)可能带来显著的效率提升。
当然,从二维标量场到四维量子色动力学还有很长的路要走。但这项研究至少证明了一点:扩散模型不必依赖目标分布的样本就能学会采样目标分布——只要我们知道概率密度的函数形式。这一思路或许也能启发其他需要从已知未归一化密度中采样的科学计算问题。
相关推荐

ElevenLabs Realtime发布:570ms首音频的语音智能体模型
ElevenLabs发布Realtime语音智能体模型系列,v1 Mini和v1 Max首音频延迟分别为620ms和570ms,支持90+语言,兼容OpenAI Realtime API,端到端调优语音识别、轮次管理与语音生成。

Context Engine:为AI代理与人类团队打造统一记忆库
Context Engine在Product Hunt发布,为AI代理和人类团队提供统一记忆库。Claude、ChatGPT、Cursor等工具可自动保存上下文,团队成员可读取、提问和添加文件。本文分析其功能、集成方式与潜在挑战。

Monish:让AI Agent在iPhone锁屏上实时汇报与审批
Monish 是一款将 AI Agent 实时进度和审批请求推送到 iPhone 锁屏的工具,支持 Claude Code、Cursor、n8n 等,免费无需账户,让开发者随时批准或拒绝 Agent 操作。