无需验证器:测试时自博弈如何突破LLM推理瓶颈

TTSP用非对称自博弈实现无验证器的测试时扩展,弱验证器下优势更明显。
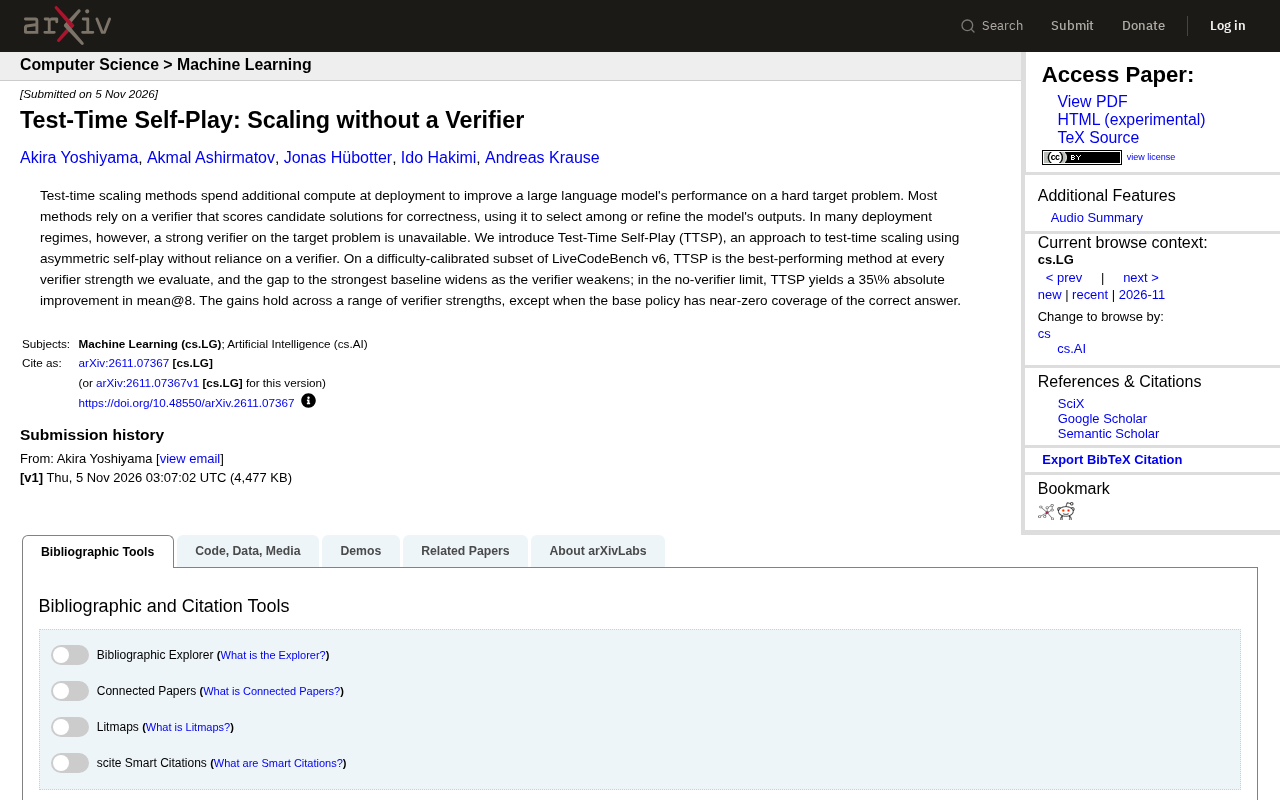
文章介绍了一种名为 Test-Time Self-Play(TTSP)的测试时扩展方法,旨在解决主流方法对验证器的强依赖问题。现有 Best-of-N 选优与自我精炼等范式都假设存在可靠的验证器,而在复杂代码生成、数学证明等领域验证器难以构建,导致这些方法收益骤降。TTSP 借鉴非对称自博弈思想,让同一模型分别扮演负责出题的提议者和负责解题的求解者,通过难度校准的内部对抗循环实现无需外部验证器的自我改进。在 LiveCodeBench v6 难度校准子集上的实验显示,TTSP 在所有验证器强度下均为最优,无验证器时平均@8 绝对提升 35%,且验证器越弱优势越明显。但该方法的前提是基础策略对正确答案具备一定覆盖能力,且目前仅在代码生成任务上验证。
测试时扩展(Test-Time Scaling)是提升大语言模型在困难任务上表现的重要手段,其核心思路是在部署阶段投入额外计算资源来优化输出。然而,主流方法普遍依赖一个验证器(Verifier)来评估候选答案的正确性,进而选择或精炼结果。但在许多实际场景中,针对目标问题的强验证器并不可用。近期一篇论文提出的 Test-Time Self-Play(TTSP) 方法,通过非对称自博弈绕过了这一限制,为无验证器下的测试时扩展提供了新思路。
验证器依赖:测试时扩展的隐形天花板
现有测试时扩展方法大致可分为两类:一类是采样多个候选解后由验证器打分选优(如Best-of-N),另一类是借助验证器提供细粒度反馈来迭代修正答案(如自我精炼)。这两种范式都假设存在一个可靠的验证器,能够对候选解的正确性做出准确判断。
问题在于,验证器的构建成本高昂,且在很多专业领域(如复杂代码生成、数学证明)中难以获得。当验证器信号微弱甚至完全缺失时,这些方法的收益会急剧下降。论文作者指出,在无验证器的极限情况下,依赖验证器的方法几乎失效。这构成了测试时扩展走向实用化的关键瓶颈。
Best-of-N 是测试时扩展中最基础的基线方法:对同一问题独立采样 N 个候选答案,再从中挑选一个作为最终输出。挑选方式可以是多数投票(多数表决,Majority Voting),也可以由验证器或奖励模型打分取最高者。当缺乏可靠验证器时,多数投票只能依赖答案之间的一致性,一旦问题较难、模型输出高度分散,投票信号就会失效,这正是 Best-of-N 在无验证器场景下收益迅速衰减的原因。
自我精炼(Self-Refine) 则让模型对自己已生成的答案进行批评并迭代修改。它通常需要模型自身或外部模型给出可操作的反馈信号,因此同样隐含了“存在一个能判断对错或至少能指出问题的评判者”这一假设。当模型对自身错误缺乏辨识能力时,自我精炼容易陷入错误累积或原地打转。
TTSP的核心机制:用自博弈替代外部评分
TTSP的设计灵感来自非对称自博弈(Asymmetric Self-Play)。其基本框架是让同一个模型扮演两个角色:提议者(Proposer) 和 求解者(Solver)。提议者负责生成具有挑战性的问题或子任务,求解者则尝试解决这些问题。两者在迭代中相互对抗、共同进化。
与传统自博弈不同,TTSP的非对称性体现在角色分工和难度控制上——提议者生成的问题会经过校准,确保难度适中,既能给求解者带来挑战,又不至于完全超出其能力范围。通过这种内部对抗循环,模型无需外部验证器即可实现自我改进。论文强调,该方法在测试时进行,不依赖额外的训练数据或人工标注。
非对称自博弈(Asymmetric Self-Play) 最早在强化学习与多智能体博弈研究中被系统化,其典型设定是让两个能力或信息不对称的智能体对抗:一方负责出题或设置目标,另一方负责达成目标,双方根据任务完成的难易程度获得各自的学习信号。与对称自博弈(如自我对弈棋类)不同,非对称设定让难度可以自动调节——提议者在求解者能力提升后自然需要出更难的题,从而形成一个自动课程(automatic curriculum)。TTSP 把这一思想搬到大语言模型的推理阶段,用大模型本身分别扮演提议者与求解者,从而在没有任何外部标注或奖励模型的情况下,构造出一个内生的、难度自适应的训练信号。
实验结果:验证器越弱,优势越明显
论文在LiveCodeBench v6的一个难度校准子集上评估了TTSP。结果显示,在所有测试的验证器强度下,TTSP都是表现最佳的方法。更关键的是,随着验证器强度减弱,TTSP与最强基线之间的差距反而扩大。在完全无验证器的设定下,TTSP实现了平均@8指标35%的绝对提升。
这一趋势符合方法设计的初衷:当验证器信号可靠时,传统方法尚能维持一定效果;一旦验证器缺失,TTSP的自博弈机制就成为主要驱动力。不过,论文也指出了方法的边界条件——当基础策略对正确答案的覆盖率接近零时,TTSP的增益不再成立。这意味着模型本身需要具备一定的潜在能力,自博弈才能有效激发。
LiveCodeBench 是一个面向竞赛级代码生成的评测基准,其特点是题目带有时间戳、可定期更新,以减少训练数据污染带来的虚高分数。v6 是该基准的一个版本。由于竞赛编程题往往有严格的测试用例或标准答案,它可以用于构造强度可控的验证器——例如用完整测试用例作为强验证器,用部分或噪声化的测试结果作为弱验证器,甚至完全不使用测试信号。论文正是在该基准上人为调节验证器强度,从而系统性地观察不同方法随验证器质量下降的表现,这也是其能得出“验证器越弱、TTSP 优势越大”这一结论的实验基础。
启示与局限:自博弈不是万能药
TTSP的价值在于拓宽了测试时扩展的适用场景,让缺乏验证器的领域也能享受额外计算带来的收益。对于代码生成、复杂推理等验证器构建困难的任務,这一方法提供了可落地的替代方案。同时,它也为“模型能否在无监督信号下自我提升”这一根本问题提供了实证支持。
但需要注意,TTSP并非万能。基础策略的初始覆盖能力是方法生效的前提,若模型对目标问题完全“无感”,自博弈循环也难以凭空创造正确解。此外,论文仅在代码生成基准上进行了验证,其在其他任务类型上的泛化能力仍有待进一步研究。未来工作或可探索如何与轻量级验证信号结合,以及在更多领域中的适配性。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。