无需语言预训练,Halcyon从零训练出强T2I模型

斯坦福提出Halcyon,无需语言预训练,从零训练T2I模型,算力更少效果更优。
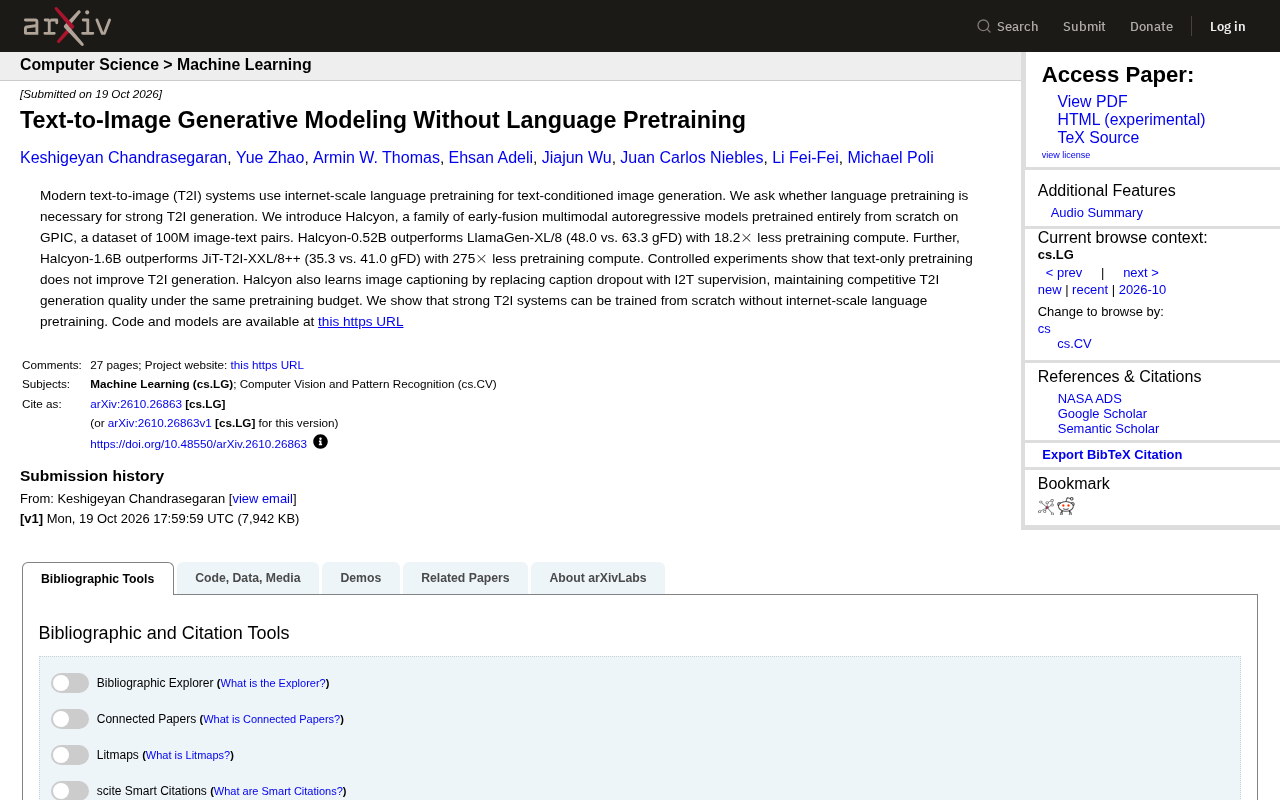
斯坦福大学的研究团队在论文《Text-to-Image Generative Modeling Without Language Pretraining》中提出Halcyon系列模型,证明语言预训练并非文生图(T2I)的必需品。Halcyon是早期融合的多模态自回归模型,完全从零开始在1亿图文对的GPIC数据集上预训练。在生成质量指标gFD上,Halcyon-0.52B以18.2倍更少算力超越LlamaGen-XL/8,Halcyon-1.6B以275倍更少算力优于JiT-T2I-XXL/8++。控制实验表明仅文本预训练不能提升T2I质量,而通过图像到文本监督替代caption dropout,模型还能同时学会图像描述并保持有竞争力的生成质量。该工作为摆脱对庞大语言模型的依赖、降低算力门槛提供了新路径。
引言:语言预训练是T2I的必需品吗?
现代文生图(T2I)系统几乎都依赖互联网规模的语言预训练来理解文本条件。但斯坦福大学的研究团队在论文《Text-to-Image Generative Modeling Without Language Pretraining》中提出了一个根本性问题:语言预训练对强大的T2I生成真的必要吗? 他们给出的答案是否定的——通过引入Halcyon系列模型,证明了从零开始训练也能达到甚至超越依赖语言预训练的基线。
自回归模型是一类通过逐步预测序列中下一个元素来生成数据的模型。在文生图任务中,自回归模型将图像编码为离散token序列,并与文本token统一建模,从而以“预测下一个token”的方式同时生成文本和图像。这种范式与扩散模型不同,后者通过迭代去噪生成图像。Halcyon采用自回归目标,意味着它直接最大化图文联合序列的似然,天然支持多模态融合。
Halcyon:早期融合的多模态自回归模型
Halcyon是一族早期融合(early-fusion)的多模态自回归模型,完全从零开始在GPIC数据集上预训练。GPIC包含1亿个图文对,规模远小于常见的互联网级语言语料。与主流方案不同,Halcyon不加载任何预训练的语言模型权重,而是将文本和图像token在早期阶段就进行融合,统一用自回归目标训练。
这种设计让模型从一开始就学习图文对齐,而非先学语言再适配图像。研究团队训练了不同规模的版本,包括Halcyon-0.52B和Halcyon-1.6B,以验证方法的可扩展性。
早期融合(early-fusion) 指在模型输入阶段就将不同模态(如文本和图像)的token映射到同一表示空间,并让它们在同一Transformer中交互。与之相对,晚期融合(late-fusion)通常先分别编码各模态,再在高层对齐。早期融合的优势在于,模型从第一层开始就能学习跨模态的细粒度关联,避免了模态间表示鸿沟。Halcyon完全从零训练,没有预训练语言模型作为文本编码器,因此早期融合成为其统一建模图文的关键设计。
性能突破:更少算力,更好效果
在生成质量指标gFD(生成Fréchet距离,越低越好)上,Halcyon的表现令人印象深刻:
- Halcyon-0.52B 取得48.0 gFD,优于LlamaGen-XL/8的63.3 gFD,而预训练算力仅为后者的1/18.2。
- Halcyon-1.6B 取得35.3 gFD,优于JiT-T2I-XXL/8++的41.0 gFD,预训练算力更是只有后者的1/275。
这意味着,无需语言预训练不仅可行,还能大幅降低计算成本。尤其1.6B版本在算力效率上的优势,对资源有限的研究团队和公司具有实际吸引力。
gFD(生成Fréchet距离) 是评估生成图像质量的常用指标,借鉴了FID(Fréchet Inception Distance)的思想。它计算生成图像分布与真实图像分布在特征空间中的Fréchet距离,数值越低表示生成分布与真实分布越接近,即图像质量越高、多样性越好。gFD通常使用预训练的特征提取器(如Inception网络)来嵌入图像,因此其绝对值受特征提取器影响,但同一实验设置下的相对比较具有意义。
控制实验:文本预训练并未带来增益
为了厘清语言预训练的作用,作者进行了控制实验。结果显示,仅文本预训练并不能提升T2I生成质量。这一发现挑战了“语言理解是文生图前提”的普遍假设。相反,早期融合的自回归目标本身就能让模型从图文对中学会足够的语义对齐。
此外,团队还探索了多任务学习:通过将caption dropout替换为图像到文本(I2T)监督,Halcyon同时学会了图像描述生成,并且在相同预训练预算下保持了有竞争力的T2I质量。这表明模型可以在不牺牲生成能力的前提下获得逆向任务能力。
Caption dropout 是一种在多模态训练中常用的正则化技术:在训练时以一定概率丢弃文本描述(caption),迫使模型仅根据图像或部分上下文进行生成,从而增强鲁棒性并防止对文本的过度依赖。Halcyon团队将其替换为图像到文本(I2T)监督,即显式训练模型根据图像生成描述。这种多任务学习方式不仅保留了生成能力,还让模型获得了逆向任务(图像描述)的能力,且不增加额外预训练预算。
启示与展望
Halcyon的工作为T2I生成开辟了一条新路径:摆脱对庞大语言模型的依赖,从零构建多模态系统。其意义不仅在于降低算力门槛,更在于启发我们重新思考多模态预训练的目标函数与数据效率。当然,当前实验局限于GPIC数据集和特定模型规模,未来需要验证在更大规模、更多样化数据上的泛化能力。但至少,Halcyon已经证明——语言预训练并非T2I的必需品。
代码和模型已公开在项目页面:https://cs.stanford.edu/~keshik/halcyon
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。