无遗憾生成:语言模型在线学习的新理论框架

论文提出无遗憾生成框架,证明语言生成可像在线学习一样从错误中持续改进,并给出速率谱系与遗憾界。
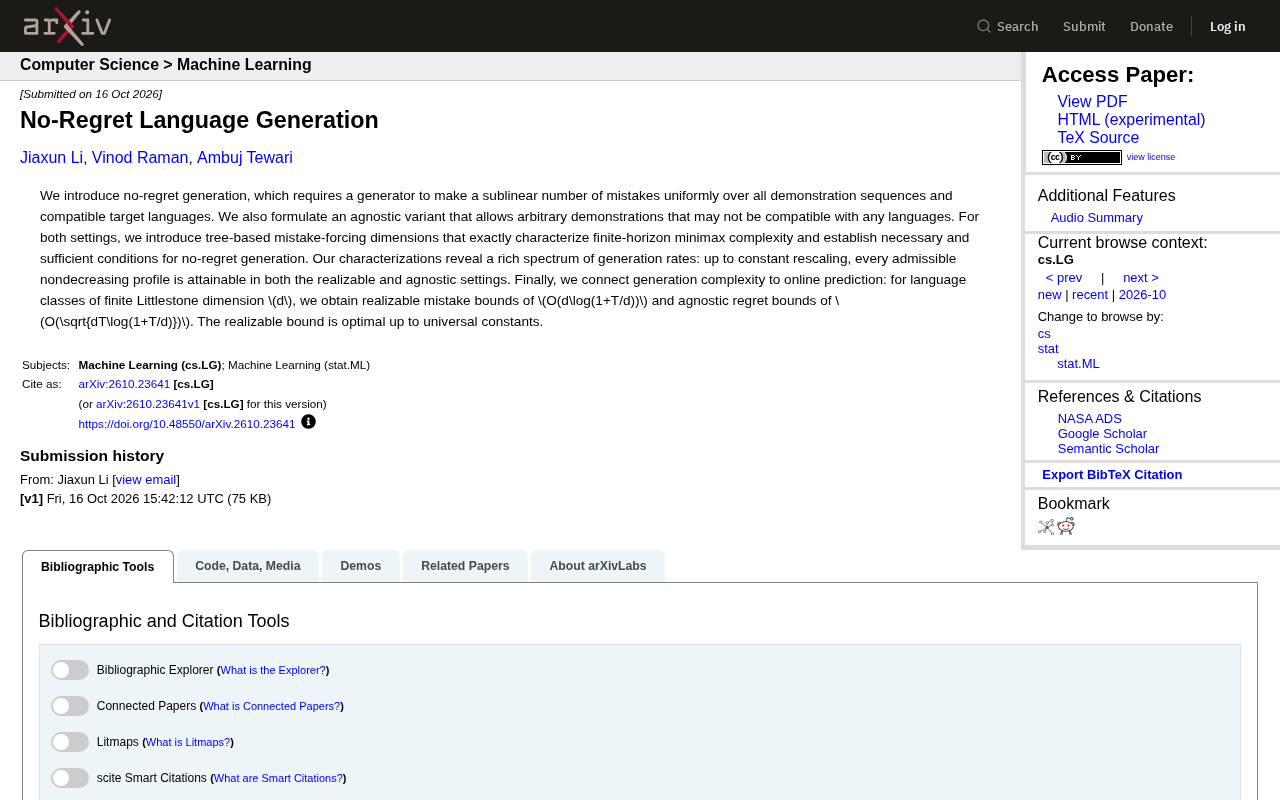
《No-Regret Language Generation》将语言生成建模为在线决策问题,生成器根据历史演示序列逐步输出,要求犯错次数次线性增长。论文区分可实现与不可知设定,引入基于树的强制错误维度刻画有限视野下的极小极大复杂度,并给出无遗憾生成的充要条件。理论分析揭示了一个完整的生成速率谱系:在常数缩放意义下,每一类非递减速率曲线都可在两种设定下达到。对于有限Littlestone维度的语言类,作者得到可实现错误界O(d log(1+T/d))和不可知遗憾界O(√(dT log(1+T/d))),前者在常数因子下最优。该工作将语言生成严格嵌入在线学习框架,为从错误中学习的生成范式提供了严谨的数学地基。
语言生成模型能否像在线学习算法一样,从错误中持续改进而不后悔?一篇题为《No-Regret Language Generation》的新论文提出了“无遗憾生成”(no-regret generation)的理论框架,试图为语言生成任务建立类似在线预测的遗憾界(regret bound)分析。这项工作将生成过程视为一个在线决策问题:生成器在每一步根据历史演示序列产生输出,并期望在有限步数内犯错的次数次线性增长。
核心设定:从演示序列中学习
论文定义了两种设定。在可实现(realizable)设定中,存在一个与所有演示序列兼容的目标语言集合,生成器需要在这个集合内产生正确输出。而在不可知(agnostic)设定中,演示序列可能不与任何语言兼容,生成器仍然需要保证遗憾次线性。这类似于在线学习中的可实现与不可知情形,但将预测对象从单个标签扩展到了语言序列。
作者引入“基于树的强制错误维度”(tree-based mistake-forcing dimensions)来精确刻画有限视野下的极小极大复杂度,并给出了无遗憾生成的充要条件。这个维度工具类似于Littlestone维度和覆盖数在在线学习中的作用,但针对的是语言生成这种结构化输出空间。
在线学习与遗憾界:在线学习是机器学习的一个分支,模型按时间步依次接收数据并做出预测,随后获得真实标签并产生损失。遗憾(regret)定义为模型累计损失与事后最优固定策略累计损失之差。若遗憾随步数T次线性增长(如O(√T)),则称算法“无遗憾”(no-regret),意味着平均损失渐近最优。这一框架广泛用于在线凸优化、专家建议和赌博机问题。
Littlestone维度:Littlestone维度是衡量二分类概念类在线学习复杂度的组合量,定义为能被该概念类“强制错误”的最大序列长度。若概念类能标记任意序列使得学习器每步都犯错,则该序列长度即为强制错误数。Littlestone维度有限当且仅当存在无遗憾在线学习算法,其错误界为O(d log T)。它类似于VC维在批学习中的地位,但直接刻画在线错误上界。
生成速率谱系:几乎所有速率都可实现
理论分析揭示了一个丰富的生成速率谱系:在常数缩放意义下,每一类可容许的非递减速率曲线都可以在可实现和不可知两种设定下达到。这意味着理论框架并不局限于某个特定收敛速率,而是给出了一个完整的可达速率collect。
这种“速率谱系”的结果在在线学习理论中并不常见,通常我们只关心最优速率本身。论文作者通过构造性的方法证明了这一结论,表明生成任务的复杂度可以非常灵活地映射到速率空间上。
极小极大复杂度与速率谱系:极小极大复杂度指在最坏情况下(对手选择演示序列)和最好情况下(生成器选择策略)的最小可能遗憾,是衡量学习问题内在难度的标准。速率谱系则指所有可达的遗憾增长速率曲线集合。论文证明在常数缩放意义下,每一类非递减速率曲线都对应一个可实现生成器,这比仅给出最优速率更精细,揭示了复杂度与速率之间的灵活映射。
与在线预测的深刻联系
论文的另一个关键贡献是将生成复杂度与在线预测复杂度联系起来。对于有限Littlestone维度(d)的语言类,作者得到了可实现设定下的错误界:(O(d\log(1+T/d))),以及不可知设定下的遗憾界:(O(\sqrt{dT\log(1+T/d)}))。其中可实现界在常数因子意义下是最优的。
这组结果将语言生成问题严格地嵌入了在线学习框架之中。Littlestone维度是衡量概念类在线学习难度的经典量,而论文表明它同样适用于语言生成——只要语言类具有有限Littlestone维度,就能获得类似在线预测的保证。
为什么这项理论工作值得关注
当前语言模型主要依赖离线训练和极大似然估计,缺乏对“在线持续学习”行为的理论保障。无遗憾生成框架提供了一种分析视角:如果生成器在交互过程中犯错的速率是次线性的,则其在平均意义上逐渐收敛到正确行为。这个框架不要求模型事先知道目标语言,而是通过演示序列逐步适应。
当然,这项工作的结论目前停留在理论层面,距离实际大模型训练还有相当距离。语言类的Littlestone维度如何计算、演示序列的长度尺度如何选择,都是后续需要回答的问题。但作为生成理论的一种新语言,它至少为“从错误中学习”的生成范式提供了严谨的数学地基。
离线训练与在线持续学习:离线训练指模型在固定数据集上通过极大似然估计一次性学习,无法适应新数据;在线持续学习要求模型在交互中逐步更新,避免灾难性遗忘。无遗憾生成框架为在线学习行为提供理论保证:只要错误率次线性,平均性能就收敛到最优。这为语言模型从演示中持续改进提供了数学基础。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。