系外行星突破6000颗:从一无所知到宇宙大发现

已知系外行星突破6000颗,仅覆盖太阳邻域极小区域,标志批量科学时代到来。
人类已知系外行星数量突破6000颗,而1995年之前对太阳系外行星还一无所知。这一数字来自太阳周围极小区域的探测,并非银河系行星总数的缩影,银河系数千亿颗恒星意味着已确认样本只是零头。视频创作者提出“X行星一代”概念,将1995年后出生的人与系外行星发现时代绑定,使抽象天文数字与代际身份产生连接。科学上,样本扩大推动研究从单颗发现转向行星族群统计与出现率分析;目标导向的观测策略调整是领域快速发展的关键驱动力。6000作为一个易记锚点,标志着系外行星研究进入批量科学阶段。
天文学界悄悄跨过了一个里程碑:我们已知的系外行星数量突破了6000颗。这个数字的背后,是人类从1995年之前的“一无所知”到如今“ catalog 膨胀”的认知跃迁。一位科普创作者在视频中调侃道:“告诉所有1995年以后出生的人,宣称他们是X行星一代(Generation X-oplanet)。”
从0到6000:一场仅持续三十年的宇宙狩猎
直到1995年,人类所知的全部行星,都只存在于太阳系这个“自家后院”里。当时寻找系外行星还只是一个假设:如果太阳有八颗行星,其他恒星理应也拥有自己的行星系统。问题在于,此前没有任何观测证据。
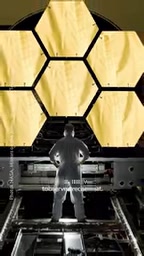
据该视频讲述,科学家们据此调整了实验和观测方向,专门瞄准这一目标。“狩猎开始了。”(But the hunt was on.)这句话概括了随后三十年的努力——从间接探测到直接成像,从地面望远镜到太空卫星,系外行星目录逐步膨胀,最终突破了6000颗的门槛。
径向速度法与凌星法:系外行星本身几乎不发光,直接拍摄极为困难,因此早期探测主要依赖间接方法。径向速度法通过测量恒星光谱的周期性多普勒频移,推断其被行星引力拖拽产生的微小摆动;1995年发现的首颗围绕主序星的系外行星飞马座51b,正是用此法确认。凌星法则监测恒星亮度的周期性微降,判断行星从恒星前方经过。开普勒太空望远镜凭借凌星法一次性批量发现数千颗候选体,使样本量从“个位数”跃升至“千位数”。这两种方法各有偏向:径向速度法更易发现大质量、短周期行星,凌星法则对轨道倾角有严格要求,二者结合才能较完整地刻画行星族群。
6000颗只是冰山一角:太阳附近的一小片区域
更值得玩味的是这6000颗的分布范围。视频中特别提醒:这仅仅是太阳周围“一个极小的区域”内的系外行星。(And by the way, that's only exoplanets in a tiny little zone around the Sun as we continued to explore the universe.)
换言之,6000颗并不是银河系行星总数的缩影,而是我们在宇宙探索中刚刚迈出的一小步。银河系拥有数千亿颗恒星,按照目前的探测效率,已确认的系外行星数量仅仅是可探测样本的零头。这个视角的转换,比数字本身更有冲击力——它暗示着宇宙中行星的丰度远超我们的想象,而人类的搜寻才刚刚开始。
探测偏差与“可探测样本”:已确认的6000颗并非银河系行星的真实随机抽样,而是受观测选择效应强烈塑造的“可探测样本”。目前主流方法对近距离、大质量、短周期行星最敏感,对类地行星、长周期行星和远距离系统则力有不逮。因此,6000这个数字更应理解为“在当前技术条件下、在太阳邻域内被成功确认的行星数量”,而非行星丰度的无偏估计。天文学家正通过更长的观测基线、更高精度的测光以及下一代太空望远镜,逐步填补冷行星、小质量行星和宽轨道系统的空白,这也解释了为何说“冰山一角”在统计意义上同样成立。
“X行星一代”:一个有趣的社会文化标签
视频创作者提出了一个略带玩笑却引人共鸣的说法:所有1995年以后出生的人,都可以自称“X行星一代”(Generation X-oplanet)。这个标签的巧妙之处在于,它把科学发现的时间线与代际身份绑定在一起。
1995年之前,人类在行星认知上是“空白”的;1995年之后出生的人,则成长在一个系外行星不断被发现、天文学教科书不断被改写的时代。据该视频观点,这种代际差异本身就是一个值得传播的科普话题。它让抽象的天文数字与个人身份产生连接,也让公众更容易记住这个里程碑。
为什么6000这个数字值得关注
系外行星数量突破6000,在科学上意味着什么?从统计角度看,样本量的扩大让天文学家能够从“发现单颗行星”转向“研究行星族群分布”——比如热木星、超级地球、迷你海王星等类型的比例,以及恒星类型与行星出现率之间的关系。
从公众传播角度看,6000是一个易于记忆的锚点,比“数千颗”更有冲击力。它也标志着系外行星研究从“稀有事件”进入“批量科学”阶段。视频创作者同时推广了自己的新书《Lost in Space》,说明这类数据节点在科普传播中具备天然的话题价值。
据视频内容,这一发现过程的核心驱动力是人类主动调整观测策略——“我们调整了实验和观测,专门去观测这一点。”(So we tuned experiments and observations to observe precisely that.)这种目标导向的科研方法,本身就是系外行星领域快速发展的关键。
行星族群统计与出现率:当样本量足够大时,天文学家不再只关心“又发现了一颗”,而是研究不同行星类型的比例分布——热木星、超级地球、迷你海王星、类地行星各占多少,以及这些比例如何随恒星质量、金属丰度和轨道周期变化。这类研究被称为行星出现率(occurrence rate)分析,它依赖对探测偏差的精确建模与校正。6000颗的规模使统计误差显著收窄,也让模型比较成为可能,例如检验行星形成理论中“核心吸积”与“盘不稳定”两种路径的预测。正因如此,数量里程碑才从“收藏式发现”转化为“批量科学”的转折点。
结语:数字之外的想象空间
6000颗系外行星是一个阶段性数字,但它真正的意义在于提示我们:太阳附近的一小片区域就已如此丰富,整个银河系的行星数量将是一个天文级的天文数字。对于1995年后出生的一代人来说,他们恰好站在人类认知爆炸的起点上——这也正是“X行星一代”这个称呼的趣味所在。
相关推荐
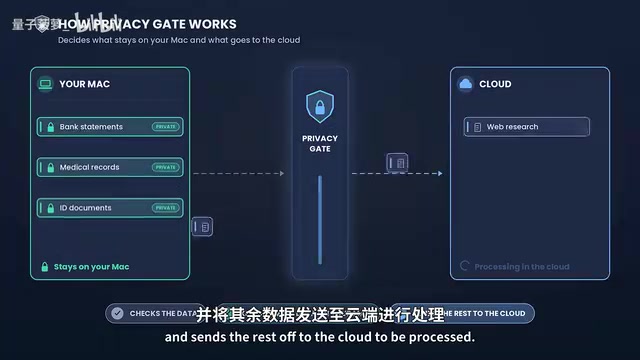
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
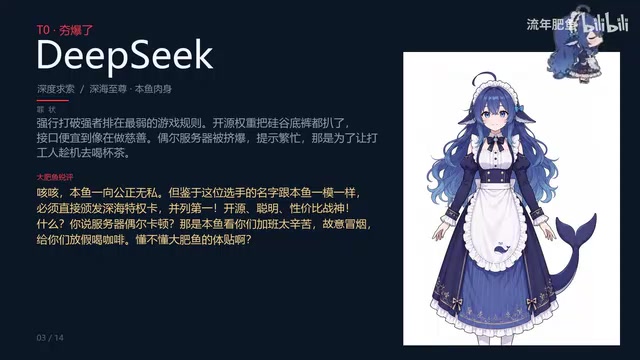
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。