显存究竟如何决定模型能否运行?VRAM容量详解

显存容量是本地大模型运行的第一道硬门槛,需区分专用VRAM与统一内存并预留运行时开销。
文章指出显存容量是本地运行大模型的首要硬约束,模型必须整体装入可用显存才能获得可接受速度,否则因权重交换导致推理极慢。不同设备显存含义不同:Windows 看独显专用 VRAM,Mac 与 DGX Spark 等 Linux 设备看统一内存。容量之外还需为激活值、KV 缓存、上下文窗口预留空间,仅看模型文件大小不可靠,建议留 10%-20% 余量。显存不足时可降低量化精度、缩短上下文或 CPU 卸载,但均牺牲速度或效果。最终强调显存决定能否跑起来,带宽与算力决定跑多快。
显存容量:模型能否落地的第一道门槛
很多人在部署本地大模型时,最先遇到的拦路虎不是算力,而是显存够不够。一个直观的规则是:模型必须整体装进可用显存,才能获得可接受的运行速度。举个例子,一张 16GB 显存的显卡,无法完整容纳一个 17GB 的模型——它要么放得下,要么放不下,没有中间地带。
当然,你依然可以强行启动这类模型,但一旦模型无法完全驻留显存,推理速度会慢到几乎无法使用。这是因为部分权重会被迫放在更慢的系统内存中交换,每一轮计算都要等待数据搬运。换句话说,显存容量直接决定了你能运行哪些模型,以及这些模型是否具备实用价值。
不同设备,显存的含义并不相同
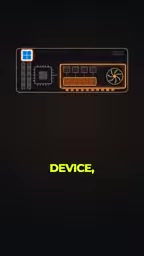
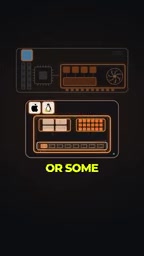
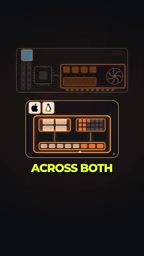
谈论显存时,设备形态不同,所指的硬件也完全不同。在 Windows 设备上,我们通常指的是独立显卡上的专用 VRAM——这部分内存只为 GPU 服务,容量固定、带宽高。而在 Mac 设备上,情况则变为统一内存(Unified Memory),系统内存与 GPU 共享同一块物理内存池。
Linux 设备也存在类似设计,例如 DGX Spark 这类产品同样采用统一内存架构。统一内存的好处是 GPU 可以调用更大的内存空间,缓解容量焦虑;但它的带宽和延迟表现与专用显存并不一样,实际推理效率需要结合具体硬件评估。理解这一点,才能避免用“显存大小”简单类比不同平台的能力。
统一内存架构(Unified Memory Architecture, UMA) 指 CPU 与 GPU 共享同一物理内存池的设计,苹果 M 系列芯片与 NVIDIA DGX Spark 均采用此方案。其优势在于 GPU 可直接访问大容量内存,无需在系统内存与显存间拷贝数据,缓解了容量瓶颈;但共享内存的带宽通常低于高端独立显卡的 GDDR6X/HBM 显存,且 CPU 与 GPU 争用同一总线时会进一步降低有效带宽。因此,统一内存设备在“能装下”层面占优,但在“跑得快”层面需结合具体带宽评估。
KV 缓存(Key-Value Cache) 是 Transformer 推理中为加速自回归生成而缓存的历史注意力键值对。其占用随上下文长度线性增长,且与批处理大小成正比。例如,7B 模型在 4K 上下文下 KV 缓存可能占用数 GB 显存,长上下文场景下甚至超过模型权重本身。这就是“刚好装下”不可靠的核心原因之一。
容量之外:为什么“刚好装下”还不够
即便模型大小与显存容量看似匹配,实际运行仍可能出问题。模型权重只是显存占用的一部分,推理过程中还需要为激活值、KV 缓存、上下文窗口等预留空间。上下文越长、批处理越大,额外开销就越显著。因此,一个 16GB 显卡跑 15GB 的模型,往往会在长上下文场景下捉襟见肘。
这也解释了一个常见误区:只看模型文件大小来判断能否运行并不可靠。更稳妥的做法是留出 10% 到 20% 的余量,并根据实际任务(对话长度、并发数)动态评估。对于统一内存设备,虽然可用池更大,但系统本身也要占用一部分内存,同样不能把标称容量全部算作可用显存。
量化精度 指模型权重存储时使用的数值格式,常见有 FP16(16 位浮点)、INT8、INT4 等。降低精度可显著减少显存占用:FP16 下每参数占 2 字节,INT4 下仅占 0.5 字节。但量化会引入精度损失,可能影响模型输出质量,且极端量化(如 2-bit)可能导致模型退化。实践中需在容量与效果间权衡。
CPU 卸载(CPU Offloading) 是一种将部分模型层或权重放置于系统内存、仅在需要时调入 GPU 的技术。它能让显存不足的设备运行更大模型,但每次前向传播都需通过 PCIe 总线搬运数据,带宽远低于显存,导致推理速度大幅下降。因此,卸载仅作为应急手段,无法替代足够显存带来的流畅体验。
实用建议:如何根据显存选模型
选购硬件或规划部署时,可以遵循几条简单原则。第一,明确目标模型参数量与量化精度,粗略估算权重占用;第二,为运行时开销留出余量,尤其是需要长上下文的应用;第三,区分设备类型,Windows 独显看专用 VRAM,Mac 与部分 Linux 设备看统一内存的实际可用额度。
如果模型实在放不下,也有一些折中手段:降低量化精度、缩短上下文、使用 CPU 卸载等。但这些方案都会牺牲速度或效果,无法从根本上突破容量限制。归根结底,显存容量是一道硬约束,它决定了模型能否“跑起来”,而带宽与算力则决定它“跑得多快”。
结语
VRAM 容量是本地运行大模型时最需要优先关注的指标。它不像算力那样可以通过优化逐步榨取,而是一道非此即彼的门槛。理解专用显存与统一内存的区别,并为运行时开销预留空间,才能让模型部署少走弯路。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。