先理解再探索:AI编程代理任务范围界定指南

ScopeCairn 用三步循环让 AI 编程代理先定位再动手,避免盲目探索烧 token、改错范围。
文章指出 AI 编程代理失败的根源不是模型不够聪明,而是"看不见"——读错文件、改错范围、在盲目探索中烧掉大量 token。开源工具 ScopeCairn 围绕"先理解再探索、先检索再阅读"提出一套三步循环:第一步用 context 命令把任务描述映射为结构化的文件与符号地图(含分级、依赖、受保护标记);第二步用 impact 检查共享代码的调用方、间接影响与风险等级,并以 fan-in ≥ 10 为硬性暂停阈值;第三步用 read symbol 只读约 40 行符号摘录而非整个文件。改动后必须 scan 重建索引。整套工具本地优先、不用 embedding、不联网、无 telemetry,适合隐私敏感的企业代码库。
AI编程代理(Claude Code、Cursor、Copilot、OpenCode)的失败往往不是因为模型不够聪明,而是因为它们"看不见"——不知道该读什么、该改什么。它们读整个文件而不是正确的符号,改动10个文件而实际上2个就够,误触迁移脚本、lockfile或.env,在从零开始的探索中烧掉数千token。
核心解法是一个习惯:先理解再探索,先检索再阅读。
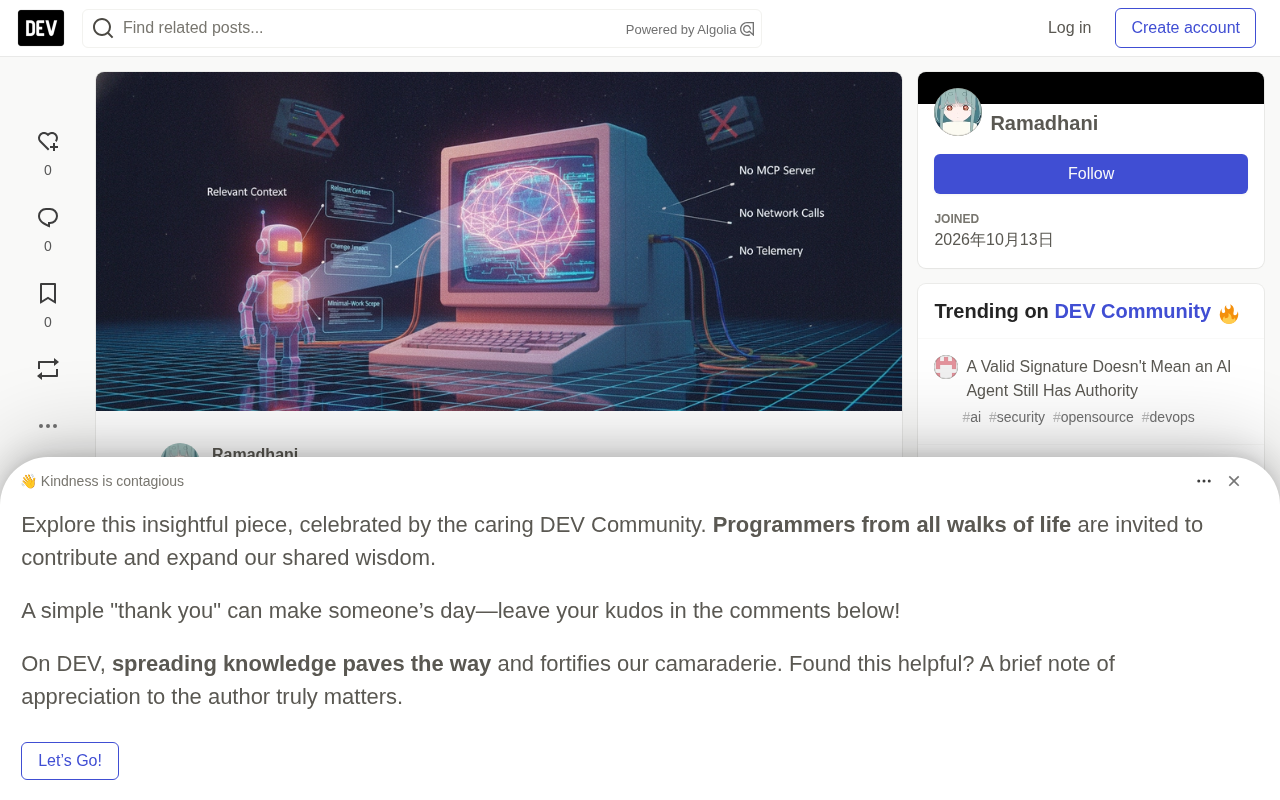
开源工具ScopeCairn围绕这个理念设计了一套三步循环,把"盲目探索"变成"精准定位"。
三步循环:从任务描述到精准修改
第一步:先获取任务上下文
scopecairn context "add login rate limiting"
这条命令返回的不是文件列表,而是一份结构化地图:
- 相关文件(按HIGH / MEDIUM分级)
- 关键符号,附带评分和入选理由
- 依赖关系、相关测试、循环引用警告
- Scope分级(必需 / 可选 / 受保护)+ Task Guard
使用方法是直接从"必需"+"可选"开始,永远不要从零探索。
对于解释、总结、审计类任务(不涉及代码修改),可以切换到知识模式:
scopecairn context --knowledge "how does auth work?"
这个模式不输出Scope和Guard这类编码规则,只给出摘要、原因和使用方式,适合快速理解代码库而非动手改。
第二步:改动共享代码前先查影响面
scopecairn impact src/auth/login.ts
scopecairn impact approveRequest
输出包含四个维度:直接调用方、间接影响(2跳)、受影响的测试、风险等级(HIGH/MED/LOW)。
这里有一条硬性规则:如果fan-in(被调用次数)≥ 10,或者符号被标记为"受保护",就停下来,找人类确认。这一步能有效防止AI代理在不知情的情况下改坏被广泛依赖的接口。
fan-in 是软件度量中的核心概念,指一个函数、类或模块被其他代码调用的总次数(也叫入度)。与它对应的是 fan-out(出度),即该模块自身调用了多少个外部模块。fan-in 越高,说明该符号处于依赖网络的关键枢纽位置,一旦其签名或行为发生变化,波及面会成倍放大。这正是 ScopeCairn 把 fan-in ≥ 10 设为硬性阈值的原因:在中等规模代码库中,被十个以上位置调用的符号通常已是公共 API 或基础设施层,改动它需要架构级别的审慎。除 fan-in 外,还需关注 fan-in 的传递性——即使直接调用方只有两个,若这两个调用方本身是高 fan-in 符号,间接影响同样巨大,这也是 impact 命令额外计算"2 跳间接影响"的意义。
第三步:读符号,不读文件
scopecairn read symbol approveRequest
返回的是40行摘录(含docstring),而不是2000行的完整文件。对需要串联进流水线的场景,加上--json即可让三个阶段都输出结构化数据:
scopecairn context "add login" --json
scopecairn impact src/auth/login.ts --json
scopecairn read symbol approveRequest --json
符号(symbol) 是指代码中具名的、可被独立引用的实体,包括函数、方法、类、接口、常量、类型别名等。对符号的精确读取之所以可能,依赖的是编译或索引阶段生成的符号表(symbol table)——一种记录每个符号名称、类型、作用域、定义位置和引用位置的元数据结构,现代 IDE 的"跳转到定义"和"查找所有引用"正是基于它实现。与文本搜索(grep)不同,符号表理解语言的语法结构,因此能区分同名的局部变量、方法重载和不同命名空间下的同名实体。ScopeCairn 的 read symbol 和 impact 命令本质上就是在消费这样一份预建索引。这也解释了为何编辑后必须执行 scan:源码变更会使符号表中的位置和引用关系失效,只有重建索引,后续查询才建立在真实状态之上。
实战示例:修复退款重复扣费
一个完整的排查流程展示了这套方法论的实际使用:
**调用路径(call path)** 指的是从一个函数出发,沿着调用关系到达另一个函数所经过的完整链条,例如 handleRefund → validateRefund → refundCharge。path 命令的作用不是罗列所有调用者,而是返回两点之间**最短的调用链**,帮助开发者在多个可能入口中识别哪条才是真正触发问题的路径。这对排查 bug 尤其关键:一个函数可能被十几处调用,但只有其中一条路径的上下文会触发重复扣费。相比 impact 给出的"谁调用了我"的广度视图,path 提供的是"从 A 到 B 究竟怎么走"的深度视图,两者互补。配合 history 命令检索带 diff 的历史相似改动,就形成了一套从定位、追踪到复盘的完整闭环。
# 1. 界定范围
scopecairn context "fix refund double-charge"

# 2. 查看可疑函数的影响面
scopecairn impact refundCharge

# 3. 找到最短调用链
scopecairn path handleRefund refundCharge --json

# 4. 查找历史相似修改
scopecairn history "refund double-charge" --with-diff

# 5. 修改后重建索引
scopecairn scan
注意第4步——查找历史analog并附带diff,这是把"这次怎么改"和"上次怎么改的"联系起来,避免重复踩坑。改动完成后必须执行scan重建索引,否则下一次context查询会基于过时数据。
五条检查清单
这套纪律的核心可以浓缩成一份操作清单:
- 在
grep或读全文件之前,先跑context - 只修改"必需"/"可选"范围内的文件
- 对共享符号执行
impact - 用
read symbol代替读整个文件 - 编辑后执行
scan
据项目作者介绍,ScopeCairn的其他功能(PageRank热点分析、循环检测、社区发现、GRAPH.md生成)都是为了让这5条命令更精准、更本地化而存在——不使用embedding、不联网、不上报telemetry。
为什么这比通用AI代理更有效
通用AI编程代理的默认行为是"探索式阅读":拿到任务后从入口文件开始,逐层扫描,试图自己拼出全貌。这个过程在小型项目中问题不大,但在中大型代码库里会产生两个后果:token消耗急剧膨胀,以及修改范围失控。
ScopeCairn的思路是把"理解"这个动作前置并结构化。context命令本质上是让工具先做一次静态分析,把任务描述映射到具体的符号和文件上,再让AI代理带着目标去读。impact和read symbol则进一步约束了"改什么"和"读多少"。
本地优先、零网络的设计也意味着它适合在隐私敏感的企业代码库中使用。安装方式很简单:
npm install -g scopecairn
scopecairn context "your task here"
需要Node ≥ 20。项目地址:https://github.com/DhaniAAA/ScopeCairn
embedding 是当前多数 AI 代码助手用于语义检索的核心技术:它把代码片段和自然语言查询分别映射为高维向量,再通过余弦相似度找出"语义相近"的代码。这种方式灵活,但存在三个代价:需要额外模型推理、结果不可解释(无法说明为何某个文件被选中)、以及通常要联网或上传代码。ScopeCairn 明确选择不用 embedding,转而依靠静态分析和图算法(如 PageRank 热度排序、循环检测、社区发现),好处是结果可复现、可解释、完全本地运行且零 telemetry 上报。这对金融、医疗等受合规约束、代码不得外传的企业场景是决定性优势,代价则是对自然语言查询的理解略逊于语义检索。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。