显卡涨疯了怎么办?统一内存+独显异构加速部署大模型
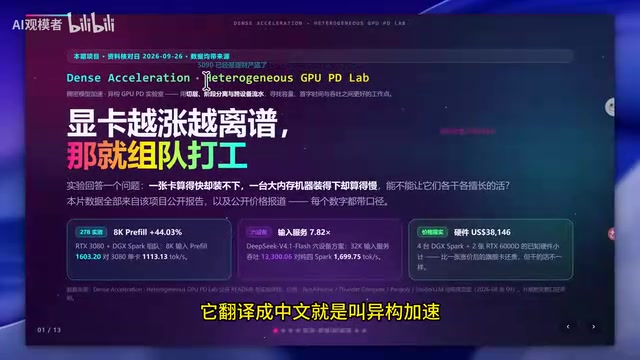
显卡价格暴涨背景下,异构加速方案通过将Prefill与Decode分配给不同硬件,把本地大模型部署成本压缩至传统方案的五分之一。
面对RTX 5090和Pro 6000因GDDR显存短缺导致的价格失控,一位B站UP主介绍了一个开源异构加速方案:将大模型推理拆分为Prefill(并行矩阵运算,吃算力)和Decode(逐token生成,吃显存带宽)两个阶段,分别交给高算力独立显卡和大统一内存设备承担。围绕Qwen3 27B的三条协作路径实测显示,Prefill速度最高提升约44%,首字等待时间可压缩至原来的四分之一,代价是Decode速度受限于内存带宽。最亮眼的案例是四台DGX Spark加两张RTX 6000D的六设备方案,以约3.8万美元实现DeepSeek V4.1 Flash本地部署,相比传统H20方案节省约80%成本。项目还附带算力租赁平台和多模型路由编程智能体Solmit,进一步降低普通用户的使用门槛。
高端显卡价格失控的当下,本地部署大模型的成本正在成为普通用户和小团队难以承受的门槛。一位B站UP主在硬件升级的过程中发现了一条新思路——把手头闲置的统一内存设备和独立显卡组合起来,通过异构加速的方式跑大模型。这个思路背后有一个正在快速演化的开源方向,值得深入拆解。
显卡价格失控,本地部署成本水涨船高
先看一组扎心的数字。RTX 5090英伟达发布时官方定价1999美元,国内落地价大约1.6万到1.7万人民币。而如今国际市场传出的价格已经飙到4525美元(9月13号数据),国内即便按这个价格也很难买到。
更疯狂的是被UP主称为“梦中情卡”的RTX Pro 6000。这张卡初期预定价不到8000美元,上市后涨到约8565美元,折合人民币5万多。当时不少测评博主对它嗤之以鼻,认为它性能与5090相当,只是多了三倍显存,价格翻好几倍不值。然而官方直接把价格翻倍到16000美元,亚马逊上普遍要价19999美元。
涨价的核心原因在于显存供应。媒体分析指出,厂商产能大量转向HBM显存,导致Pro 6000和5090所用的GDDR显存出现短缺,价格持续攀升。对普通用户而言,这两张卡都已经超出了合理的消费门槛。
在这种背景下,把手头所有能用的硬件“物尽其用”的异构加速方案,正在变得越来越有现实意义。
异构加速为什么成立:拆解大模型推理的两个阶段
要理解异构加速的原理,得先看清大模型推理其实只做两件事。
Prefill:读题阶段
Prefill是预加载阶段,可以理解为模型“读题”。比如你贴进来8K token的长文,模型需要一次性并行处理完,本质是大规模的矩阵运算。这个阶段吃的是算力,产物是一份KV状态,也就是我们常说的上下文记忆。UP主的比喻很形象:Prefill就像开卷考试前先把有答案的书快速扫一遍。
KV Cache(键值缓存)是理解Prefill产物的关键概念。Transformer架构在处理每个token时,会为其生成Key和Value两个向量,这对向量会被缓存下来供后续生成步骤复用。Prefill阶段的本质,就是一次性计算完所有输入token的KV对并写入缓存。缓存越大,模型能"记住"的上下文就越长。这也解释了为什么长上下文场景对显存需求极高——一个32K上下文的KV Cache,在70B规模模型上可能占用数GB显存,且随序列长度线性增长。
Decode:答题阶段
Prefill完成后进入Decode阶段,模型一个token一个token地往外“蹦字”,这就是聊天时逐字生成回答的过程。Decode是串行的,权重和KV需要常驻显存,因此它吃的是显存容量和显存带宽。类比就是扫完书之后一个字一个字往外写答案。
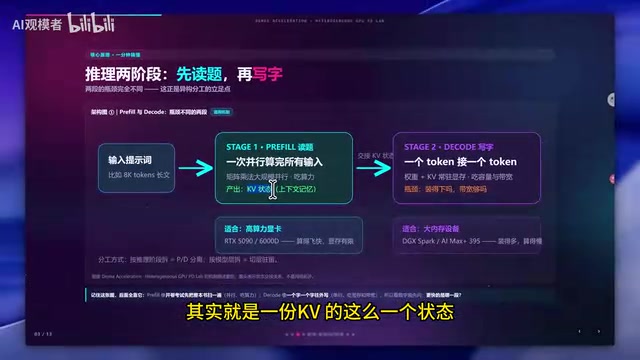
关键洞察在于:算力强的显卡适合做Prefill,内存大的机器(统一内存或大显存)适合做Decode。异构加速的立足点正是把这两类任务分给各自擅长的硬件——高算力GPU负责密集计算和长输入,大内存设备负责承载权重、上下文与token生成,实现“1+1大于2”。前提是Decode侧的内存带宽不能太慢,否则会成为瓶颈。
三条路径与六设备方案的实测数据
该开源项目围绕Qwen3 27B稠密模型给出了三条协作路径,同一个模型分成三种组合:
- 路径A(分层助流):RTX 3060跑前段层发挥GPU算力,AMD AI Max+ 395跑后段层。在IQ3量化、64K长输入下,Prefill速度从136.69 token/s提升到319.1 token/s,同时解决了单机装不下的问题。
- 路径B(阶段分离):RTX 3080做Prefill,AI Max 395做Decode。在Q4量化下,首字等待时间从4.825秒压缩到1.073秒,仅为原来的四分之一。
- 路径C(双设备协作):RTX 3080配合DGX Spark,Prefill速度从1111.3飙升到1600,提升约44%。但代价是Decode速度从33.36 token/s下滑到17.62,原因是DGX Spark的带宽不及独显显存。
这组数据清楚地展示了异构加速的取舍:它能显著改善Prefill和首字延迟,但Decode速度受限于内存带宽。
IQ3和Q4是两种不同的模型量化精度。量化是将模型权重从32位或16位浮点数压缩为更低位整数的技术,以显存占用换取精度损失。Q4表示4位量化,是目前本地部署最常用的平衡点;IQ3则是3位"重要性感知"量化(Importance-aware Quantization),在Q3基础上根据权重重要性动态分配精度,能在比Q4更低的显存占用下保持接近的模型质量。Qwen3 27B在IQ3量化下体积约为11-12GB,Q4约为15-16GB,这直接决定了在哪类设备上能装载完整模型权重。
4万美元跑DeepSeek V4.1 Flash,成本降到五分之一
项目最亮眼的案例是一套六设备混合加速方案:四台DGX Spark加两张RTX 6000D,实现DeepSeek广告 V4.1 Flash的本地部署。
成本方面,单台DGX Spark约4700美元,四台约1.87万美元;两张RTX 6000D约1.9万美元。合计3.8万美元,约27万人民币(尚未计入税费、散热、主机内存和存储)。
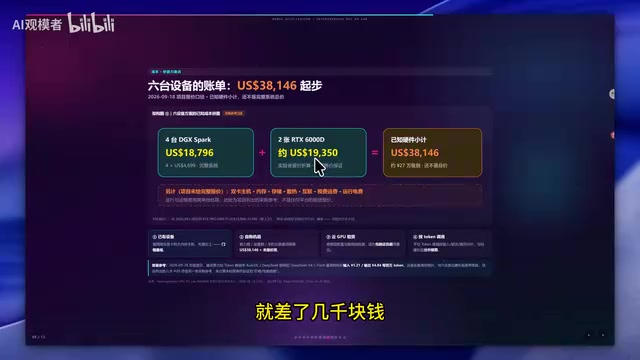
这个价格看似昂贵,但对比传统方案就显得划算。UP主指出,按DeepSeek V4.1 Flash的体量,若想达到同等部署质量,传统路线大约需要6张H20加至强处理器及配套设备,总价接近20万美元。异构加速方案把成本压到了约五分之一。
有意思的是,两张RTX 6000D的价格才勉强抵得上一张Pro 6000,但两张Pro 6000单独是无法落地跑出这种效果的——协作的价值恰恰体现在这里。
算力租赁与编程智能体:项目的延伸生态
考虑到DGX Spark(三万多)、AMD小主机(两三万)对普通用户仍是不小的门槛,项目作者还搭建了一个算力租赁平台,价格低于腾讯、阿里云广告等主流云平台。平台带有明显的二次元风格,用“灵魂肉身部署”等设定和AI管家来降低部署门槛。
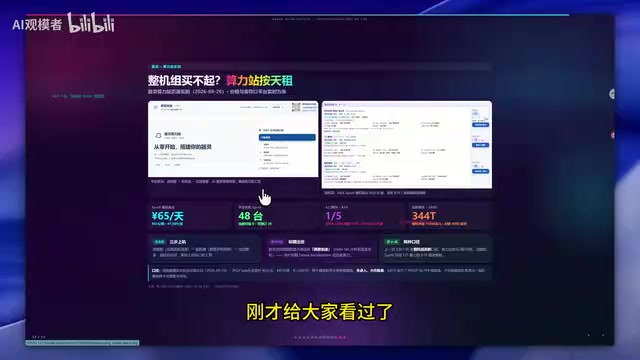
从平台的租赁定价可以侧面看出硬件热度:RTX 5090约77元/天,4090约51元/天,H20(NVLink)约250元/天,AMD Strix Halo小主机约50元/天。UP主自嘲租100天也就7700元,想靠出租回本Pro 6000几乎不现实。
作者还开发了一个名为Solmit的编程智能体,把多家agent CLI收进同一个工作台统一调度,类似“多智能体路由器”。它用Claude、GPT等强模型做“大脑”思考,用本地部署的Qwen3 27B等弱模型执行具体任务,既聪明又省钱。作者自测数据显示:5轮简单对话单轮节省85%,37轮日常对话节省86%,246轮大型项目节省92%(未经第三方认证)。这与此前日文社区出现的模型路由智能体思路一脉相承——通过智能路由聚合不同模型的强项,以低价逼近顶级模型性能。
Agent CLI(智能体命令行工具)是近年兴起的一类开发者工具,代表产品包括Anthropic的Claude Code、OpenAI的Codex CLI等。它们允许AI模型在终端环境中直接读写文件、执行命令、调用工具,从而自主完成多步骤的编程任务。Solmit所做的"多智能体路由",本质上是在这些工具之上加一层调度层:根据任务复杂度和成本,动态决定把哪段子任务发给昂贵的云端前沿模型,哪段发给本地部署的轻量模型。这种架构能大幅降低API费用,但也引入了路由判断本身的延迟与潜在错误。
异构加速会成为常态吗
显卡价格短期内看不到回落迹象,把闲置算力“压榨”出来的各种手段——无论是正规还是“邪修”——大概率会越来越多。UP主本人也在探索用英特尔CPU里被闲置的核显和NPU来加速MOE模型的Prefill,思路同样是让每一块硬件都别打酱油。
这类项目当前的落地门槛依然偏高,最贴近普通用户的仍是DGX Spark和AMD AI Max这类统一内存设备的组合。但异构加速揭示了一个重要方向:在硬件成本高企的时代,架构层面的巧妙分工,可能比盲目堆料更有性价比。对于想在本地跑大模型又预算有限的用户,密切关注这类开源方案是值得的。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。