先收敛后多样化:多目标贝叶斯优化的CTD新范式
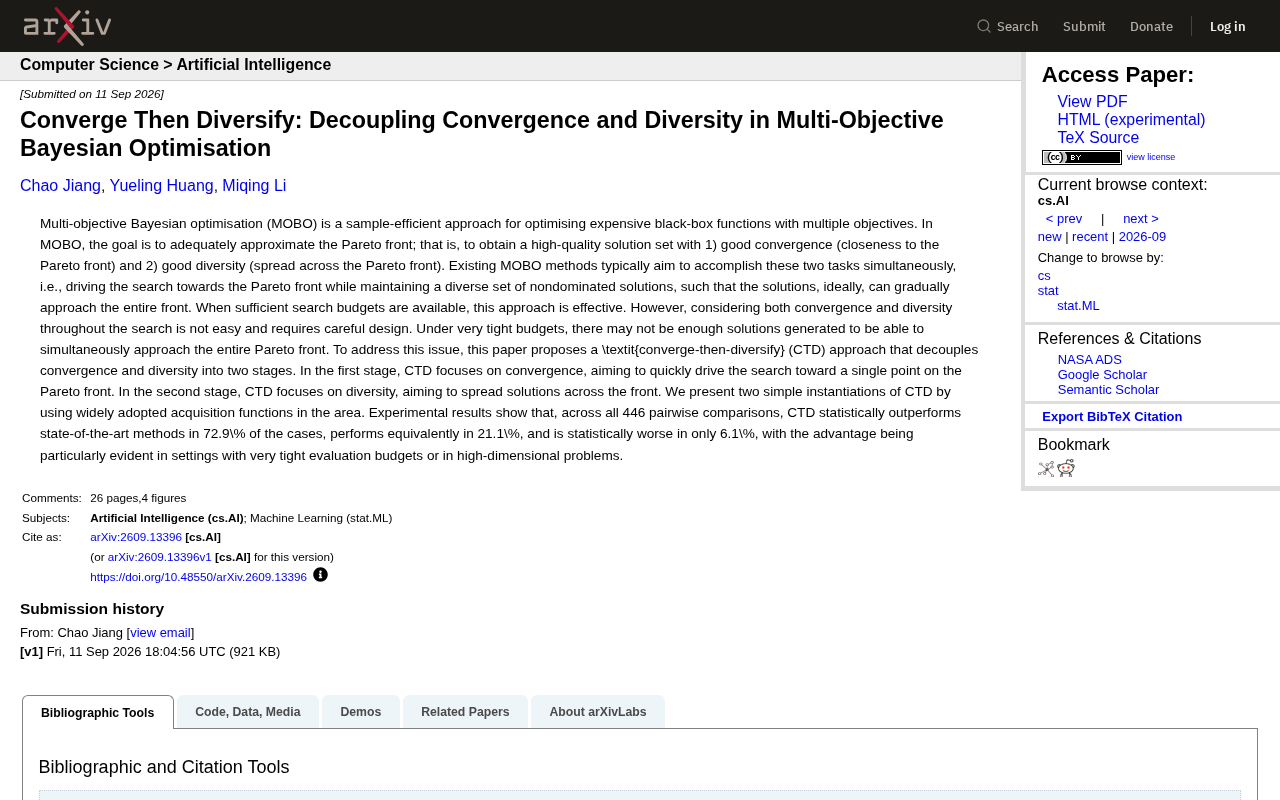
CTD将多目标贝叶斯优化拆为先收敛后多样化两阶段,在紧预算场景下大幅超越现有方法。
多目标贝叶斯优化(MOBO)在评估成本高昂的场景中广泛应用,但现有方法同时追求收敛性与多样性,在预算极度有限时往往顾此失彼。新提出的CTD(Converge-Then-Diversify)方法将优化过程解耦为两个阶段:第一阶段集中资源快速逼近帕累托前沿的某一单点,第二阶段再以此为锚点向两侧扩展多样性。CTD无需构建全新框架,可直接复用现有成熟采集函数,落地成本低。实验结果显示,在446次两两对比中,CTD在72.9%的情况下显著优于当前最优方法,仅在6.1%的情况下落败,优势在紧预算和高维问题中尤为突出,契合工业界高成本评估的实际需求。
多目标贝叶斯优化(MOBO)一直是处理昂贵黑箱函数优化的利器,尤其适用于那些每次评估都代价高昂的场景——超参数调优、材料设计、工程仿真等。但一项新的arXiv研究指出,主流MOBO方法在评估预算极度紧张时存在明显短板,并提出了一种名为"先收敛后多样化"(Converge-Then-Diversify,简称CTD)的解耦式新方法。
MOBO的核心矛盾:收敛与多样性的两难
在多目标优化中,目标不是找到单一最优解,而是逼近整个帕累托前沿(Pareto front)。一个高质量的解集需要同时满足两个条件:收敛性(solutions要尽可能贴近真实的帕累托前沿)和多样性(solutions要在前沿上分布得足够均匀、覆盖足够广)。
现有的MOBO方法几乎都试图"两手抓"——在把搜索推向帕累托前沿的同时,维持一组多样化的非支配解,期望这些解能够逐步、整体地逼近完整前沿。
这套逻辑在搜索预算充足时确实有效。但论文作者敏锐地指出了一个被长期忽视的问题:同时兼顾收敛与多样性并不容易,需要精巧的设计。而在预算极其有限时,系统可能根本生成不了足够多的解,去同时逼近整个前沿。 换句话说,当你只有寥寥几次评估机会时,强行铺开兵力反而会导致哪个方向都做不好。
CTD的思路:把两件事拆成两个阶段
CTD的核心创新在于"解耦"。它不再让收敛和多样性在整个搜索过程中相互纠缠,而是把它们拆分成两个前后衔接的独立阶段。
第一阶段:集中火力收敛
第一阶段只关注收敛性,目标非常明确——快速把搜索驱动到帕累托前沿上的某一个点。这里的关键词是"单点":不追求覆盖面,只求以最快速度触达前沿。这种聚焦策略在预算紧张时尤为高效,因为它把有限的评估资源全部投入到"先到达"这个最基础的目标上。
第二阶段:向两侧铺开多样性
一旦第一阶段成功抵达前沿,第二阶段才开始转向多样性,目标是让solutions沿着前沿铺展开来,形成覆盖广泛的解集。由于此时已经有了一个高质量的"锚点",后续的多样化搜索可以在此基础上稳步扩展,而不是从零开始在多个维度上摸索。
值得一提的是,CTD并非一个复杂的新框架,而是可以直接复用领域内广泛采用的采集函数(acquisition functions)。论文给出了两个简单的CTD实例化方案,都是基于现有成熟工具搭建的,这大大降低了落地门槛。
实验结果:446次对比中的压倒性优势
论文的实验部分给出了相当有说服力的数据。在总计446次两两对比(pairwise comparisons)中:
- CTD在 72.9% 的情况下统计显著优于当前最先进(state-of-the-art)方法
- 在 21.1% 的情况下表现相当
- 仅在 6.1% 的情况下统计显著劣于对手
这意味着CTD在近四分之三的对比中胜出,而失败的比例不到十五分之一。更重要的是优势出现的场景——论文明确指出,CTD的优势在评估预算极度紧张或高维问题中表现得尤为突出。这恰好印证了它的设计初衷:正是在资源受限、传统方法难以兼顾两个目标的情况下,解耦策略才真正发挥价值。
为什么这个思路值得关注
从方法论角度看,CTD挑战了MOBO领域一个默认的假设:收敛和多样性必须同步进行。这种"分而治之"的思想在优化领域并不新鲜,但将其系统地引入贝叶斯优化,并用严格的统计对比验证其在紧预算下的优越性,具有实际意义。
对于工业界而言,很多真实场景恰恰是"每次评估都很贵"——比如一次物理实验、一次大规模仿真、或一次昂贵的模型训练。在这些场景下,评估预算天然稀缺,CTD提供的"先确保到达,再考虑铺开"的策略更符合工程直觉,也更容易调优。
当然,作为一篇新发布的预印本,CTD仍有值得进一步观察的地方:两阶段之间的切换时机如何界定、单点收敛可能带来的初始偏差是否会影响最终多样性、以及在预算充足的常规场景下相较传统方法是否仍有边际收益。这些问题需要更多后续研究和实际应用来验证。但无论如何,CTD为多目标贝叶斯优化提供了一个简洁而有效的新视角。
相关推荐
Vercel AI SDK 发布 policy-opa 1.0.101 补丁更新
Vercel AI SDK 发布 @ai-sdk/policy-opa 1.0.101 补丁更新,同步依赖至 ai 7.0.101。本文解读该策略组件与 OPA 集成的作用及开发者升级建议。
Vercel AI SDK 更新:sandbox-just-bash 组件发布补丁版本
Vercel AI SDK 组件 @ai-sdk/sandbox-just-bash 发布 1.0.111 补丁版本,同步更新 harness 依赖。本文解读此次更新内容及其对开发者的意义。
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新
Vercel AI SDK 发布 @ai-sdk/react@4.0.104 补丁更新,主要同步升级底层依赖 ai@7.0.101。本文解析该版本更新内容、React 集成能力及开发者升级建议。