先算天花板:本地LLM加速的新思路

开源agent skill用“天花板优先、单变量、交错控制”三原则系统优化本地LLM速度。
文章介绍了一个名为hill-climbing的开源agent skill,用于系统化优化本地LLM服务速度,而非试错式盲调。其方法论包含三个环环相扣的原则:先估算当前硬件与软件配置下的理论性能天花板,把优化变成有边界的搜索;每次只改动一个变量,保证因果链条清晰、结果可复现;在测试序列中交错插入基线测量,用对照方式抵消硬件温度、系统负载等环境漂移带来的噪声。文章指出,该工具让agent承担实验设计与执行的角色,其方法论价值超出LLM加速场景,可迁移到任何多变量、有测量噪声的性能优化问题。实践建议是先建立稳定基线、再估算上限,调参过程中定期重测基线。
为什么本地LLM加速需要新方法
本地部署大语言模型时,性能优化往往是试错式的:改一个参数、跑一次测试、看结果有没有变快。这种"盲调"方式效率很低,因为不同参数之间存在耦合,单次调整的效果可能被其他因素的波动掩盖。一个名为"hill-climbing"的开源agent skill尝试用更系统的方法解决这个问题——它的核心思路不是直接调参,而是先算出理论上限。
据该项目的介绍,这个工具用于对本地LLM服务速度进行爬山式优化。虽然它本身是一个具体的开源项目,但作者明确指出:即使你从不安装它,它的方法论也值得借鉴。
核心方法论:天花板优先、单变量、交错控制
这个agent skill的方法可以拆成三个环环相扣的原则,构成了一个严谨的优化循环,而非零散的调参技巧。
先算天花板,再谈优化
传统调参的做法是"先跑起来,再一点点改"。这个skill反其道而行:先估算当前硬件和软件配置下能达到的理论性能上限。知道天花板在哪里,你才能判断距离还有多远——如果已经接近上限,再投入时间调参的收益就很低;如果差距很大,说明存在结构性问题,需要优先解决。这一步把优化从"无限试错"变成了"有边界的搜索"。
理论性能上限在本地LLM推理场景中,通常由几个硬性因素共同决定:GPU的显存带宽、算力(FLOPS)、CPU与GPU之间的数据传输带宽,以及模型本身的参数量和量化精度。对于内存带宽受限的解码阶段,理论上限大致可以用“显存带宽 ÷ 每token需读取的模型权重字节数”来粗略估算;对于计算密集的预填充阶段,则更多受限于算力。实际吞吐还会因内核实现效率、批处理策略、KV cache管理等打折。因此“天花板”不是精确值,而是一个数量级参考——它的意义在于告诉你当前性能离物理极限还有几倍差距,从而判断优化空间是在软件配置层面还是需要更换硬件。
一次只改一个变量
单变量原则听起来简单,执行起来却容易被忽视。很多优化指南会建议同时调整批处理大小、线程数和量化方式,结果性能可能提升也可能下降,而你无法归因。这个skill坚持每次只做一个改动,然后测量、比较、决定保留还是回滚。这样每一步的因果链条都是清晰的,优化过程本身就是一份可复现的记录。
控制变量法是实验科学的基石:在多个自变量同时影响因变量的系统中,只有保持其他变量恒定,才能将观测到的变化归因于单一因素。在LLM服务调优中,这一原则尤其重要,因为批处理大小、线程数、量化方式、KV cache策略等参数之间存在交互效应——例如增大批处理可能提高吞吐但增加延迟,而量化又会改变显存占用从而影响可用的批处理上限。同时改动多个参数,观测结果就是这些交互效应的混合,无法判断哪个改动真正有效。单变量原则的代价是实验次数增多,但换来的是每一步结论的可信度和可复现性。
交错控制排除干扰
单变量还不够。硬件温度、系统负载、缓存状态都会影响测量结果,导致"改了A变快"的结论可能是噪声。交错控制的思路是在测试序列中交替插入基线测量,用对照的方式抵消环境漂移的影响。这和科学实验中的对照组设计是同一个逻辑,只是被搬到了LLM服务的性能调优场景里。
交错控制(interleaved control)借鉴的是A/B测试中的对照思想。在性能测量中,环境漂移是常见噪声源:GPU因持续负载而升温降频、后台进程占用CPU、操作系统缓存状态变化,都会让同一配置在不同时间测得不同结果。如果先测基线、再测改动,两次测量之间的环境变化就会被误判为改动带来的效果。交错控制的做法是在测试序列中反复交替测量基线与改动版本(如A-B-A-B),用多次测量的对比来抵消随时间线性漂移的系统误差。这与医学试验中的随机对照试验逻辑一致,目的是把“信号”从“噪声”中分离出来。
这个agent skill为什么值得关注
从工具形态看,它把"优化"这件事本身交给了agent来执行:agent负责提出假设、执行改动、记录结果、决定下一步。人只需要设定目标(比如降低延迟或提高吞吐)。这和当前AI编程工具的发展方向一致——agent不再只是生成代码,而是开始承担实验设计和执行的角色。
从方法看,它的价值超出了LLM加速这个具体场景。任何涉及多变量、测量噪声和有限预算的性能优化问题,都可以套用"天花板优先、单变量、交错控制"的框架。作者"即使不安装也值得偷师"的说法,指向的正是这一点。
Agent skill是指面向AI agent的能力封装,通常以结构化指令或工具调用的形式提供,让agent在特定任务域内按既定流程执行操作。与传统的脚本或函数不同,agent skill强调让模型自主完成“提出假设—执行—观察—决策”的闭环,而非由人预先写死每一步。在本例中,这个skill把性能调优的实验设计流程封装起来,agent据此自主决定下一步改哪个参数、是否回滚、何时停止。这类skill的出现反映了AI编程工具从“代码生成”向“任务执行与实验管理”演进的趋势,其可靠性依赖于清晰的流程约束和可验证的中间结果。
实践者的行动建议
如果你正在优化本地LLM服务,可以从这个skill借鉴几件事。先花时间建立性能基线:在固定条件下多次测量,了解波动范围,否则后续所有对比都不可靠。然后估算上限:根据硬件规格和模型规模,推算理论上可能达到的速度,给自己的优化定一个终点。开始调参后,一次只动一个参数,并且每隔几步重测一次基线,确认环境没有漂移。
至于是否直接使用这个开源skill,取决于你的场景。它的方法论是通用的,工具实现则针对特定的服务配置。理解原理之后,用脚本或者现成的benchmark工具手工搭建一套类似的流程,也是可行的路径。
常见问题
这个skill支持哪些本地LLM框架? 原始素材未提及具体支持的框架和模型范围,需要查阅项目文档确认。
天花板估算的准确度如何? 素材没有提供估算方法的具体细节和误差数据,实际使用时应把它当作参考基准而非绝对真理。
普通用户需要它吗? 如果你只是日常使用本地模型、对速度没有极致要求,这套方法的收益有限。它更适合需要压榨硬件性能的部署场景。
相关推荐
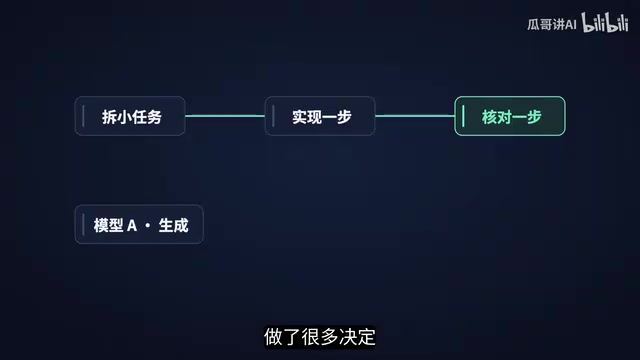
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
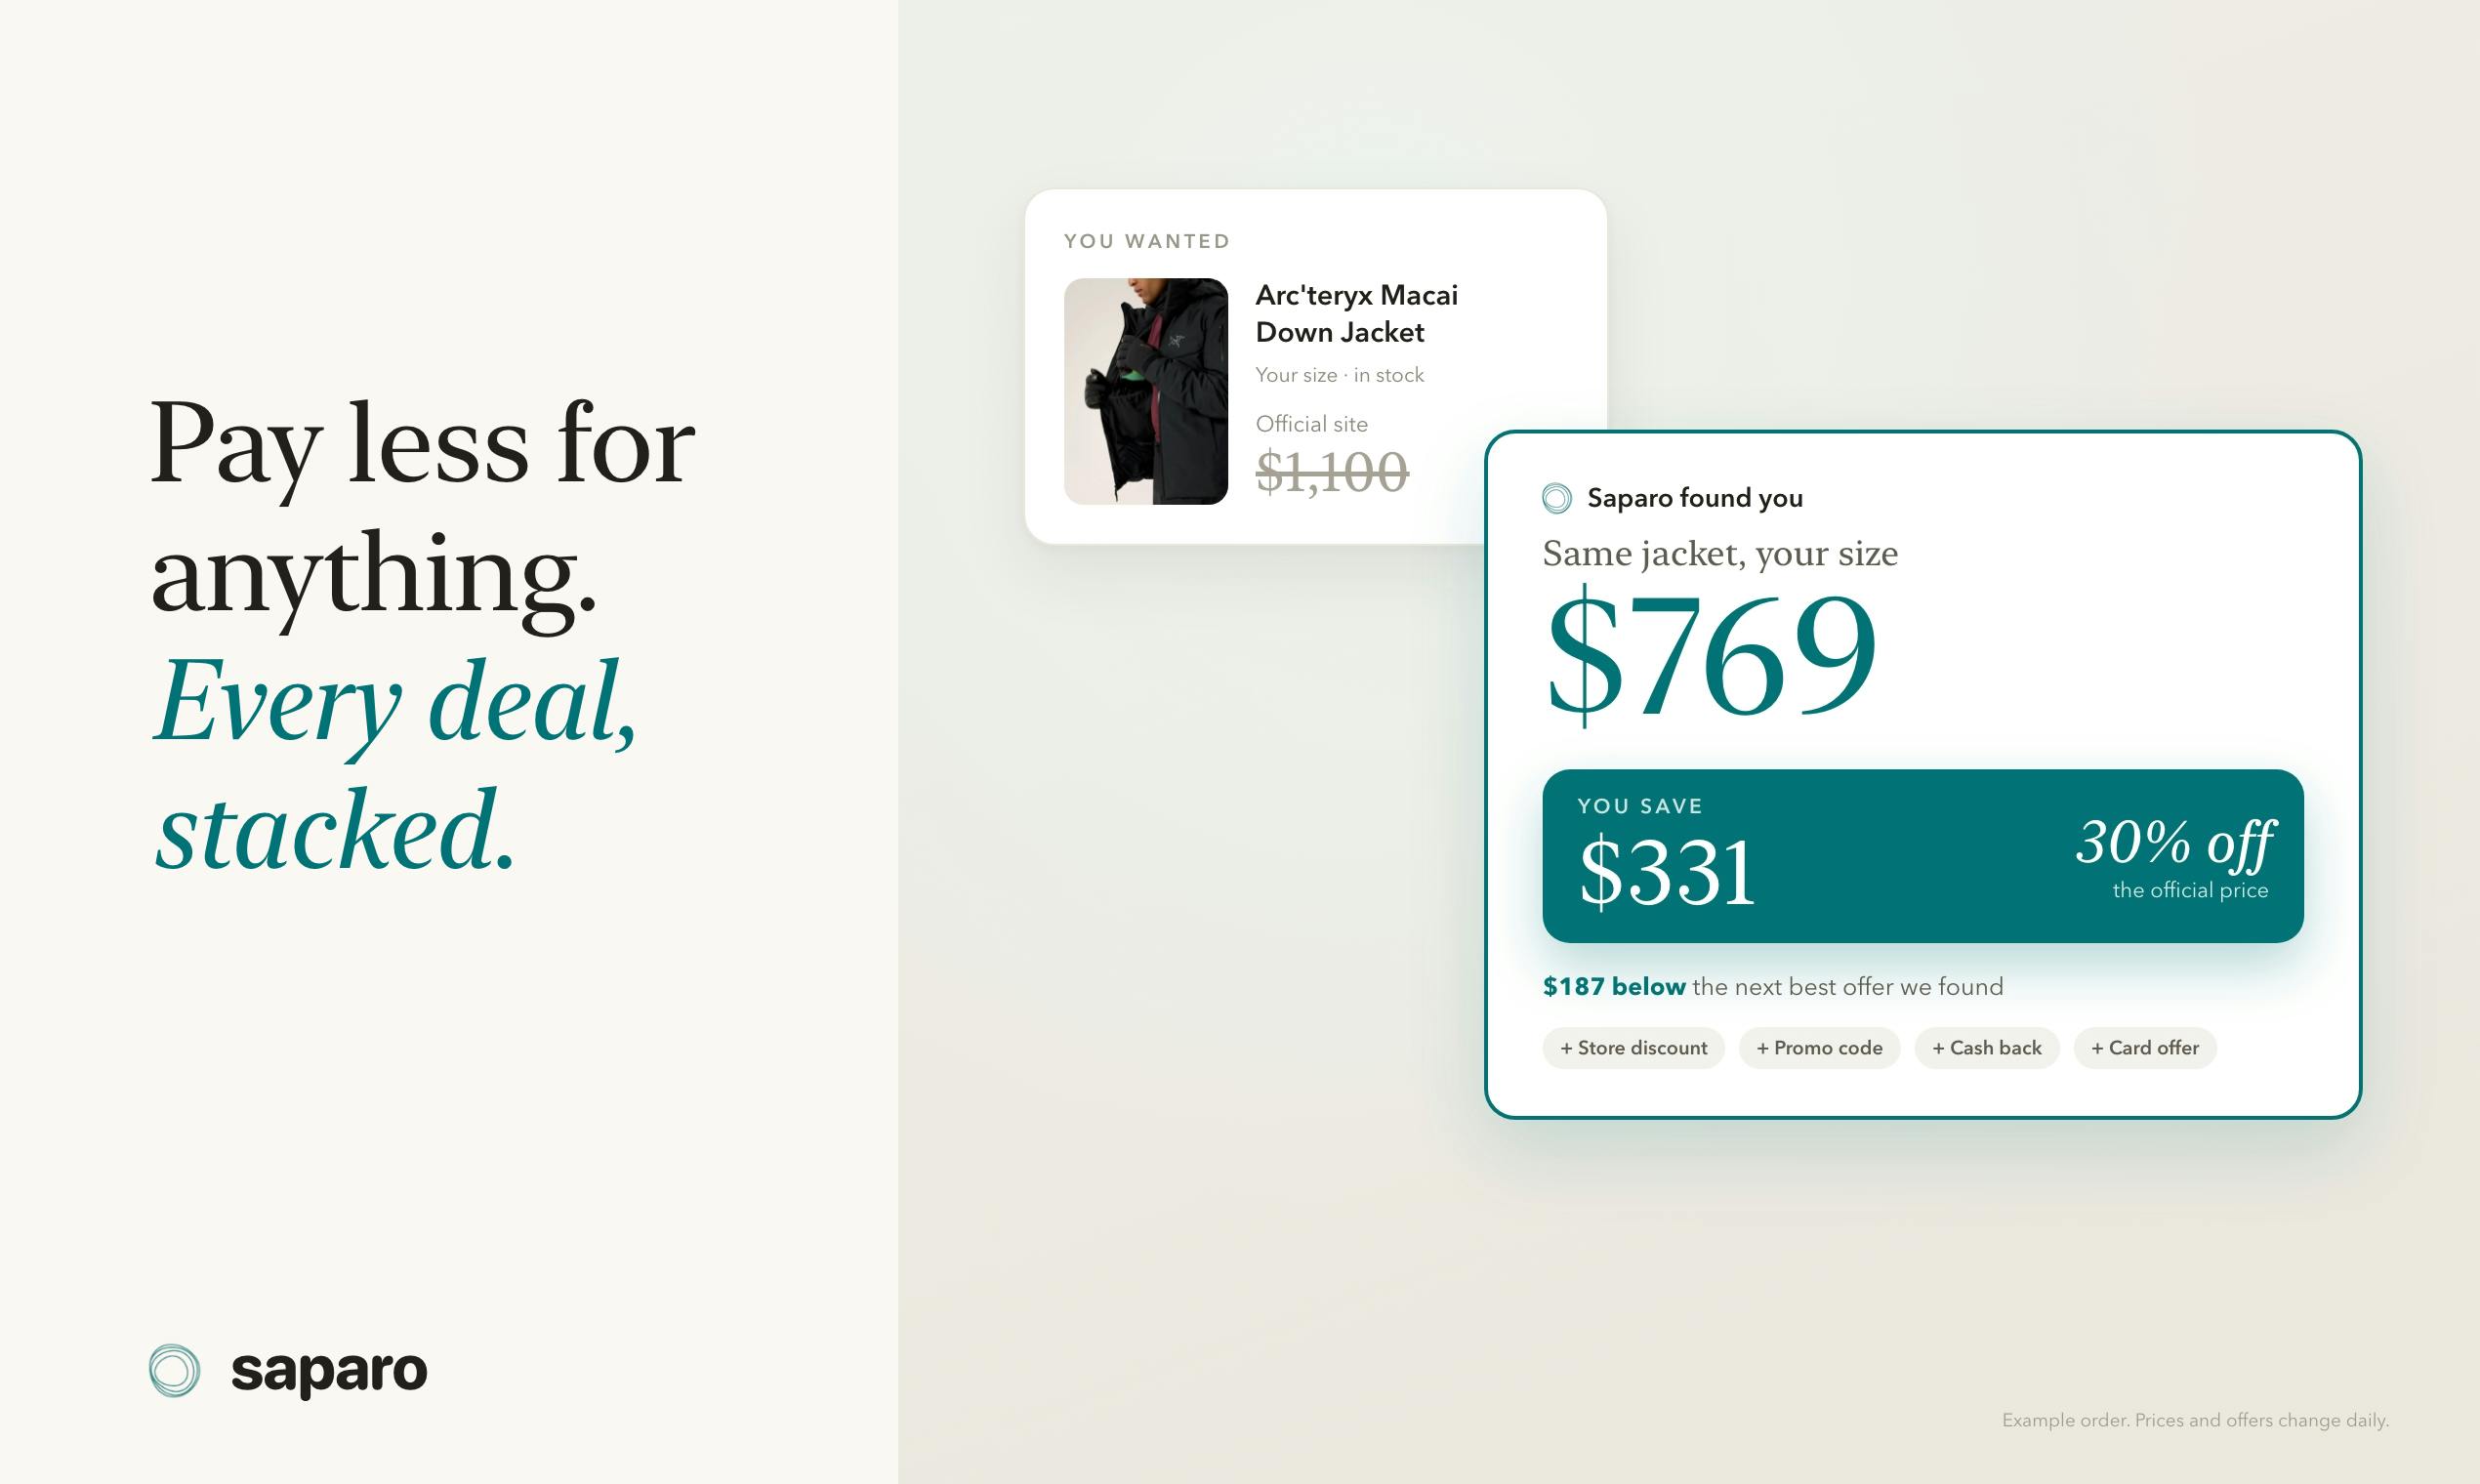
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
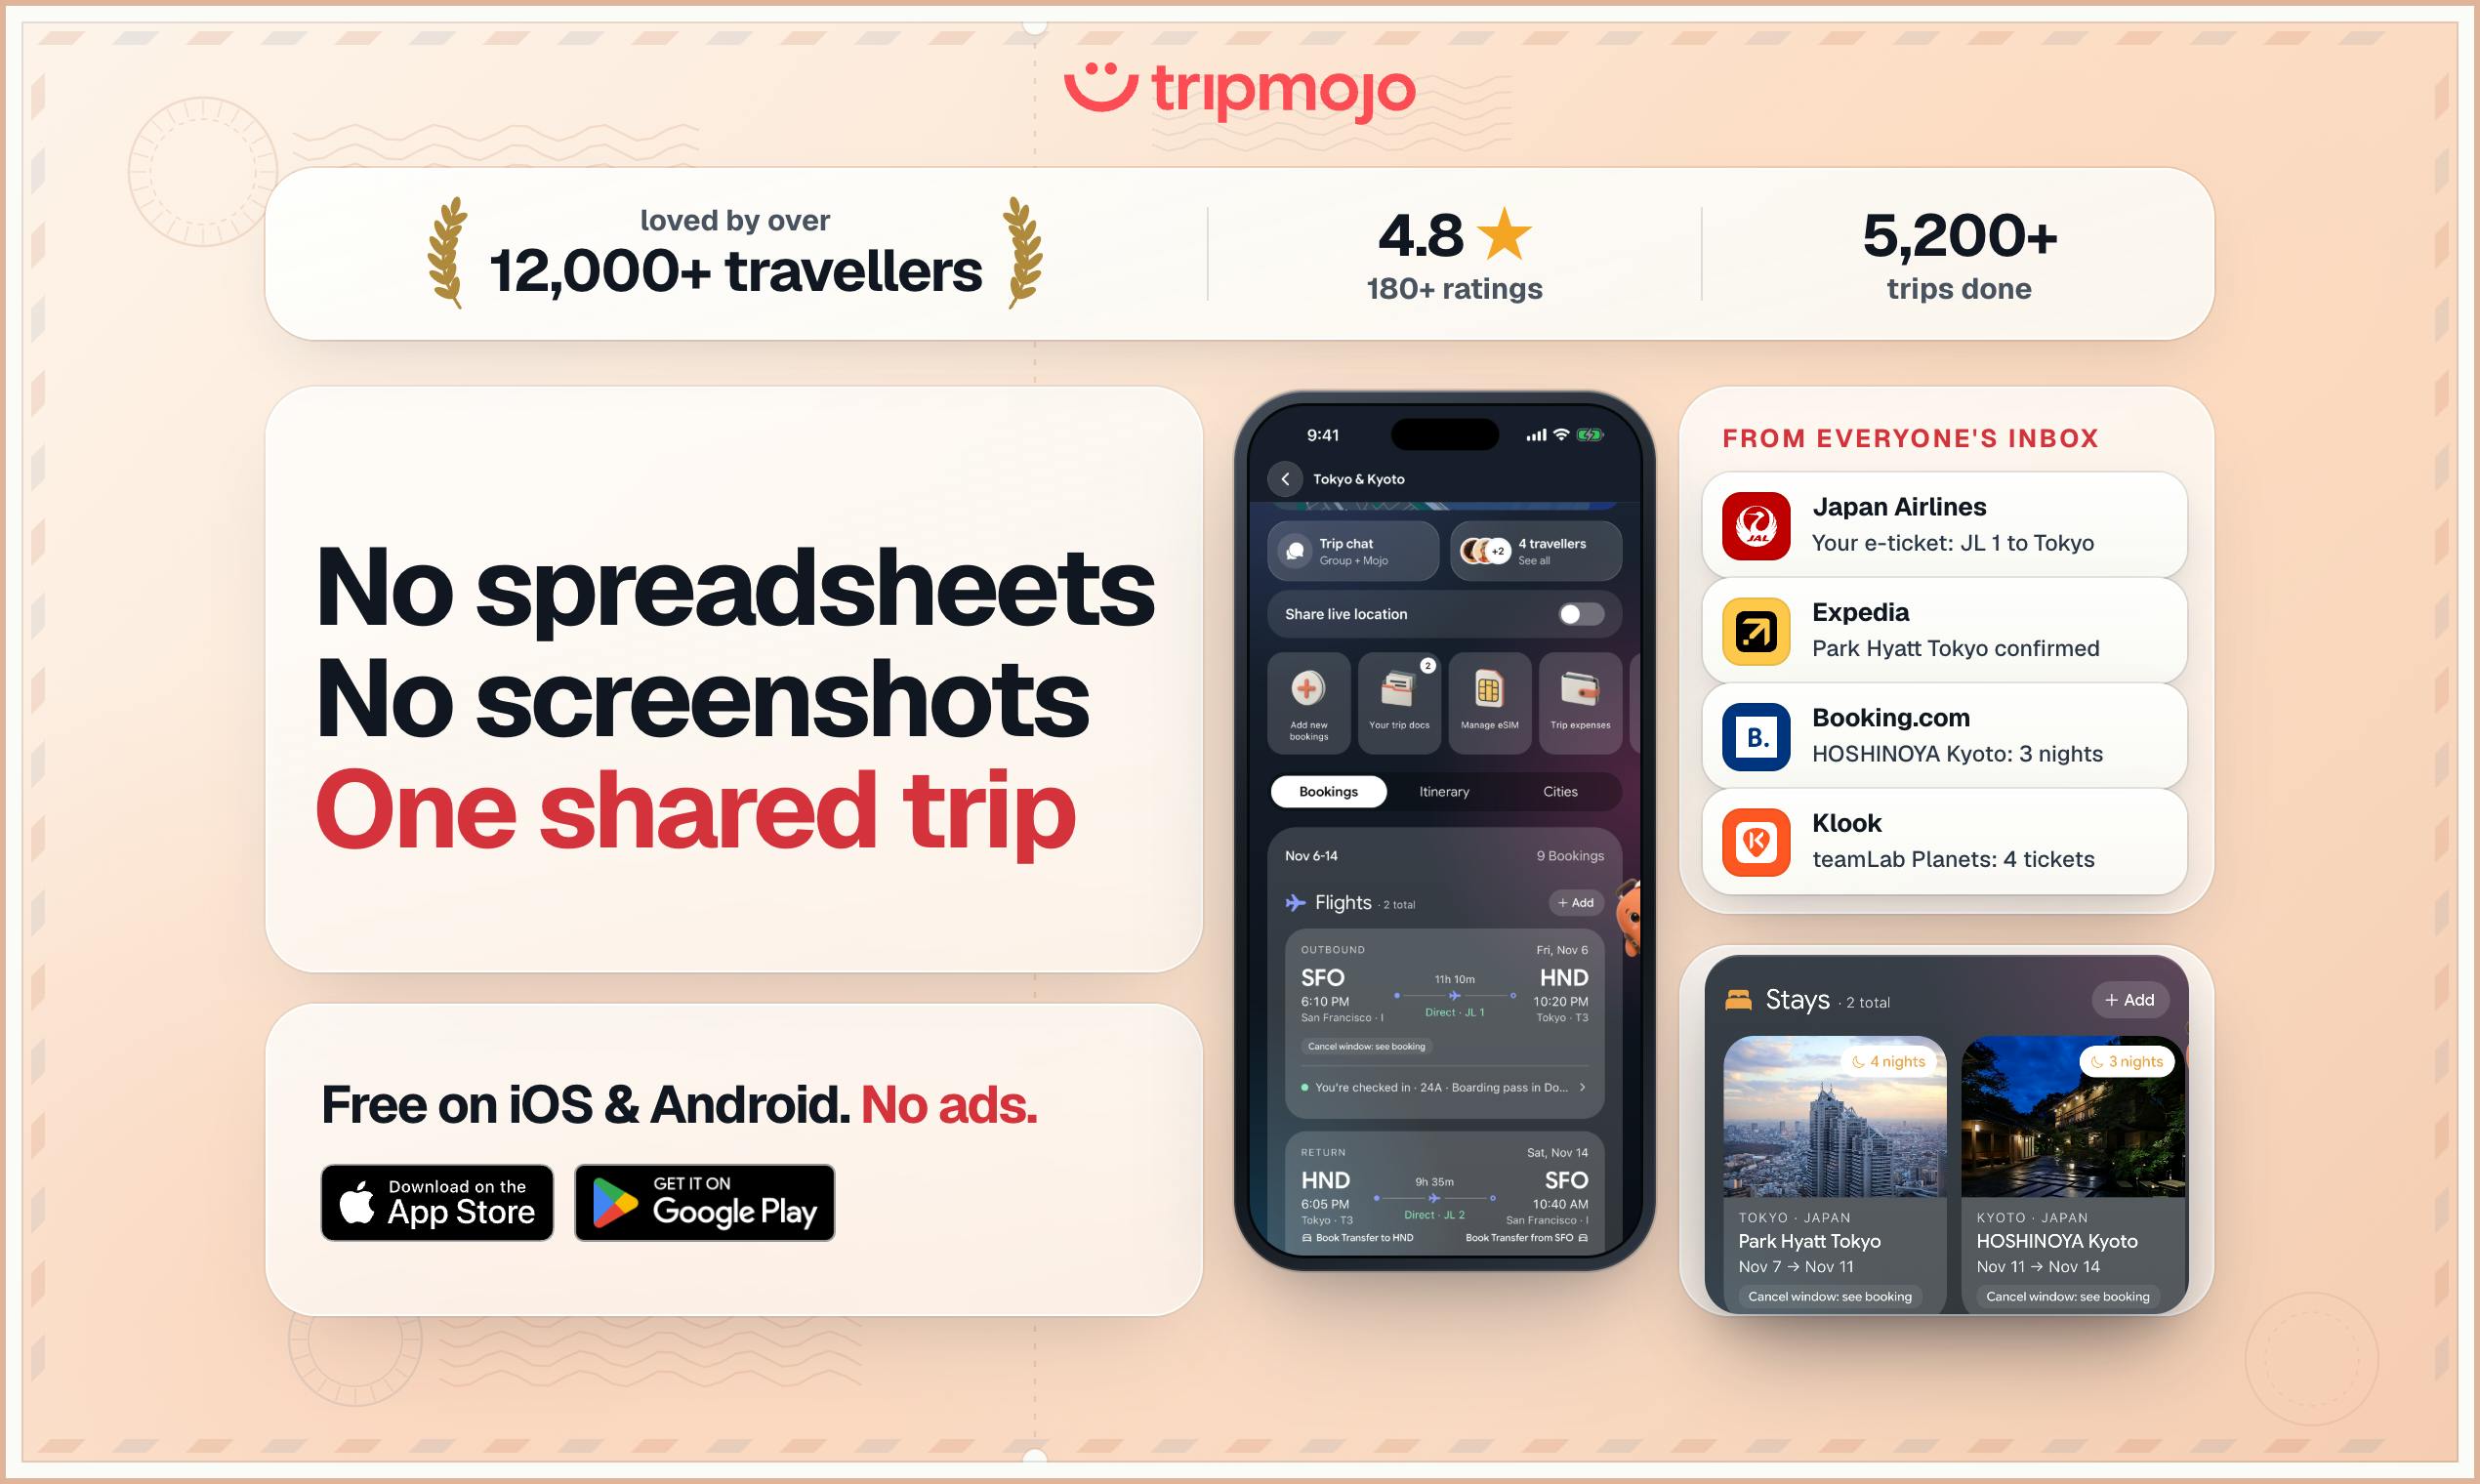
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。