线性探针准确率高,就证明模型学到了线性表征吗?

线性探针高准确率不能证明线性表征,需用三个非对称指标区分线性世界模型与核机器。
本文讨论了一篇质疑线性探针有效性的研究。传统上,线性探针准确率高被视为模型学到线性表征的证据,但该研究指出,任何足够丰富的特征映射(包括随机特征)都允许线性读出,因此高探针准确率与两种几何结构相容:真正的线性世界模型(潜在因子主导线性方向)和核机器(潜在变量嵌入高维弯曲流形)。为区分二者,作者提出三个非对称诊断指标:反向预测性、谱集中度和分布外泛化。在仿真和多个预训练视觉 Transformer 上的实验表明,预训练产生的结构超越随机核但远未达到线性世界模型,且前向可解码性与潜在对齐方差可能分离。结论是评估表征质量需多维度诊断,而非依赖单一探针准确率。
线性探针的普遍假设与潜在漏洞
在预训练视觉模型的研究中,线性表征假设(linear representation hypothesis)长期占据主导地位:模型将生成因子编码为特征空间中的线性可解码方向。验证这一假设的标准方法是训练一个线性探针(linear probe),如果分类准确率高,就认为该因子被线性表征了。
然而,一篇题为《Is a Linear Probe Evidence of a Linear Representation?》的研究指出,这个检验标准过于宽松。从渐近角度看,任何足够丰富的特征映射——包括随机特征映射——都允许线性读出。这意味着高探针准确率实际上与两种截然不同的几何结构相容:一种是真正的线性世界模型,其中潜在对齐的子空间主导表征;另一种是核机器(kernel machine),其中潜在变量线性地嵌入在一个大得多的弯曲流形中。
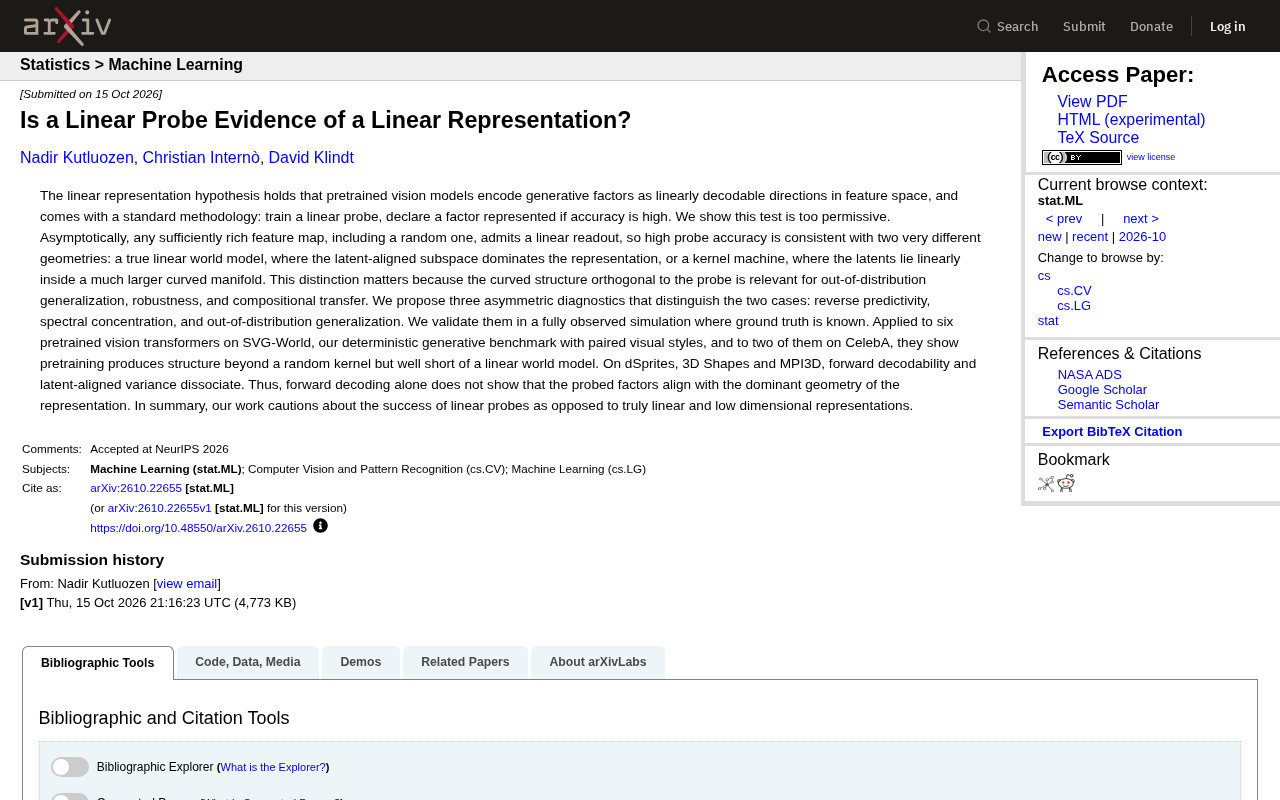
这一区分至关重要,因为与探针正交的弯曲结构直接影响模型在分布外(OOD)场景下的泛化能力、鲁棒性以及组合迁移性能。简单来说,探针准确率高只说明信息“存在”,并不能说明信息以何种几何方式组织。
线性探针(linear probe)是一种在表征学习评估中广泛使用的技术:冻结预训练模型的特征提取器,在其输出特征之上训练一个简单的线性分类器(通常为逻辑回归或线性 SVM),以测试某个目标因子(如物体类别、颜色、姿态)是否可以从特征中线性解码。如果线性分类器能达到接近上限的准确率,研究者通常推断该因子在特征空间中以线性方式被编码。
线性探针的吸引力在于其简单性和可解释性:它将“表征是否包含某信息”转化为一个凸优化问题,避免了非线性探针的过拟合和黑箱性。然而,探针准确率受特征维度、样本量和正则化强度影响显著,高维随机特征也能实现高线性可分性——这正是原文所指出的核心漏洞。
两种几何结构的本质差异
研究团队将这两种情况形式化:
- 线性世界模型:潜在因子对应特征空间中占主导地位的线性方向,探针所捕捉的子空间与表征的主要方差方向一致。
- 核机器:特征空间是一个高维弯曲流形,潜在因子线性地嵌入其中,但流形的弯曲部分(与探针正交)可能携带大量与任务无关或相关的结构。
在核机器情形下,线性探针仍然可以取得高准确率,因为随机特征映射在足够高的维度下也能线性分离数据。但此时模型并没有学到“线性世界模型”,它对分布外数据的响应可能完全偏离预期。
这解释了为什么一些模型在标准基准上探针准确率很高,却在鲁棒性测试或组合泛化任务中表现不佳——它们的表征几何与线性假设并不匹配。
核机器(kernel machine)是一类基于核函数的非参数学习方法,其核心思想是通过核函数隐式地将数据映射到高维(甚至无限维)特征空间,然后在该空间中用线性方法(如线性分类器或回归)解决问题。常见的核机器包括支持向量机(SVM)与核岭回归。
在表征学习语境下,“核机器”被用来描述一种几何结构:潜在因子被线性地嵌入到一个高维弯曲流形中,线性探针之所以成功,是因为高维空间中的线性读出足以分离数据,而非因为潜在因子主导了表征的主要方差方向。这种情形下,流形的弯曲部分(与探针权重正交的方向)可能编码了大量非任务相关的变异,导致模型在分布外数据上失效。核机器的视角为理解“高探针准确率但泛化差”提供了几何解释。
三个非对称诊断指标
为了区分这两种几何结构,作者提出了三个非对称诊断指标:
- 反向预测性(reverse predictivity):从特征反推潜在因子的能力。在线性世界模型中,反向预测应该与正向预测对称;而在核机器中,反向预测会显著弱于正向预测。
- 谱集中度(spectral concentration):检查表征的方差是否集中在与潜在因子对齐的子空间中。线性世界模型应表现出高谱集中度,而核机器的谱分布更分散。
- 分布外泛化(out-of-distribution generalization):在分布偏移下评估探针性能。线性世界模型应保持稳定,核机器则容易崩溃。
这三个指标共同构成一个诊断工具包,帮助研究者判断探针准确率背后的真实几何结构。
谱集中度(spectral concentration)源于对表征协方差矩阵的特征值分析。具体而言,若将特征表示的中心化协方差矩阵进行特征分解,谱集中度衡量的是少数几个主特征值所携带的方差占总方差的比例。在线性世界模型中,与潜在因子对齐的方向应主导方差,表现为特征值谱快速衰减(高谱集中度);而在核机器中,方差分散在大量弯曲方向中,特征值谱衰减缓慢。
谱集中度可通过计算前 k 个特征值的累积方差贡献率或参与比(participation ratio)来量化。该指标的优势在于无需标签,仅依赖特征本身,因此可作为无监督的诊断工具,与需要训练探针的反向预测性和 OOD 泛化形成互补。
实验验证:从仿真到真实基准
作者在一个完全观测的仿真环境中验证了这些诊断指标的有效性,其中 ground truth 已知。随后,他们将方法应用于六个预训练视觉 Transformer 模型,在 SVG-World(一个具有配对视觉风格的确定性生成基准)上进行测试,并对其中两个模型在 CelebA 上进行了评估。
结果表明,预训练确实产生了超越随机核的结构,但远未达到线性世界模型的程度。换句话说,模型学到了一些线性可解码的信息,但表征的几何结构仍然高度弯曲,与理想的线性世界模型存在显著差距。
在 dSprites、3D Shapes 和 MPI3D 数据集上,研究者进一步发现正向可解码性与潜在对齐方差之间出现分离——探针准确率高,但潜在因子并未主导表征几何。
对表征学习研究的启示
这项工作的核心警示是:前向解码准确率本身并不能证明被探测的因子与表征的主导几何对齐。线性探针作为一种工具,其成功不应被简单等同于“模型学到了线性且低维的表征”。
对于从事可解释性、鲁棒性或组合泛化研究的从业者,这意味着需要更谨慎地解读探针结果。在评估模型是否真正学到结构化表征时,应结合反向预测、谱分析和 OOD 测试等多维度诊断,而非依赖单一准确率指标。
该研究也提示,设计更好的表征学习目标——鼓励谱集中和线性对齐——可能是提升模型泛化能力的关键方向。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。