小米MiMo-V2.6发布:万亿参数多模态MoE,vLLM零日支持
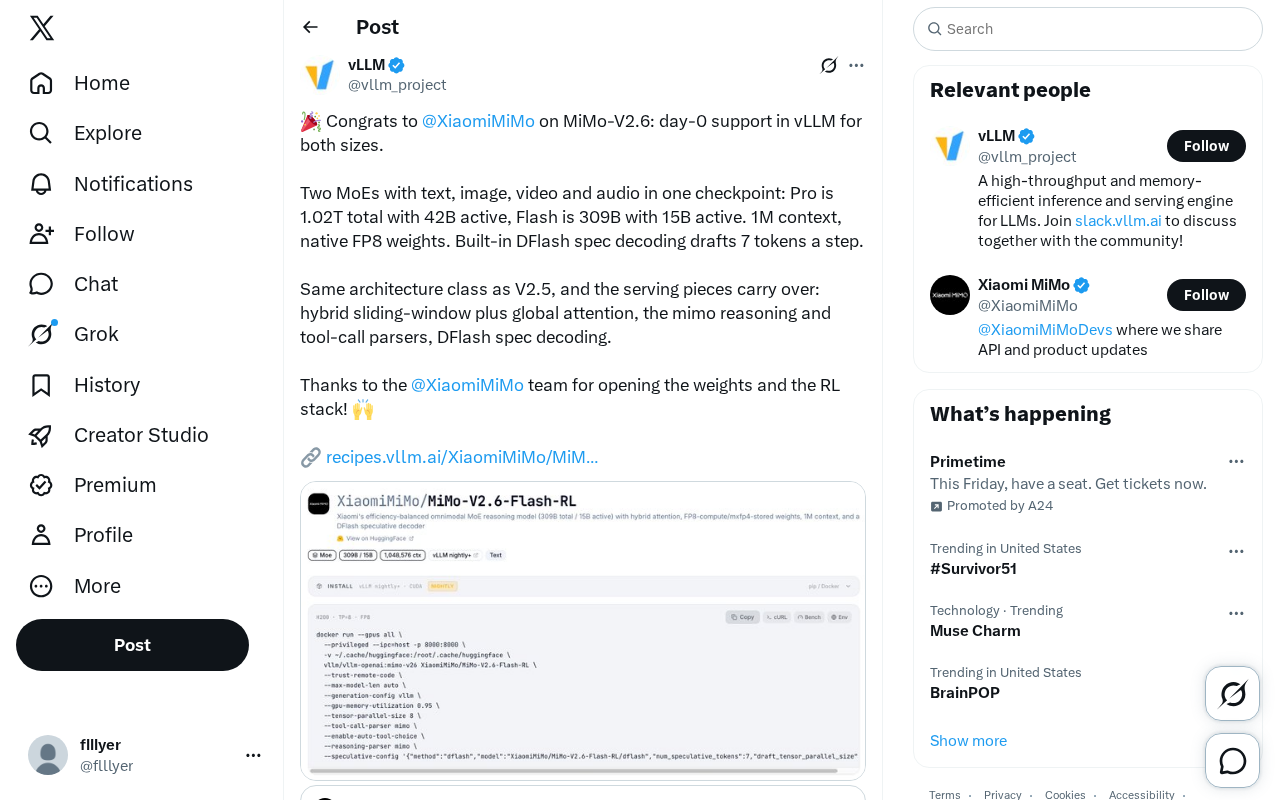
小米MiMo-V2.6发布Pro与Flash两款MoE多模态大模型,获vLLM零日支持并开放权重与RL训练栈。
小米MiMo团队发布MiMo-V2.6,推出Pro(1.02T总参/42B激活)与Flash(309B总参/15B激活)两个MoE架构版本,均在单一checkpoint内原生融合文本、图像、视频、音频四种模态。技术层面,模型支持百万token上下文、原生FP8权重,并内置每步草拟7个token的DFlash投机解码机制。发布当天即获vLLM零日支持,开发者无需等待适配即可直接部署。小米同步开放模型权重与强化学习训练栈,为社区复现与改进提供了完整基础。与V2.5的架构延续性也大幅降低了已有部署的迁移成本。
小米开源大模型再进一步
小米MiMo团队发布了新一代多模态大模型MiMo-V2.6,并同步获得vLLM的零日(day-0)支持——两个规格版本在发布当天即可通过vLLM部署运行。这一节奏在开源大模型领域并不常见,通常需要社区花费数天甚至数周完成推理框架适配,而小米此次与vLLM的深度协同显著缩短了从发布到可用的时间。
对于希望第一时间上手的开发者而言,这意味着无需等待额外的适配工作,即可将模型接入现有的推理服务栈。小米同时开放了模型权重与RL(强化学习)训练栈,延续了其在开源生态上的投入。
两个MoE版本:Pro与Flash
MiMo-V2.6此次推出两个混合专家(MoE)架构版本,覆盖不同算力与场景需求。
Pro:万亿级参数的旗舰版
Pro版本总参数量达到1.02万亿(1.02T),激活参数为42B。MoE架构的核心优势正在于此——尽管总参数量巨大,但每次推理仅激活其中一部分专家(42B),从而在保持模型容量的同时控制实际计算成本。
Flash:轻量高效版
Flash版本总参数为309B,激活参数15B,定位于对延迟和成本更敏感的部署场景。相比Pro,Flash在保留多模态能力的前提下大幅降低了资源门槛,更适合规模化的在线服务。
两个版本均为单一checkpoint内融合文本、图像、视频和音频四种模态,属于真正意义上的原生多模态模型,而非多个单模态模型的拼接。
混合专家(Mixture of Experts,MoE)是一种将模型参数分散在多个"专家"子网络中的架构范式。传统密集模型在每次前向传播时会激活全部参数,而MoE模型通过一个路由机制(router),对每个输入token只选择少数几个专家进行计算。这使得模型可以拥有远超实际计算量的参数总量——即所谓"稀疏激活"。以Pro版为例,1.02T总参数中每次推理仅激活42B,计算量与同规模密集模型相比大幅缩减,但模型的知识容量和表达能力却接近万亿参数级别。这种设计在大规模语言模型中已被GPT-4、Mixtral、DeepSeek广告等多个知名模型采用,被视为在算力约束下扩展模型规模的主流路径之一。MoE的主要挑战在于专家负载均衡(避免部分专家被过度使用而其余闲置)以及分布式部署时的通信开销。
关键技术特性
MiMo-V2.6在架构与工程层面延续了V2.5的设计思路,同时集成了多项面向高效推理的技术。
百万级上下文与原生FP8
模型支持1M(一百万)token的上下文长度,能够处理超长文档、长视频等复杂输入。同时采用原生FP8权重,在降低显存占用和提升吞吐的同时,避免了后期量化可能带来的精度损失。
FP8(8位浮点数)是近年来推理和训练加速的重要方向,相比主流的FP16/BF16可将显存占用降低约一半,同时在支持FP8硬件(如NVIDIA H100/H800)上可获得更高的矩阵运算吞吐。"原生FP8"与"后量化FP8"的关键区别在于:后量化是在FP16训练完成后再压缩权重,可能引入精度下降;而原生FP8意味着模型在训练阶段即以FP8格式存储和计算关键权重,精度损失更小且与推理框架的兼容性更好。1M token上下文的实现通常依赖稀疏注意力机制(如滑动窗口注意力)或线性注意力变体,否则标准全注意力的显存需求会随序列长度平方增长,导致百万级上下文在工程上不可行。
DFlash投机解码
内置的DFlash投机解码(spec decoding)机制每步可草拟(draft)7个token。投机解码通过一个较小的草稿模型预测多个候选token,再由主模型批量验证,从而显著加快生成速度。每步7个token的草拟规模在同类方案中处于较高水平。
投机解码(Speculative Decoding)是一种通过"草稿-验证"流程提升自回归生成速度的推理加速技术。标准自回归解码每步只能生成一个token,成为大模型推理的主要延迟瓶颈。投机解码引入一个参数量更小、速度更快的草稿模型(draft model),一次性预测若干个候选token序列,再将整个序列交由主模型并行验证——若草稿token被接受则直接采用,若某个token被拒绝则从该位置重新采样。由于验证过程可以并行完成,理论上可以在几乎不损失生成质量的前提下成倍提升有效吞吐量。每步草拟7个token意味着在理想接受率下,单次主模型前向传播可产出多达7个有效token,加速比显著高于每步仅草拟3-4个token的常见配置。DFlash应为小米针对自身架构特点定制优化的投机解码实现方案。
服务组件的复用
由于MiMo-V2.6与V2.5属于同一架构类别,此前的服务端组件可直接沿用,包括:
- 混合滑动窗口注意力 + 全局注意力:兼顾长上下文效率与全局信息捕捉
- MiMo推理与工具调用解析器(reasoning and tool-call parsers)
- DFlash投机解码
这种架构延续性对已经部署过V2.5的团队尤为友好,迁移成本大幅降低。
对开源生态的意义
从技术布局看,MiMo-V2.6同时提供万亿级旗舰与轻量版本,覆盖了从研究探索到生产部署的完整梯度。原生多模态、百万上下文、FP8权重与投机解码的组合,反映出小米在追求模型能力的同时,对实际推理效率给予了同等重视。
更值得关注的是权重与RL训练栈的开放。RL栈的公开对社区尤为难得——强化学习后训练往往是模型能力的关键环节,也是许多闭源模型不愿透露的部分。小米的这一举措为研究者复现和改进提供了更完整的基础。
配合vLLM的零日支持,MiMo-V2.6在“可用性”这一常被忽视的维度上做出了表率。一个能力再强的开源模型,若缺乏成熟的推理支持,其实际影响力也会大打折扣。小米此次在模型发布与生态适配上的同步推进,或将成为开源多模态模型交付的一个参考范式。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
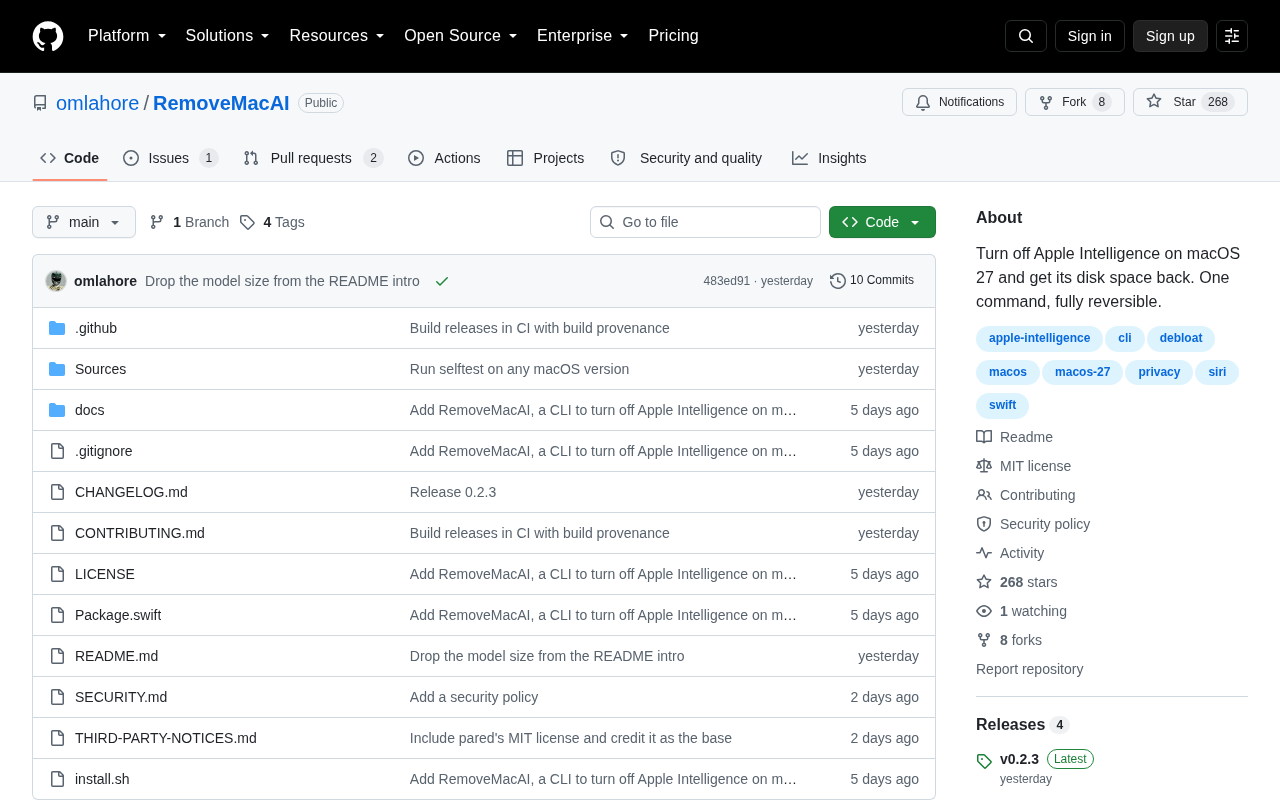
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。