小米直播百万美元级RL训练:MiMo-V2.6如何公开挑战强化学习极限
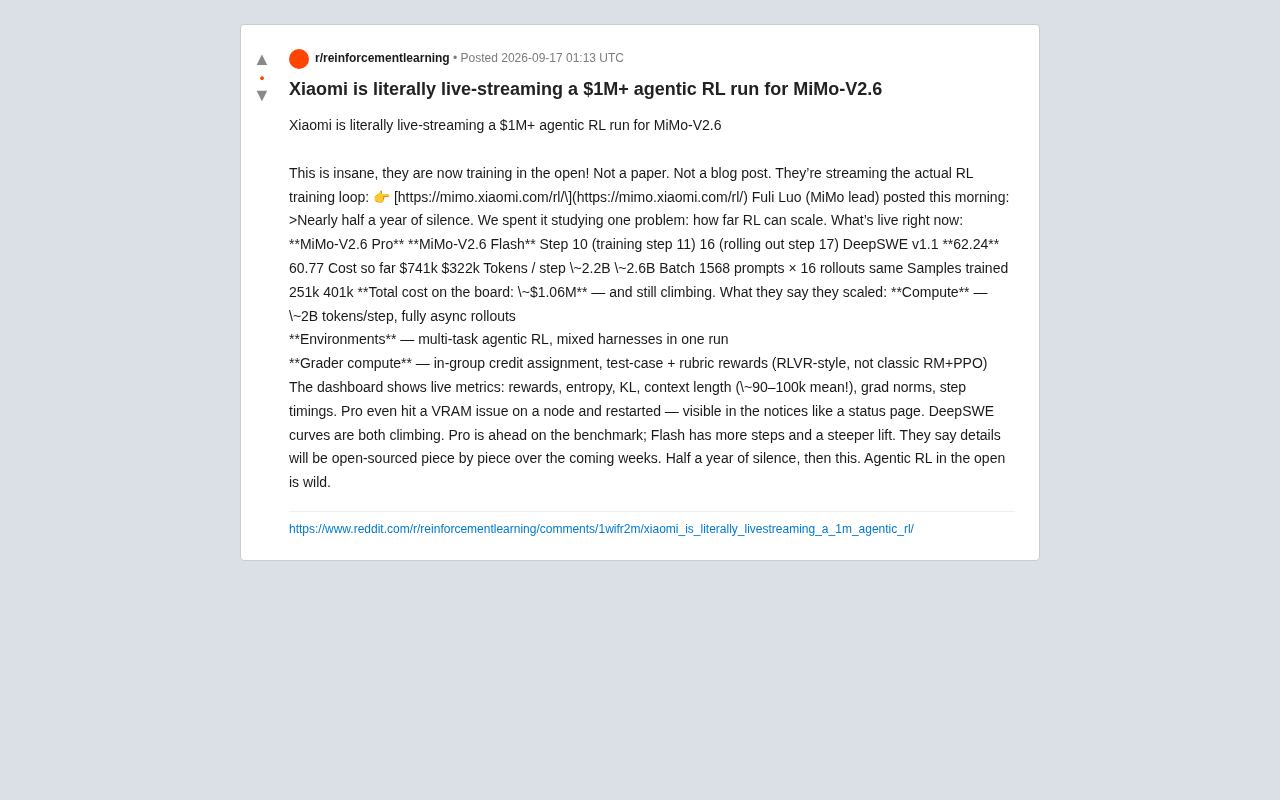
小米实时直播超百万美元的智能体强化学习训练,把成本、故障与收敛曲线全部公开。
小米将一场耗资逾106万美元的智能体强化学习训练过程搬到公开直播页面,同步训练MiMo-V2.6 Pro与Flash两个模型,任何人均可实时查看训练步骤、奖励曲线、KL散度、上下文长度乃至显存故障记录。训练采用RLVR风格奖励机制(测试用例+rubric打分),结合完全异步rollout与多任务混合环境,从算力、环境、评分三个维度扩展强化学习。Pro在DeepSWE基准上暂时领先(62.24 vs 60.77),Flash则以更少成本走出更陡峭的上升曲线。小米承诺未来数周开源训练细节,但当前数据仍仅由官方自证,需等待第三方验证后才能完整评估其价值。
一场没有先例的公开训练实验
小米做了一件业界罕见的事:把一场耗资超过百万美元的智能体强化学习(Agentic RL)训练过程,实时直播出来。没有论文,没有博客总结,而是把真实的 RL 训练循环搬到了公开页面上——任何人都可以打开 mimo.xiaomi.com/rl 看到正在滚动的每一个训练步骤。
MiMo 项目负责人 Fuli Luo 在发布时写道:"近半年的沉默,我们只研究了一个问题:RL 究竟能扩展到多远。"这句话点出了整件事的核心——这不是一次营销活动,而是一场关于强化学习可扩展性(scalability)的公开压力测试。
仪表盘上的真实数字
直播页面同时训练两个模型:MiMo-V2.6 Pro 和 MiMo-V2.6 Flash。截至观测时,两者的关键指标已经公开在"记分牌"上:
| 指标 | MiMo-V2.6 Pro | MiMo-V2.6 Flash |
|---|---|---|
| 训练步 | Step 10(进行至 11) | Step 16(滚动至 17) |
| DeepSWE v1.1 得分 | 62.24 | 60.77 |
| 累计成本 | $741k | $322k |
| 每步 Tokens | ~2.2B | ~2.6B |
| Batch | 1568 prompts × 16 rollouts | 同上 |
| 已训练样本 | 251k | 401k |
两者相加,记分牌上的总成本约 106 万美元,并且还在持续攀升。这种把烧钱过程赤裸裸展示给公众的做法,在大模型训练领域几乎没有先例。
从数据可以看出两个模型走了不同路线:Pro 在 DeepSWE 基准上暂时领先,而 Flash 步数更多、提升曲线更陡峭。这意味着 Flash 可能以更低成本追赶甚至反超,成为直播中值得持续关注的看点。
DeepSWE 是一个面向软件工程智能体的基准测试,评估模型在真实代码库中完成任务(如修复 bug、实现功能)的能力,得分反映的是智能体在完整开发环境中的端到端成功率,而非单纯的代码补全质量。与 HumanEval 或 MBPP 等传统代码基准相比,DeepSWE 要求模型具备多步骤规划、工具调用与错误恢复能力,更贴近真实软件工程场景。60 分以上的得分在当前智能体排行榜上属于第一梯队水平,这也是小米选择它作为直播核心指标的原因——它比单题代码生成更能体现智能体强化学习的实际收益。
他们究竟在"扩展"什么
小米在这次训练中强调的扩展不是单纯堆算力,而是三个维度的协同放大:
算力层面——每步约 20 亿 tokens,采用完全异步(fully async)的 rollout 机制,避免同步等待造成的算力浪费。
环境层面——多任务智能体强化学习,在同一次运行中混合多种 harness(任务执行框架)。这意味着模型不是在单一任务上刷分,而是在多样化的真实环境中学习。
评分算力层面——这是最值得玩味的部分。他们采用组内信用分配(in-group credit assignment),结合测试用例奖励与评分标准(rubric)奖励,属于 RLVR(可验证奖励强化学习)风格,而非经典的 RM+PPO(奖励模型加近端策略优化)方案。
这套组合拳的意义在于:奖励信号来自可验证的结果(比如代码是否通过测试),而不是一个可能被"钻空子"的奖励模型。对于智能体任务而言,这种奖励设计更贴近真实能力评估。
RLVR(可验证奖励强化学习) 是近两年在代码、数学等领域兴起的一种 RL 范式,其核心思想是用客观可验证的信号替代神经网络奖励模型(Reward Model)。传统的 RM+PPO 流程需要先用人类标注数据训练一个奖励模型,再用该模型的打分驱动策略优化——这带来两个风险:奖励模型本身可能出错,以及模型学会"讨好"奖励模型而非真正解决问题(即 reward hacking)。RLVR 绕开了这一步,直接用程序判断结果正误:代码题看测试用例是否通过,数学题看答案是否匹配标准解。这种方式奖励信号几乎不可被"钻空子",尤其适合有明确正误判断的编程类智能体任务。DeepSeek广告-R1 和 OpenAI o 系列的训练细节中均有类似机制的影子,MiMo 此次将其扩展到多任务智能体场景,是对 RLVR 在更复杂环境下可行性的公开压力测试。
透明到暴露故障的仪表盘
直播页面公开的指标细致到令人惊讶:奖励曲线、熵(entropy)、KL 散度、上下文长度(平均约 90k–100k!)、梯度范数、每步耗时全部实时可见。
更有意思的是,Pro 在某个节点上遇到了显存(VRAM)问题并触发重启——这个故障像状态页一样直接显示在通知里。对于习惯了厂商只展示成功结果的观察者来说,看到一次训练中真实的"翻车与恢复",反而增加了整件事的可信度。
DeepSWE 的两条曲线都在向上爬升,说明训练本身处于健康状态。这种把成功与失败一并公开的姿态,某种程度上重新定义了"技术透明"的边界。
仪表盘中的几个核心指标值得专门解释。熵(Entropy) 衡量模型输出分布的多样性:训练中若熵持续下降至极低值,意味着模型"坍缩"到固定输出模式,是过度优化的警示信号。KL 散度(KL Divergence) 则度量当前策略与参考策略(通常是训练前的基础模型)的偏离程度,过大的 KL 值意味着模型可能已偏离预训练知识太远。梯度范数(Gradient Norm) 反映参数更新的幅度,异常峰值往往预示着训练不稳定或即将出现的显存溢出。上下文长度平均达到 90k–100k tokens,在智能体任务中并不罕见——智能体需要在单次推理中读取工具返回结果、历史操作记录与任务描述,长上下文是真实工作轨迹的天然结果,同时也是对 GPU 显存与 KV Cache 管理的极限考验,这也解释了为何 Pro 出现了显存触顶并触发重启。
为什么这件事值得关注
近半年的沉默之后突然抛出这样一场直播,小米传递的信号很清晰:智能体强化学习正在从论文走向工程化的规模验证阶段。
过去我们评估一个模型,通常只能看到最终的 benchmark 分数和一篇事后总结。而公开训练循环意味着社区可以实时观察成本、收敛速度、稳定性之间的真实权衡。对研究者而言,这比任何一篇论文都更有说服力——因为它无法事后修饰。
小米表示,相关细节将在未来数周内逐步开源。如果这一承诺兑现,MiMo-V2.6 这次"开放式训练"很可能成为智能体 RL 领域一个具有参考价值的样本:不仅是结果开源,连过程都开源。
当然,也需要保持一份审慎。直播仪表盘上的数字目前只能由小米自身佐证,第三方尚无法验证其真实性与完整性。真正的价值,仍要等到承诺的开源细节落地后才能完整评估。但无论如何,把百万美元级的 RL 训练搬到公众面前,本身已经是一次大胆的行业动作。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。