小模型微调逆袭:2B/4B参数击败GPT-6 Luna

微调后的Qwen 3.5小模型在电商分类任务上准确率反超GPT-6 Luna,成本仅45美分。
文章通过Shopify商品分类实验,验证了微调小模型在垂直任务上击败通用大模型的可行性。实验使用约209个品类、5000条训练和1000条评估数据,对比未微调的GPT-6 Luna(68.2%)、Qwen 3.5 2B(20.4%)和4B(43.5%)。在Crusoe平台以LoRA方式微调后,2B模型准确率跃升至69.8%,4B达到73%,均超过GPT-6 Luna,而单次训练成本仅约45美分。作者详细记录了数据预处理、超参数设置(rank 16、alpha 32、学习率0.0002等)和checkpoint选择要点,并指出该方法适用于标签体系封闭、任务定义清晰的高频场景,但不应过度解读为小模型全面超越大模型。
为什么小模型微调值得关注
大模型军备竞赛之下,一个反直觉的事实正在被反复验证:在垂直任务上,经过微调的小参数开源模型可以击败通用大模型。一位YouTube技术创作者用电商产品分类任务做了一次完整实验——把20亿和40亿参数的Qwen 3.5模型微调后,与GPT-6 Luna同台竞技,结果颇具说服力。
实验的出发点很朴素:GPT-6 Luna开箱即用,理应是全场最强的模型;两个小模型未经微调时表现糟糕,因为它们对上下文的理解能力有限。但真正的问题是——微调能否让"差生"反超"优等生"?
实验设计:Shopify商品分类任务
数据集与预处理
作者选用Shopify产品目录数据作为概念验证,任务是将商品标题和描述归入正确的品类。数据集中包含约209个层级品类,例如"Sporting Goods > Indoor Games"。
准备脚本把原始数据转换成微调所需的JSONL格式:每一行是一条消息历史,包含系统提示词、用户输入(标题+描述)和助手回复(正确分类标签)。为了结果可复现,实验固定随机种子为42,使用5000条商品训练、1000条商品评估。作者也坦言,如果使用全量数据集,效果可能更好。
整个流程分为prepare和evaluate两个脚本,代码已开源,可直接复用或修改。
三方对比基线
评估脚本比较三组对象:
- GPT-6 Luna(未微调,作为需要被击败的基线)
- Qwen 3.5 2B(未微调)
- Qwen 3.5 4B(未微调)
系统提示词有两种版本:给通用大模型时需列出全部候选标签;给微调后的模型时可以省略标签列表,直接要求分类——这本身就是微调带来的能力差异。评估指标只有一个:准确率。
基线结果:差距有多大
未微调状态下,三者表现拉开了明显梯度。GPT-6 Luna在1000条评估样本上达到68.2%准确率,是需要跨越的门槛。Qwen 3.5 2B仅有20.4%,几乎不具备实用价值;Qwen 3.5 4B为43.5%,虽然好于2B版本,仍与GPT-6 Luna存在显著差距。
这样的结果符合预期:小模型缺乏对商品品类体系的理解,也缺少足够的指令遵循能力。真正的悬念在于微调之后。
微调实操:Serverless平台上的LoRA训练
云端训练流程
作者选择在Crusoe的Intelligence Foundry中进行serverless微调(该平台为视频赞助方)。这一选择有现实考量:消费级硬件跑2B/4B模型尚可,但扩展到8B、16B、32B参数时,本地设备要么太慢,要么根本装不下。
操作路径很直接:进入Model Shaping → Serverless Fine-Tuning → 创建微调任务,选择Qwen 3.5 2B模型,上传train.jsonl,平台会显示预计训练成本——本次仅约45美分。
超参数设置
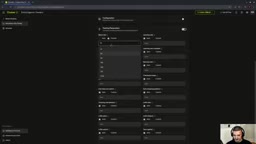
作者手动设置了一组自定义超参数(而非使用默认值),以便复现此前跑出的结果:
- batch size:16
- LoRA rank:16
- LoRA alpha:32(rank的两倍)
- dropout:0.05
- 学习率:0.0002
- epoch数:1
- warm-up ratio:0.05
- weight decay:0
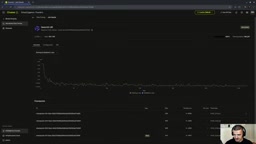
训练启动后可以实时观察训练损失曲线,每约100步生成一个checkpoint。作者特别提醒:最后一个checkpoint未必是最好的——上一次运行时,第300步的checkpoint才是最优的。是否沿用最佳checkpoint,需要根据训练损失判断,但训练损失并不必然映射到验证集准确率。
训练完成后有两种使用方式:直接在Crusoe平台部署模型(适合没有本地算力或模型较大的场景),或下载checkpoint的zip包到本地推理。作者选择后者,在Dell Pro Max with GB10上完成评估。
4B模型的微调流程完全相同,只是换选Qwen 3.5 4B并复用已上传的数据集,超参数保持一致。
LoRA(Low-Rank Adaptation) 是一种参数高效微调技术。其核心思想是冻结预训练模型的所有原始权重,在每一层(通常是注意力层的投影矩阵)旁注入两个低秩矩阵 A 和 B,训练时只更新这两个小矩阵。若原始权重矩阵维度为 d×k,LoRA 将其更新量分解为 d×r 和 r×k 两个矩阵的乘积,其中秩 r 远小于 d 和 k(本文中 r=16)。这样可训练参数从数亿级降至百万级,显存占用和训练时间大幅下降,同时因为原始权重不变,模型不会遗忘预训练知识。LoRA alpha 是缩放因子,实际更新量为 (alpha/r)·BA,本文设 alpha=32 即缩放系数为 2,常用于让低秩更新的幅度更匹配原始权重。
Serverless 微调 指用户无需管理服务器或 GPU 集群,只需上传数据集并配置超参数,平台按实际消耗的计算资源计费。它适合中小规模实验,成本可低至几毛钱一次,但也意味着对底层硬件和并行策略的控制权有限。
Batch size(批大小) 指一次参数更新所使用的样本数。本文设为 16,意味着每 16 条商品数据计算一次梯度并更新 LoRA 权重。批大小影响训练稳定性和速度:太小则梯度噪声大,太大则可能泛化变差且显存占用高。
Dropout 是一种正则化手段,训练时以一定概率(本文 0.05)随机将神经元输出置零,防止模型过度依赖某些特征。在 LoRA 中通常作用于低秩分支,较小的值(0.05)表示正则化较弱。
学习率(0.0002) 控制每次参数更新的步长。对 LoRA 微调而言,1e-4 到 3e-4 是常见区间,本文取值处于中上水平,配合仅 1 个 epoch 的训练,能在较短时间内完成适配而不至于过拟合。
Warm-up ratio(0.05) 指训练初期用总步数的 5% 将学习率从 0 线性增加到设定值,避免一开始就大步更新破坏预训练权重。Weight decay(0) 即不施加权重衰减正则化,因为 LoRA 本身参数量极少,过拟合风险较低。
结果:小模型的逆袭
微调后的成绩单令人意外。Qwen 3.5 2B从20.4%跃升至69.8%,已经小幅超过GPT-6 Luna的68.2%——作者也坦承这个差距可能被视为噪声或平局,但趋势已经显现。
Qwen 3.5 4B的提升更为明显,微调后准确率达到73%,显著超过GPT-6 Luna。
这个结果的意义需要放在对比框架里理解:GPT-6 Luna是闭源的前沿模型(作者提到它是GPT-6系列中最小的一款,但具体参数量未知),而两个开源小模型在垂直任务上通过几百条训练样本和不足一美元的训练成本实现了超越。
Checkpoint(检查点) 是训练过程中定期保存的模型权重快照。本文每约 100 步保存一次,因此 1 个 epoch 的 5000 条数据在 batch size 16 下约产生 313 步,对应 3 个左右的 checkpoint。选择哪个 checkpoint 部署是一个模型选择问题:训练损失最低的 checkpoint 可能在训练集上过拟合,而在未见过的验证集上表现反而下降。因此作者强调应结合验证集准确率来挑选,而非仅看 loss 曲线。这也解释了为什么“最后一个 checkpoint 未必最好”——训练后期 loss 仍在下降,但泛化性能可能已经见顶。
这套方法论能复制到哪里
作者在视频中反复强调,Shopify数据集只是一个概念验证,同样的流程可以迁移到任何"输入文本、输出有限类别"的任务:客服工单路由、内容审核分级、商品标签体系维护、意图识别等。
几个值得带走的实践要点:
第一,先建立基线再微调。 不测未微调模型的准确率,就无法判断微调带来的真实增益。
第二,小模型的选择要有梯度。 2B和4B的表现差距说明,参数量不是越大越好,但过小的模型即使微调后天花板也有限,值得在同一任务上多试几个规格。
第三,训练损失不等于业务指标。 checkpoint的挑选应结合验证集评估,而非只看loss曲线的最低点。
第四,评估必须用未见数据。 本次实验的1000条评估样本全程未参与训练,这是结论可信的前提。
第五,微调后的模型对提示词依赖更低。 不再需要把所有候选标签塞进提示词,本身就是一种工程简化。
小模型微调的真实边界
这个实验的结论不应被过度解读为"小模型全面超越大模型"。它成立的条件很具体:任务定义清晰、标签体系封闭、有高质量标注数据。在这类场景里,通用大模型的"广博"反而派不上用场,而专门训练的小模型可以精准命中。
反过来看,如果任务需要开放式推理、多步规划或跨领域知识整合,微调小模型的优势会迅速消退。真正务实的策略是按任务选模型:高频、结构化、标签有限的任务交给微调小模型,成本低、延迟低、可控性强;复杂推理任务继续交给前沿大模型。
从成本角度看,本次两组微调的训练成本都在几毛钱量级,相比持续调用闭源API的费用,规模化场景下的经济性差距会非常可观。对想验证这一路径的开发者来说,门槛已经低到几乎没有理由不去试一试。
相关推荐

Beni跟拍摄像机器人上手:4K 60p HDR+智能避障
Beni 跟拍摄像机器人亮相 YouTube:4K 60p HDR 成像、17.9 英里/小时最高速度、智能避障可跨越 10 英寸台阶,支持并行追踪、宠物尾巴追踪与 Orbit 环绕运镜,配手表遥控器,重新定义自动跟拍体验。

Gemini 4 Krypton曝光:性能逼近Fable 5.2价格更低
谷歌Gemini 4 Krypton曝光,性能逼近Fable 5.2而成本更低;Claude Code新增主题定制与多线程项目协作;Anthropic官方指南揭示选型真相:Opus 5.5日常使用性价比高于Fable 5.2。

AI周报:Gemini 4 Carbon翻车,24个新发布降本提速
本周AI圈24个新发布:Gemini 4 Carbon实战暴露长耗时与稳定度短板,Hydrogen轻量版降本提速,Decisions API、Muse Ember等低价批量接口与开源语音、视觉工具集体拉低AI使用门槛。