小数据分子生成:随机化什么比随机化多少更重要

仅随机化SAFE表示即可将低数据分子生成的新颖产率提升超450倍,且随机化维度选择比幅度更关键。
一项控制实验系统研究了低数据条件下分子生成模型的表示增强策略。研究者用1000个种子分子训练自回归序列模型,比较规范SAFE与随机化SAFE,并隔离原子顺序和片段顺序两个随机化轴。结果表明:仅随机化SAFE就能将真正新颖分子的产率提升超过450倍,使模型从复述训练集变为实用生成器;两个随机化轴存在强烈协同效应,双轴同时随机化的产率是各自单独贡献之和的四倍;在匹配语料和计算量下,随机化SAFE的真实产率是随机化SMILES的2.8倍。核心启示是:低数据生成中,选择随机化哪些表示维度比单纯增加随机化幅度更重要,实践者应优先采用支持片段级随机化的表示并同时启用两个轴。
训练数据只有一千个分子时,化学语言模型往往只会复述训练集,而学不到有用的生成分布。随机化SMILES增强通过改变原子遍历顺序来增加表示多样性,而SAFE(基于片段的序列表示)还能额外打乱片段块的顺序。这两种表示变化对低数据分子生成的影响此前缺乏系统研究。一项控制实验给出了明确答案:随机化SAFE表示本身就能将真正新颖分子的产率提升超过450倍,而随机化哪些维度比随机化多少更为关键。
实验设计:控制变量拆解随机化维度
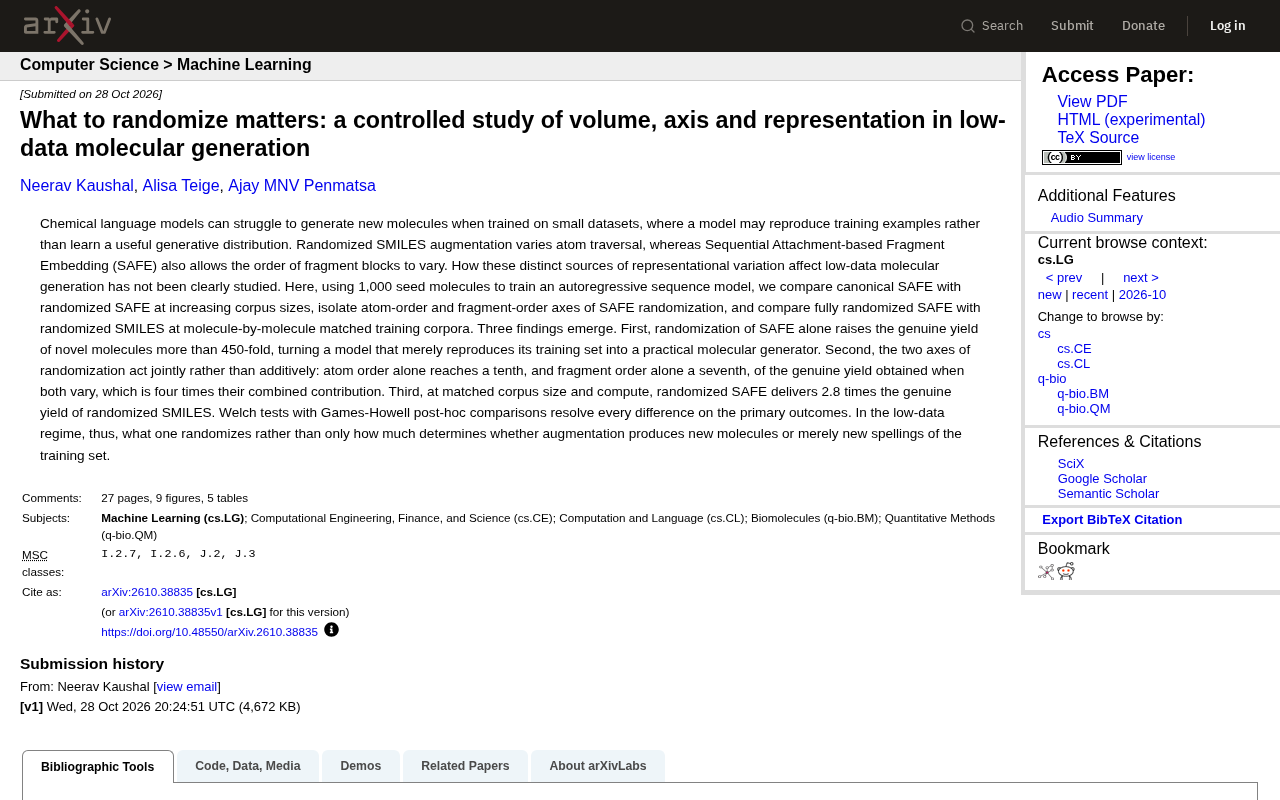
研究者用1000个种子分子训练自回归序列模型,在递增的语料规模下比较了规范SAFE与随机化SAFE,并进一步隔离出原子顺序和片段顺序两个随机化轴。为了公平对比,他们还构建了分子级匹配的训练语料,比较完全随机化SAFE与随机化SMILES。所有主要结果均通过Welch检验和Games-Howell事后比较进行统计验证,确保差异不是随机波动。这种“逐个分子匹配”的设计,排除了语料组成差异的干扰,让表示方式本身的效果得以凸显。
SMILES与随机化SMILES:SMILES(Simplified Molecular-Input Line-Entry System)是一种用线性字符串表示分子结构的文本格式,通过深度优先遍历分子图来生成原子和键的序列。同一分子因遍历起点和分支顺序不同可产生多种合法SMILES,这就是SMILES的随机化(randomized SMILES)——在训练时随机选择一种遍历顺序,从而增加同一分子的表示多样性。这种增强策略简单且广泛使用,但它只改变原子级别的序列顺序,不改变分子片段的组合方式。
SAFE表示与片段顺序随机化:SAFE(Sequential Attachment Fragment Encoding)是一种基于片段的分子序列表示,它将分子拆解为若干片段(如环、官能团),并记录片段间的连接关系。与SMILES不同,SAFE序列由片段块组成,因此除了可以随机化片段内原子的遍历顺序外,还能随机打乱片段块在序列中的排列顺序。这种双重随机化轴——原子顺序和片段顺序——为模型提供了更丰富的结构变化信号,是本研究关注的核心表示层增强手段。
发现一:仅随机化SAFE,产率跃升超450倍
最直接的结论是,对SAFE表示进行随机化,把模型从“复读机”变成了实用的分子生成器。在基线条件下,模型倾向于精确重现训练分子;而引入随机化后,真正新颖(非训练集内)分子的产率提高了450倍以上。这意味着,表示层的增强策略足以改变模型的行为模式,而不需要增加数据量或模型容量。对于只有少量已知分子的药物发现场景,这一提升具有实际意义——它让低数据条件下的生成式设计变得可行。
发现二:两个随机化轴协同作用,而非简单叠加
随机化并非“越多越好”的线性游戏。研究拆解了SAFE的两个随机化轴:原子顺序和片段顺序。单独随机化原子顺序,只能达到双轴同时随机化时真实产率的十分之一;单独随机化片段顺序,仅达到七分之一。而双轴同时变化带来的产率,是两者单独贡献之和的四倍。这说明两个轴之间存在强烈的协同效应:片段顺序的打乱可能改变了模型学习到的片段组合模式,而原子顺序的变化则增加了局部表示的多样性,两者共同作用才能释放最大的生成潜力。简单地增加随机化强度,不如选对随机化的维度。
协同效应(Synergy):在统计学和实验设计中,协同效应指两个或多个因素共同作用时产生的效果大于它们各自单独效果之和。本研究发现,原子顺序随机化和片段顺序随机化同时启用时,真正新颖分子的产率是两者单独贡献之和的四倍,表明二者并非独立叠加,而是相互增强。可能的机制是:片段顺序的打乱迫使模型学习片段之间的组合规律,而原子顺序的变化则增加了片段内部表示的多样性,两者结合使模型覆盖更广的生成空间,从而更有效地避免简单复述训练集。这一发现提示,在表示增强策略中,维度间的交互作用可能比单一维度的强度更为关键。
发现三:匹配语料下,随机化SAFE优于随机化SMILES
在语料大小和计算量匹配的条件下,随机化SAFE的真实产率是随机化SMILES的2.8倍。SMILES随机化只改变原子遍历顺序,而SAFE同时打乱片段块顺序,提供了更丰富的结构变化信号。这一对比直接回答了“表示形式是否重要”的问题:在低数据区间,选择哪种表示来施加随机化,比随机化的幅度更能决定生成结果的质量。对于实践者而言,这意味着在数据稀缺时,优先考虑基于片段的表示(如SAFE)并启用其完整的随机化能力,可能比单纯增加SMILES增强的多样性更有效。
实践启示:低数据生成应优先“随机化正确的维度”
这项研究传递的核心信息是:在低数据分子生成中,增强策略的设计需要从“随机化多少”转向“随机化什么”。原子顺序和片段顺序的协同效应表明,表示层面的结构性变化比单纯的序列扰动更有价值。对于使用化学语言模型的研究者和工程师,建议在数据有限时:第一,优先采用支持片段级随机化的表示(如SAFE);第二,同时启用原子顺序和片段顺序的随机化,而非只选其一;第三,在评估增强效果时,关注真正新颖分子的产率,而不仅仅是损失或困惑度指标。这些发现为小数据条件下的分子生成提供了一个低成本、高回报的优化方向。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。