XiaoWu语音输入法:本地大模型驱动,离线也能精准识别

当语音输入遇上本地大模型
语音输入法并不是什么新鲜事物,但大多数产品要么依赖云端服务存在隐私隐患,要么识别准确率差强人意。传统语音识别(ASR, Automatic Speech Recognition)主要依赖云端计算,如Google Speech-to-Text、讯飞等服务,语音数据需上传至远程服务器进行处理。这种模式虽然能利用大规模计算资源获得高准确率,但存在网络延迟、隐私泄露和断网不可用等问题。
事实上,ASR技术的发展经历了从基于隐马尔可夫模型(HMM)的统计方法,到深度神经网络(DNN-HMM混合架构),再到端到端(End-to-End)模型的三次重大范式转变。早期的端到端模型如DeepSpeech、Listen-Attend-Spell虽然简化了流水线,但对计算资源的需求使其只能部署在云端。2022年,OpenAI发布的Whisper模型成为一个重要转折点——它基于Transformer架构,使用68万小时的多语言标注数据训练而成,不仅在多个基准测试中达到了接近人类的识别准确率,更重要的是其开源特性和多种模型尺寸(从39M到1550M参数)的选择,使得在消费级设备上运行高质量语音识别首次成为现实。这一突破为完全离线的语音输入应用铺平了道路。
最近在B站上发现了一款名为 XiaoWu 的本地AI语音输入法,它的核心卖点非常明确:完全本地运行的大语言模型 + 极简交互设计。从演示效果来看,这款语音输入工具在识别精准度和使用体验上都有不少亮点,值得深入聊聊。
XiaoWu语音识别精准度:连标点符号都不放过
演示视频中,作者用一段日常对话进行测试——"我女儿今天问我说,妈妈我们暑假去哪玩呀"。从实际效果来看,XiaoWu 的表现有两个突出之处:
- 识别延迟极低:语音输入几乎是实时转文字,没有明显的等待时间
- 标点符号自动且精准:这一点尤为难得,很多语音输入法在标点处理上都是短板,而 XiaoWu 能够根据语义和停顿自动添加正确的标点
标点符号的精准处理背后,实际上是本地大语言模型在发挥作用。语音识别通常分为声学模型和语言模型两个阶段:声学模型负责将音频波形转化为音素或文字序列,而语言模型则负责对输出文本进行纠错、断句和标点添加。
要理解这两个阶段的分工,可以做一个类比:声学模型就像一个"听写员",它的任务是把听到的每一个音节忠实地记录下来,但它不关心整句话是否通顺、标点该放在哪里;语言模型则像一个"编辑",它拿到听写员的初稿后,根据语法规则、上下文逻辑和常识进行修正和润色。传统方案中,这个"编辑"通常是较轻量的N-gram模型(一种基于统计的语言模型,通过计算相邻N个词共同出现的概率来预测下一个词)或小型RNN(循环神经网络),它们的"编辑能力"有限——N-gram模型只能看到前几个词的局部上下文,RNN虽然理论上能处理长距离依赖,但在实践中容易出现梯度消失问题,对复杂句式的理解力不足。
而 XiaoWu 引入本地大语言模型(LLM)作为后处理层,相当于让GPT级别的模型对识别结果进行"校对"和"润色"。基于Transformer架构的LLM通过自注意力机制(Self-Attention)可以同时关注输入序列中任意位置的信息,其对上下文语义的理解能力远超传统语言模型,因此能更准确地判断句子的逻辑结构并添加恰当的标点符号。例如,"他说明天不来了"和"他说,明天不来了"在声学层面几乎没有区别,但LLM能通过对整句语义的理解来判断正确的断句方式。
这种"识别+理解"的双层架构,是它区别于普通语音输入法的关键所在。
极简交互设计:一个按键解决所有操作
在交互设计上,XiaoWu 走了一条极端简约的路线。演示中展示了两种使用场景,都体现了"最少操作"的设计哲学。
这种设计理念在人机交互(HCI)领域有着深厚的理论基础。认知心理学家提出的"希克定律"(Hick's Law)指出,用户做出决策所需的时间与可选项的数量呈对数关系——选项越多,决策越慢。而"菲茨定律"(Fitts's Law)则表明,点击目标的时间取决于目标的距离和大小。XiaoWu 将所有操作收敛到单一按键或单一鼠标按钮,本质上是将希克定律中的选项数降到最低,同时消除了在多个UI元素之间移动的菲茨定律开销。这种"零决策成本"的交互模式,对于语音输入这种需要用户注意力集中在"说话"本身而非"操作界面"的场景尤为重要。
键盘模式:一键完成录音与发送
在键盘操作模式下,录音、停止、发送等所有操作都映射到了同一个按键上。作者用了一个很形象的说法——"真正做到闭着眼都能聊天"。这种设计对于需要高频文字输入的场景(比如即时通讯)非常友好,省去了在多个按钮之间切换的认知负担。
鼠标模式:左键点哪聊哪
对于习惯用鼠标操作的用户,XiaoWu 同样提供了极简方案:全程只需鼠标左键。想和谁聊天,点击对应的聊天窗口即可,输入法会自动跟随焦点窗口。这在同时与多人聊天的场景下尤其实用,不需要额外的窗口切换操作。
本地大模型架构:隐私与智能兼得
XiaoWu 最值得关注的技术特性是其完全本地化的大语言模型架构。在数据隐私保护日益成为全球科技行业核心议题的当下——欧盟GDPR、中国《个人信息保护法》等法规对用户数据的收集和传输提出了严格要求——"Local-first"(本地优先)架构理念正逐渐兴起。
"Local-first"并非仅仅是一种技术选择,更是一种软件设计哲学。它的核心原则是:用户数据的所有权和控制权应始终归用户所有,软件应优先在本地设备上处理数据,只在用户明确授权时才进行网络传输。这一理念的兴起有多重驱动力:一方面是监管压力——GDPR规定了高达全球营业额4%的违规罚款,中国《个人信息保护法》将生物识别信息(包括声纹)列为"敏感个人信息",要求单独取得同意并进行影响评估;另一方面是技术可行性的提升——Apple的Core ML框架允许开发者将机器学习模型直接集成到iOS/macOS应用中并在Neural Engine上高效运行,Google的MediaPipe提供了跨平台的端侧AI解决方案,而llama.cpp等开源项目则让大语言模型在普通CPU上的推理成为可能。语音数据的特殊敏感性更强化了本地处理的必要性:声纹是一种不可更改的生物特征,一旦泄露无法像密码一样重置,且语音内容本身往往包含大量私密信息。
XiaoWu 采用的完全本地化方案正契合了这一趋势,语音这类高度敏感的生物特征数据在本地处理,从根本上消除了数据泄露的风险。
这意味着:
- 不依赖互联网:所有语音识别和文本处理都在本地完成,断网状态下也能正常使用
- 隐私安全有保障:语音数据不会上传到任何云端服务器,对于注重隐私保护的用户来说这是核心优势
- 上下文理解能力强:本地大模型能够智能理解对话的上下文语境,从而提升识别质量
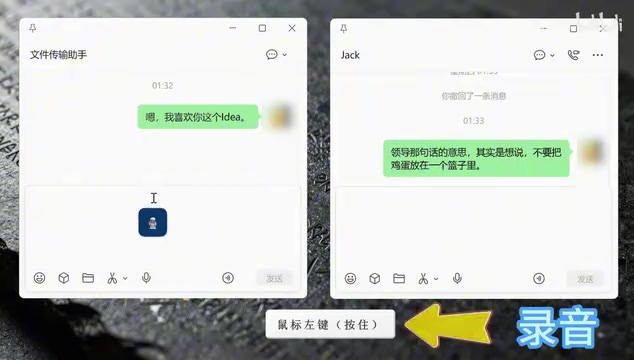
演示中有一个值得注意的例子:系统能够理解"领导那句话的意思其实是想说不要把鸡蛋放在一个篮子里"这样包含隐喻和转述的复杂语句,并正确地完成文字转写。这说明背后的本地大模型确实具备一定的语义理解深度,而不仅仅是简单的语音到文字的映射。
这类语句之所以对传统ASR系统构成挑战,是因为它涉及多个层面的语言复杂性:首先是转述结构("领导那句话的意思其实是想说……"),系统需要理解这是在复述他人的意图而非说话者本人的直接表达;其次是隐喻("不要把鸡蛋放在一个篮子里"),这是一个约定俗成的比喻表达,字面意义与实际含义完全不同。传统的声学模型+轻量语言模型的组合在处理这类语句时,往往会出现断句错误(如在"想说"后错误断句)或同音词替换错误。而LLM由于在海量文本语料上进行过预训练,已经"见过"大量类似的表达模式,能够利用其内部编码的世界知识和语言知识,正确理解句子的层次结构和语义意图,从而输出准确的文字转写结果。
安装与使用门槛
根据介绍,XiaoWu 支持一键安装,这对于本地大模型应用来说是一个重要的加分项。本地部署大模型通常涉及环境配置、模型下载、依赖安装等一系列繁琐步骤,能做到一键安装说明开发者在工程化和用户体验上下了不少功夫。
让大语言模型在个人电脑上流畅运行,离不开一系列模型压缩和优化技术。量化(Quantization)是其中最关键的手段,它将模型权重从32位浮点数(FP32)压缩为4位(INT4)或8位整数(INT8),内存占用可降低4-8倍。以一个7B参数的模型为例,FP32精度下需要约28GB内存,而经过INT4量化后仅需约3.5-4GB,这使得它能够在普通笔记本电脑的内存中运行。量化虽然会引入一定的精度损失,但研究表明,对于大多数自然语言处理任务,4-bit量化后的模型性能下降通常在1-3%以内,对用户体验的影响微乎其微。
此外,知识蒸馏(Knowledge Distillation)技术可以让小模型("学生模型")学习大模型("教师模型")的行为,通过模仿教师模型的输出概率分布而非仅学习硬标签,在参数量大幅缩减的情况下保持较高的任务表现。结合剪枝(Pruning,移除对输出贡献较小的神经元连接)和稀疏化(利用权重矩阵中大量接近零的值来减少计算量)等方法,当前1B-7B参数规模的模型已能在普通笔记本电脑上以可接受的速度运行。
目前主流的端侧LLM推理方案包括:使用GGUF格式(一种专为CPU推理优化的模型存储格式)的量化模型通过llama.cpp(由Georgi Gerganov开发的高性能C/C++ LLM推理引擎)在CPU上运行(通常需要8GB以上内存),或借助GPU加速(如NVIDIA显卡的CUDA、Apple Silicon的Metal)获得更快的推理速度。近期,MLX(Apple专为Apple Silicon优化的机器学习框架)和Ollama(提供一键部署本地LLM的工具)等项目进一步降低了本地模型部署的门槛。这些技术的成熟为XiaoWu这类本地AI应用提供了可行的技术路径,也是其能够实现"一键安装"并在消费级设备上流畅运行的技术基础。
不过,视频中并未详细提及对硬件配置的具体要求。运行本地大语言模型通常需要一定的GPU显存或较大的内存空间,这可能是潜在用户需要提前了解的问题。建议感兴趣的朋友前往作者B站主页查看置顶视频,了解完整的功能介绍和系统配置要求。
总结:本地AI输入法的务实探索
在AI工具层出不穷的当下,XiaoWu 选择了一个非常务实的切入点——把本地大模型的能力注入到最日常的语音输入场景中。它没有追求花哨的功能堆砌,而是聚焦在"精准识别"和"极简交互"两个核心体验上,这种产品思路值得肯定。
本地大模型输入法这个方向本身也很有想象空间。随着端侧AI算力的持续提升和模型压缩技术的进步,未来我们可能会看到更多类似的"本地AI+日常工具"的组合。从更宏观的视角来看,这代表了AI应用从"云端集中式"向"端云协同"乃至"端侧优先"演进的大趋势。高通、联发科等芯片厂商已在最新的移动和PC处理器中集成了专用的NPU(神经网络处理单元),Intel的Meteor Lake和Apple的M系列芯片也在持续增强端侧AI算力。当硬件层面的AI加速成为标配,像XiaoWu这样的本地AI应用将不再受限于"够不够算力"的问题,而是可以专注于"如何用好算力"来打造更优质的用户体验。XiaoWu 算是这一趋势中值得关注的早期实践者。
相关推荐
乌克兰堡垒带:俄罗斯为何难以拿下顿巴斯
基于军事分析访谈,解析俄乌战争中顿巴斯"堡垒带"的防御结构,梳理顿涅茨克城市群、扎波罗热与利曼方向的战线态势,分析俄罗斯推进受阻的深层原因。
《托马斯·克朗事件》预告片解析:当AI内容创作遇上经典悬疑
分析《托马斯·克朗事件》预告片的叙事技巧,探讨对话驱动、碎片化信息等手法对AI内容创作的启示,并讨论AI在视频理解中的应用潜力。
Qwen Code:终端里的开源AI编程智能体
Qwen Code 是 QwenLM 开源、用 TypeScript 编写的终端 AI 编程智能体,GitHub 星标近三万。本文介绍其终端原生定位、核心能力与适用场景,分析开源 AI 编程工具的发展趋势。