信息论安全聚合:异构量化下的联邦学习隐私新方案
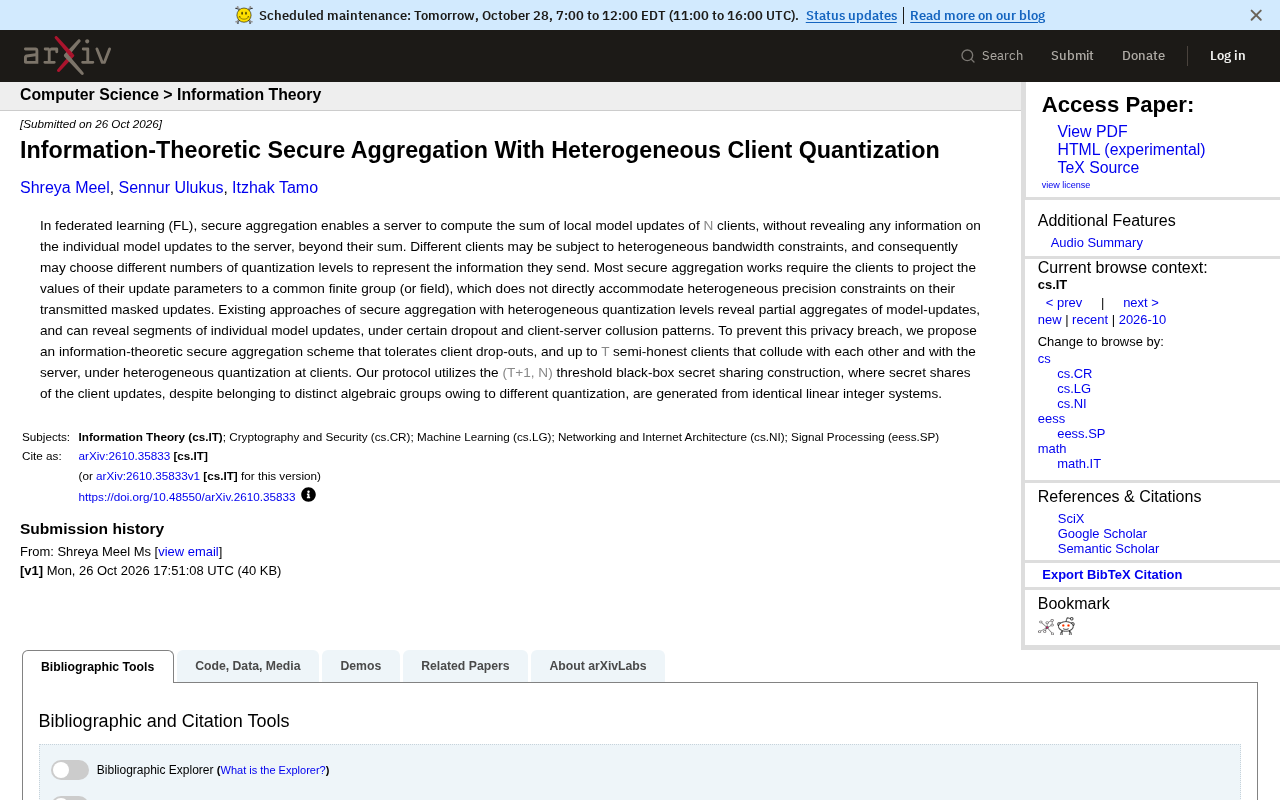
提出信息论安全聚合方案,支持异构量化并容忍掉线与共谋。
本文针对联邦学习中客户端因异构带宽采用不同量化级别导致传统安全聚合失效的问题,提出一种信息论安全聚合方案。现有异构量化方法会泄露部分聚合或单个更新片段,尤其在掉线和共谋场景下。新方案利用(T+1, N)阈值黑盒秘密共享构造,使不同量化级别(属于不同代数群)的秘密份额均由相同的线性整数系统生成,从而在聚合时正确组合。该方案容忍客户端掉线,并抵抗最多T个半诚实客户端与服务器共谋,提供信息论安全,不依赖计算假设。与现有方法相比,该方案在隐私保护上更严格,且适应异构带宽环境,但可能带来额外开销。
联邦学习(FL)中,安全聚合允许服务器计算N个客户端本地模型更新的总和,而不泄露任何单个客户端的更新信息(超出总和的部分)。然而,不同客户端可能受限于异构带宽,从而选择不同的量化级别来表示发送的信息。大多数安全聚合方案要求客户端将更新参数值投影到公共有限群(或域)上,这无法直接适应异构精度约束。现有异构量化安全聚合方法会泄露模型更新的部分聚合,并且在某些掉线和客户端-服务器共谋模式下可能泄露单个模型更新的片段。为预防这种隐私泄露,本文提出一种信息论安全聚合方案,容忍客户端掉线以及最多T个半诚实客户端与服务器共谋,同时支持客户端异构量化。该协议利用(T+1, N)阈值黑盒秘密共享构造,其中客户端更新的秘密份额尽管因量化不同而属于不同代数群,但均由相同的线性整数系统生成。
异构量化带来的安全聚合挑战
在联邦学习中,客户端的上传带宽差异显著,导致它们可能采用不同的量化级别来压缩模型更新。传统安全聚合方案通常要求所有客户端将更新值映射到同一个有限群(如整数模一个素数),以便进行秘密共享和聚合。这种统一性假设在异构量化场景下不再成立——不同量化级别产生的数值范围不同,无法直接纳入同一代数结构。
现有针对异构量化的安全聚合方法试图通过分组聚合或部分聚合来绕过这一限制,但代价是隐私的降级。具体而言,这些方法可能泄露部分聚合结果,甚至在客户端掉线或与服务器共谋时,泄露单个客户端更新的片段。这违背了安全聚合的核心目标:服务器除了总和之外,不应获得任何额外信息。
有限群与模运算:在安全聚合中,有限群通常指整数模一个素数 (p) 构成的加法群 (\mathbb{Z}_p),其元素个数有限且每个非零元素有乘法逆元(若考虑乘法群)。将模型更新投影到有限群上,即把实数或整数参数映射为 (\mathbb{Z}_p) 中的元素,从而可利用群运算进行秘密共享和同态聚合。不同量化级别会产生不同的数值范围(例如 8-bit 量化范围是 ([-128,127]),而 4-bit 是 ([-8,7])),若强行统一到同一个 (p),则低精度客户端的值可能被“放大”或高精度客户端的值可能溢出,破坏正确性。因此,异构量化要求每个客户端使用与其量化范围匹配的模数,导致秘密份额属于不同的代数群,传统基于单一 (\mathbb{Z}_p) 的安全聚合协议无法直接组合这些份额。
信息论安全聚合方案的核心设计
为应对上述挑战,论文提出了一种信息论安全聚合方案。该方案的关键创新在于利用(T+1, N)阈值黑盒秘密共享构造,使得即使客户端使用不同的量化级别(即秘密份额属于不同的代数群),也能从相同的线性整数系统中生成秘密份额。
具体而言,每个客户端将其量化后的更新向量编码为一个整数向量,然后通过一个线性整数系统生成秘密份额。这些份额虽然属于不同的群(取决于量化级别),但系统设计保证了在聚合时能够正确组合。服务器收齐至少T+1个客户端的份额后,可以恢复出总和,而任何少于T+1个份额的组合不会泄露任何信息。
该方案容忍客户端掉线,并且能够抵抗最多T个半诚实客户端与服务器的共谋。半诚实模型意味着这些客户端会遵守协议但可能试图从收到的信息中推断其他客户端的隐私。方案的安全性基于信息论,不依赖计算假设,因此即使攻击者具有无限计算能力也无法破坏隐私。
黑盒秘密共享与线性整数系统:黑盒秘密共享指将秘密共享方案视为一个黑盒,只利用其线性性质(份额是秘密的线性函数)进行组合,而不依赖具体构造(如 Shamir 或 replicated secret sharing)。在线性整数系统中,每个客户端的秘密份额可表示为 (s_i = a_i \cdot x + b_i) 的形式,其中 (x) 是量化后的更新向量,(a_i, b_i) 是整数系数。即使不同客户端的量化级别不同(即 (x) 的取值范围不同),只要所有份额都来自同一个线性系统(系数相同或满足相容性),服务器仍可通过线性组合恢复总和。((T+1, N)) 阈值意味着至少 (T+1) 个份额才能重建秘密,而任意 (T) 个份额不泄露任何信息,这为抵抗最多 (T) 个半诚实客户端与服务器共谋提供了信息论保证。
与现有方法的对比及优势
与现有异构量化安全聚合方法相比,该方案在隐私保护上更为严格。现有方法在特定掉线模式或共谋模式下会泄露部分聚合或单个更新片段,而该方案在所有允许的掉线和共谋模式下均保持信息论安全。
此外,该方案不要求客户端统一量化级别,从而更好地适应实际联邦学习中的异构带宽环境。客户端可以根据自身带宽条件独立选择量化级别,而不会影响聚合的安全性和正确性。
半诚实模型与信息论安全:半诚实(honest-but-curious)模型假设所有参与方严格遵守协议步骤,但可能根据收到的中间信息推断其他方的隐私。信息论安全(又称无条件安全)指即使攻击者拥有无限计算能力,也无法从密文或份额中获取任何关于秘密的信息,其安全性不依赖于计算困难问题(如离散对数)。在安全聚合中,信息论安全通常通过秘密共享的阈值性质实现:少于阈值个份额与随机数不可区分,因此服务器即使与最多 (T) 个客户端共谋,也无法获得任何单个客户端更新的额外信息。这与基于计算假设(如 Diffie-Hellman)的方案形成对比,后者在量子计算面前可能失效。
实际应用与未来方向
该方案适用于对隐私要求极高的联邦学习场景,例如医疗、金融等领域,其中客户端设备可能具有不同的网络条件。信息论安全性提供了更强的隐私保证,但可能带来一定的通信或计算开销。论文未具体讨论开销的量化指标,但指出方案基于黑盒秘密共享构造,具有实际可行性。
未来工作可能包括优化秘密共享的效率,以及探索在更复杂的共谋模型(如恶意客户端)下的安全性。
注:本文基于论文摘要撰写,具体技术细节请参考原文。
相关推荐
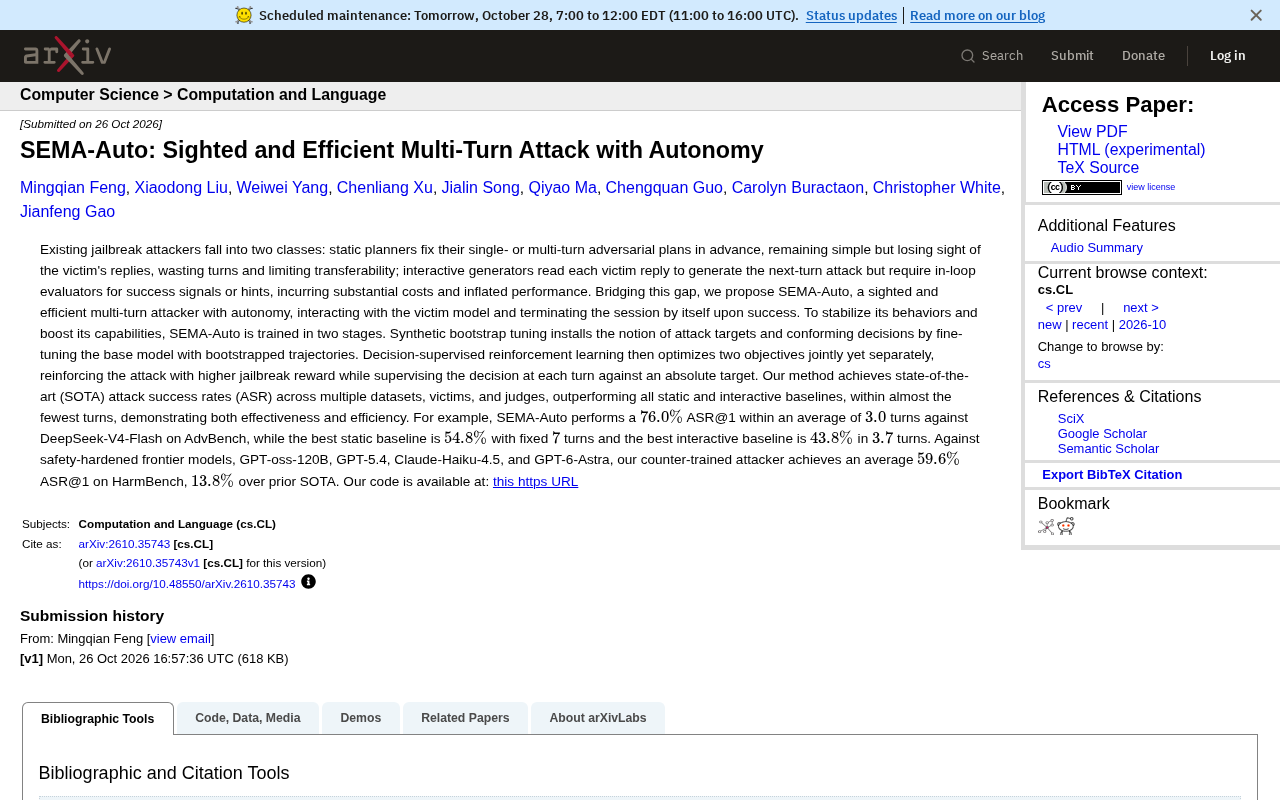
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
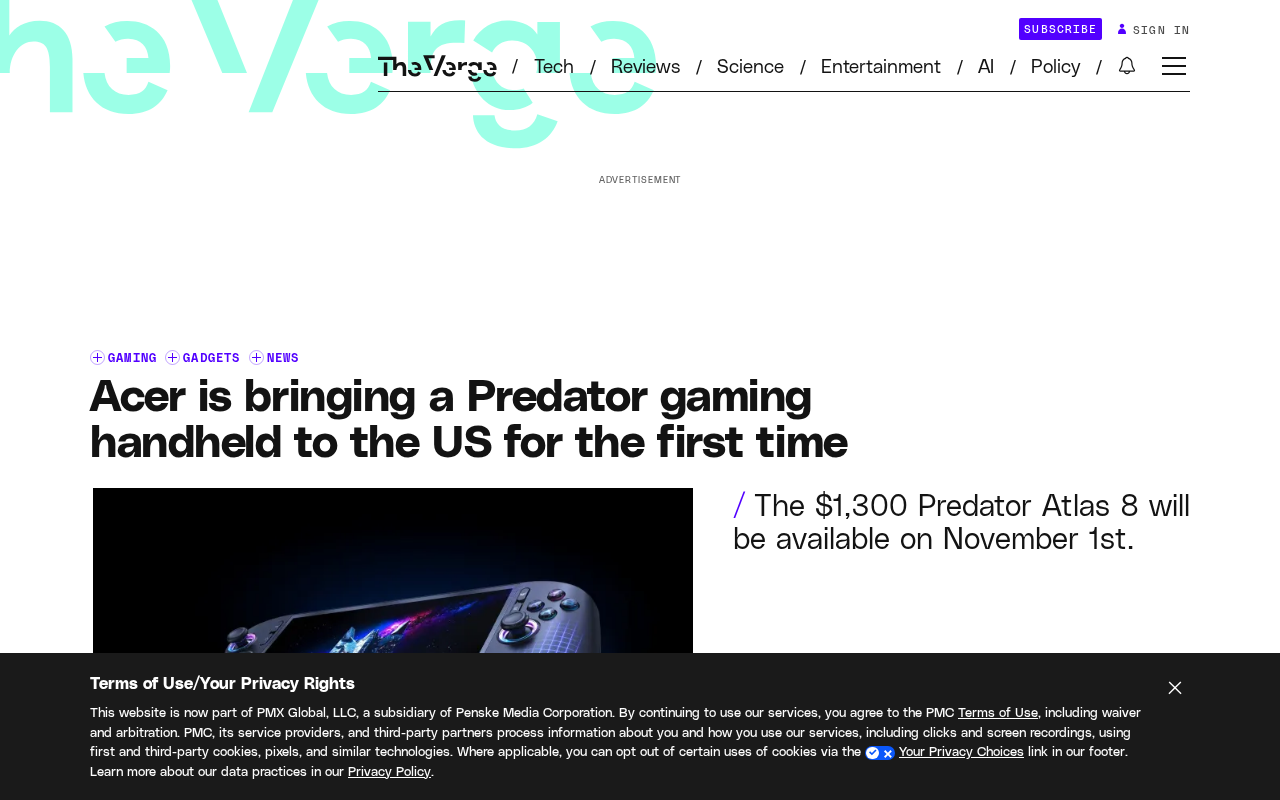
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。