幸存者偏差:LLM研究创意评测中被忽视的基线陷阱
LLM创意评测中,用已发表论文对比模型原始输出,可能因幸存者偏差严重高估人类与AI的差距。
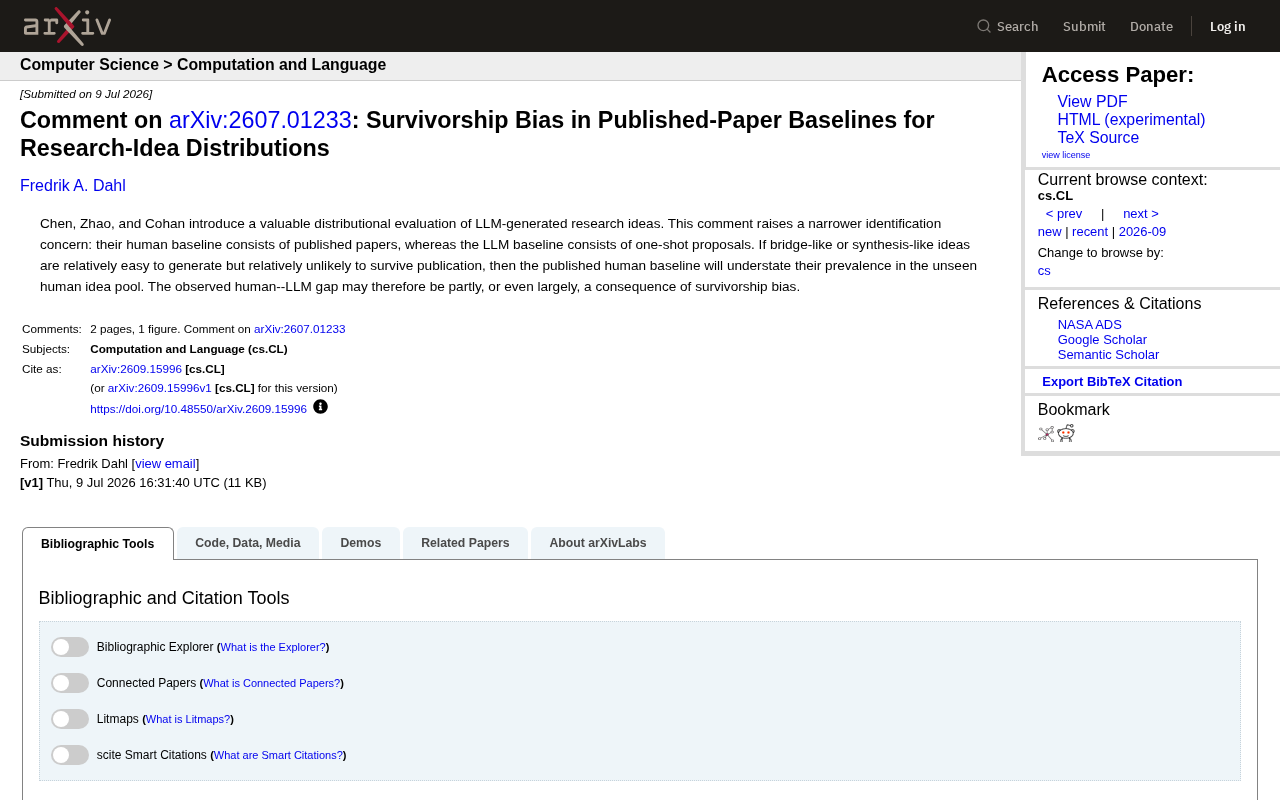
一篇arXiv评论文章对「大语言模型生成研究创意」的分布式评测提出了方法论质疑:原研究以已发表论文为人类基线、以模型一次性提案为LLM基线,但两者的筛选路径根本不对等。已发表论文是经过实验验证、同行评审、多轮修改层层淘汰后的「幸存者」,而LLM输出是未经任何筛选的原始集合。评论者进一步指出,桥接型和综合型创意因发表门槛高而在人类基线中系统性缺席,导致人类基线低估了真实的人类创意多样性。由此,两者之间观察到的分布差异,可能相当程度上来自采样机制的不对等,而非真实能力差距。这一案例揭示了AI能力评测中一个普遍性的方法论陷阱:基线的可比性往往比评测指标本身更能决定结论的可信度。
一个看似严谨的评测背后的隐忧
近期一篇发表在 arXiv 上的评论文章(arXiv:2609.15996)对 Chen、Zhao 和 Cohan 关于「大语言模型生成研究创意」的分布式评测提出了一个尖锐而具体的质疑。这项被评论的原始研究试图从统计分布的角度衡量 LLM 生成的科研想法与人类科研想法之间的差异,本身被评论者认为是「有价值的」贡献。然而,评论文章指出,这项评测在基线构建上可能存在一个被忽视的系统性偏差——幸存者偏差(Survivorship Bias)。
这个质疑的核心并不否定原研究的方法论价值,而是聚焦于一个更狭窄但关键的「识别问题」(identification concern):当我们把人类的研究创意和 LLM 的研究创意放在一起比较时,我们究竟在比较什么?如果两边的样本本身就来自不同的筛选机制,那么观察到的差异有多少是真实的能力差距,又有多少只是采样方式造成的假象?
基线不对等:已发表论文 vs 一次性提案
评论文章揭示的问题结构清晰。在原研究中,人类基线由已发表的论文构成,而 LLM 基线则由模型的**一次性提案(one-shot proposals)**构成。这两者在生成与筛选路径上有着本质区别。
已发表的论文经历了漫长而严苛的筛选:从最初的想法萌芽,到实验验证、同行评审、多轮修改,最终只有一小部分创意能够「幸存」并进入公开发表的池子。相比之下,LLM 的一次性提案没有经过任何这样的淘汰过程——它们是模型直接输出的原始想法集合。
换句话说,人类的基线是「幸存者」,而 LLM 的基线是「全体参赛者」。用经过重重筛选的人类精华,去对比未经筛选的 LLM 原始产出,这样的比较从起点上就不在同一条基准线上。
幸存者偏差(Survivorship Bias)这一概念最早因二战时期的飞机装甲研究而广为人知:统计学家亚伯拉罕·沃尔德指出,研究者只分析了安全返航的飞机弹孔分布,却忽略了被击落、永远无法返回的飞机——而后者恰恰携带着最关键的信息。这一思维方式被广泛迁移到科学研究中:当我们只能观察到「成功案例」时,对总体的判断就会系统性地偏向乐观或偏向特定模式。在学术发表领域,这一偏差尤为隐蔽:期刊和会议的接受率普遍偏低(顶级AI会议往往低于20%),大量研究成果因无法发表而沉入「文件抽屉」,从未进入任何评测的视野。这意味着「已发表文献」这一数据集,天然地不代表研究者实际产出的全部创意,而是一个经过严格社会性筛选的精英子集。
桥接型创意为何最容易「消失」
评论文章进一步给出了一个具体的机制假设,让幸存者偏差的问题变得可检验。作者指出,某些类型的创意——具体来说是**桥接型(bridge-like)或综合型(synthesis-like)**的想法——可能相对容易被生成,却相对不容易在发表环节中存活下来。
这一点在科研实践中并不难理解。跨领域桥接或综合性质的创意,往往因为难以在单篇论文中充分验证、不符合某个细分领域的评审偏好,或者被认为「新意不足」而在同行评审中被淘汰。它们容易被想到,却很难被发表。
如果这个假设成立,那么后果就非常直接:已发表的人类基线会系统性地低估这类创意在真实(但不可见的)人类创意池中的实际占比。人类脑海中冒出的桥接型想法可能很多,但它们大多没能变成论文,因而从未进入评测的视野。
「桥接型(bridge-like)创意」指跨越两个或多个原本相互独立的研究领域、将其方法或概念加以联结的想法,例如将计算机视觉技术迁移至基因组学,或用经济学博弈论框架重新解释免疫系统动态。这类想法的生成门槛相对较低——对多个领域有基本了解的研究者乃至语言模型,都容易产出「A领域的方法能否用于B领域」这类联想。然而,这类创意在发表环节却面临独特障碍:投稿时难以明确归属于某个细分领域的期刊或会议,评审人往往专精于单一领域而对跨界贡献的新颖性持保守态度,且单篇论文的篇幅难以对两个领域都做出足够深入的验证。这种「生成容易、发表困难」的非对称性,正是幸存者偏差在创意类型层面的具体表现机制。
人类与LLM的差距,可能是采样假象
把上述逻辑串联起来,评论文章得出了一个引人深思的结论:原研究观察到的人类与 LLM 之间的差异,可能部分甚至很大程度上是幸存者偏差的产物,而非两者创意生成能力的真实反映。
如果 LLM 在生成桥接型、综合型创意上表现「过剩」,而人类基线又恰好把这类创意大量过滤掉了,那么两个分布之间的差距就会被人为放大。研究者可能会误以为 LLM 的创意分布「异常」或「与人类不同」,但真相可能只是:人类同样能产出这些创意,只是这些创意没能挺过发表的筛选。
这提醒我们,在评估生成式 AI 的创造力时,基线的选择与两侧样本的可比性,往往比评测指标本身更能决定结论。一个设计精巧的分布式评测,如果建立在不对等的基线之上,其结论的解释空间就会大打折扣。
对AI能力评测的方法论启示
这场围绕 arXiv 论文的学术讨论,虽然聚焦于一个具体的技术细节,却触及了当前 AI 评测领域的普遍性难题。随着 LLM 被越来越多地用于科研创意生成、假设提出等高阶认知任务,如何公平地衡量它们与人类的差距,成为一个方法论上的关键挑战。
评论文章给出的启示至少有几层:其一,比较双方的样本必须经历可比的筛选流程,否则「幸存者偏差」会悄然扭曲结论;其二,对于人类创意池这样「不可见」的整体,研究者需要格外警惕仅用「已发表」这一可见切片来代表全貌;其三,任何声称发现「人类—AI 差距」的研究,都应当把差距的可能来源(能力差异 vs 采样差异)拆解清楚。
值得肯定的是,这类以评论(comment)形式出现的学术对话,正是科学自我修正机制的体现。它没有推翻原研究,而是通过一个精确的识别问题,推动整个领域对评测设计的严谨性提出更高要求。对于关注 AI 科研能力评估的从业者来说,这个「幸存者偏差」的视角值得纳入未来的实验设计考量。
「识别问题」(Identification Problem)是计量经济学与因果推断领域的核心概念,指研究设计是否能够将目标效应(此处为人类与LLM的真实能力差距)从其他混淆因素(此处为采样机制差异)中干净地分离出来。当识别问题未能得到妥善处理时,即便统计检验显著、样本量充足,结论的因果解释仍可能失效。在AI评测领域,这一问题尤为突出,因为研究者往往不得不用「可观测的人类产出」(如发表论文、竞赛答案、标注数据)作为人类能力的代理,而这些代理天然带有各种社会性和机构性筛选的印记。未来更严格的评测设计或许需要借鉴随机对照实验的思路,例如直接收集研究者在发表决策之前的原始创意记录,以构建与LLM输出真正可比的人类基线。
相关推荐
Grist移除社区版SSO功能:开源软件的"SSO税"争议再起
Grist在v1.7.18版本更新中移除了社区版的SSO单点登录功能,将其锁定至付费层级,引发"SSO税"争议。本文分析该事件、开源软件商业化困境及对自托管用户的启示。
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。