XLA编译器正确性验证:TPU大规模工作负载的实战方法

工业界论文分享超大规模下XLA:TPU编译器缺陷的验证与分类系统方法。
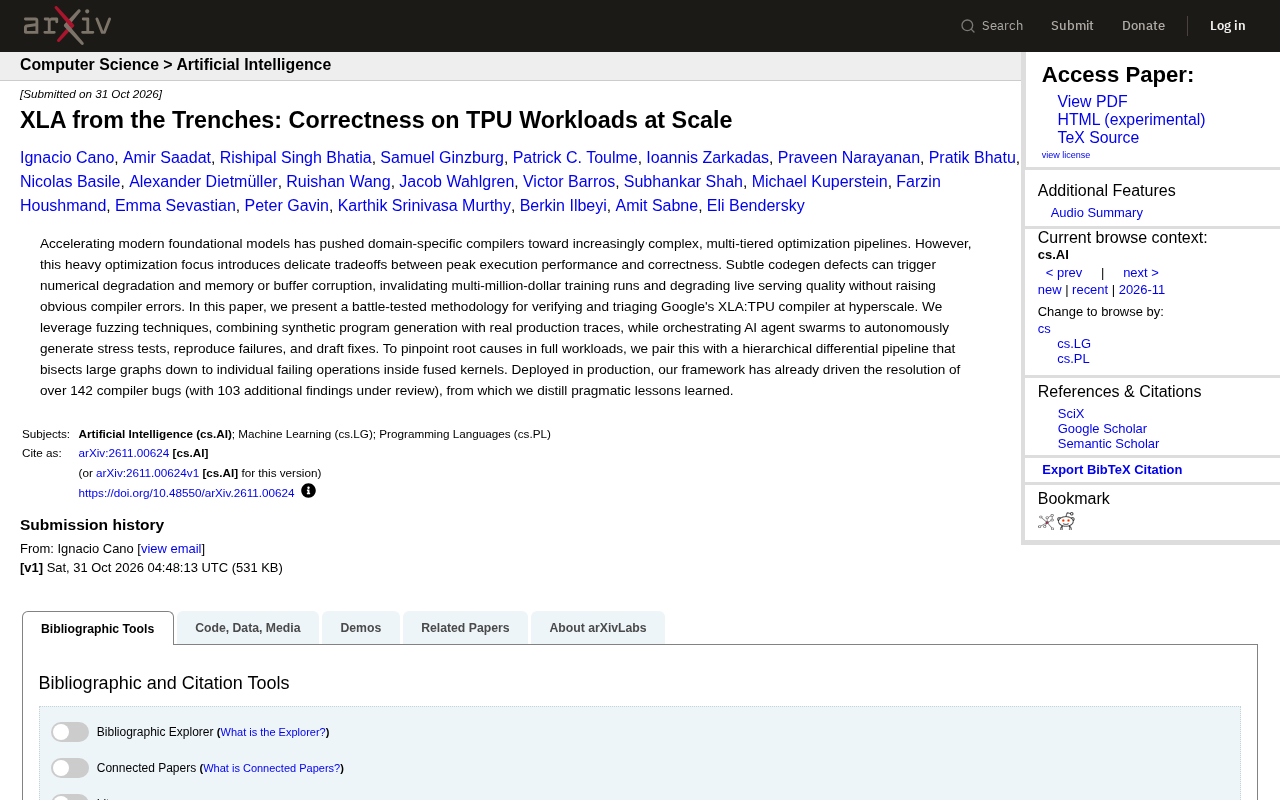
本文基于工业界实践论文,探讨在超大规模场景下验证和分类XLA:TPU编译器问题的系统方法。XLA编译器在代码生成中的细微缺陷可能导致数值退化或内存损坏,且不触发编译错误,威胁数百万美元的训练任务。研究团队采用模糊测试,结合合成程序与真实生产迹,并利用AI代理集群自主生成压力测试、复现失败并起草修复方案。层次化差分流水线通过二分大图定位到融合内核中的单个失败算子,加速根因分析。该框架已在生产环境部署,推动142个编译器缺陷修复,另有103个待审核。经验表明,编译器正确性验证需与性能优化同步,AI代理有效但仍需人工监督。
现代基础模型的加速需求,将领域特定编译器推向了日益复杂的多层优化流水线。然而,对峰值性能的极致追求,也在正确性上引入了微妙的权衡。XLA 作为 Google 为 TPU 等硬件设计的编译器,其代码生成中的细微缺陷可能引发数值退化或内存/缓冲区损坏,导致数百万美元的训练任务失效,或在不触发明显编译错误的情况下降低线上服务质量。本文基于一篇来自工业界的实践论文,探讨在超大规模场景下验证和分类 XLA:TPU 编译器问题的系统方法。
为什么 XLA 的正确性在规模化下尤为棘手
XLA 的核心价值在于将高级计算图转化为针对特定硬件(如 TPU)的高效机器码。这一过程涉及图优化、算子融合、内存规划等多个阶段,每个阶段都可能引入不易察觉的缺陷。在超大规模部署中,这类缺陷的破坏力被急剧放大:一次错误的融合可能让训练损失异常飙升,或者一个缓冲区越界可能污染结果却不立即崩溃。传统的单元测试和人工审查难以覆盖如此庞杂的优化组合。
论文指出,这些“代码生成缺陷”通常不会抛出编译错误,而是表现为数值精度下降或内存损坏,排查难度极高。因此,需要一套专门针对编译器正确性的验证与分类方法,而不是依赖事后调试。
XLA(Accelerated Linear Algebra) 是 Google 开发的开源领域特定编译器,最初为 TensorFlow 设计,现已成为 JAX、PyTorch/XLA 等框架的后端。它将高级计算图(如矩阵乘法、归约、广播)转换为针对特定硬件(TPU、GPU、CPU)的优化机器码。其核心优化包括算子融合(将多个小算子合并为一个内核以减少内存访问)、内存规划(静态分配缓冲区以复用内存)、布局优化(选择最佳数据排列)等。XLA 的编译过程分为 HLO(高级优化)、LLO(低级优化)等多个阶段,每个阶段都可能引入缺陷。由于 XLA 通常以即时编译(JIT)方式在训练循环中频繁触发,其正确性直接关系到模型训练的数值稳定性和内存安全。
模糊测试与 AI 代理集群:压力测试的自动化
研究团队采用模糊测试(fuzzing)作为核心手段,将合成程序生成与真实生产迹(production traces)相结合。合成程序可以探索编译器优化路径的极端情况,而真实迹则确保测试贴近实际负载形态。这种混合策略能够覆盖人工编写测试难以触及的组合。
更引人注目的是,他们利用 AI 代理集群自主生成压力测试、复现失败并起草修复方案。AI 代理在这里扮演了“测试工程师”的角色,持续产出高价值的测试用例,并加速从失败到根因定位的循环。这种自动化闭环显著提升了发现缺陷的效率。
模糊测试(Fuzzing) 是一种自动化测试技术,通过生成大量随机或半随机的输入来触发程序中的异常行为。在编译器测试中,模糊测试通常生成符合语法规则的合成程序(如随机组合的算子图),并检查编译结果是否与预期一致(如通过差分测试对比不同优化级别下的输出)。生产迹(Production Traces) 则是指从真实生产环境中捕获的编译器输入记录,通常包含实际模型的计算图结构和参数。将两者结合,既能探索编译器优化路径的极端情况(合成程序),又能确保测试负载贴近真实场景(生产迹),从而发现那些仅在特定优化组合下才会暴露的缺陷。这种混合策略已成为工业级编译器验证的常见实践。
层次化差分流水线:从大图到融合内核的细粒度定位
定位编译器缺陷的根因往往比发现缺陷更难。一个大型计算图中的错误可能源自某个融合内核中的单个算子。论文提出了一种层次化差分流水线:通过逐层二分大图,将问题范围缩小到具体的失败算子,即使该算子位于复杂的融合内核内部。这种方法类似于软件调试中的二分查找,但针对的是计算图的结构和编译阶段。
在实际操作中,团队会对比不同优化级别或不同编译路径下的行为差异,利用差分测试来隔离出触发缺陷的最小条件。这种系统化的定位方式,比起凭经验猜测,大幅缩短了修复周期。
差分测试(Differential Testing) 是一种通过对比同一程序在不同配置下的行为来发现缺陷的技术。在编译器验证中,常见的做法是:将同一计算图分别用不同优化级别(如 O0 与 O3)、不同编译路径(如启用/禁用算子融合)或不同后端(如 XLA:TPU 与参考实现)编译执行,然后比较输出结果。若结果存在显著差异,则说明某一配置下存在缺陷。层次化差分流水线 进一步将这一思想应用于计算图的结构层次:先对比整个图的输出,若不一致,则通过二分法将图拆分为子图,逐步缩小范围,直至定位到具体的失败算子或融合内核。这种方法特别适合定位那些仅在特定融合模式下才出现的数值错误或内存越界问题。
生产部署成效与经验总结
该框架已在生产环境中部署,并推动了超过 142 个编译器缺陷的修复(另有 103 个发现正在审核中)。这一数据来自论文摘要,反映了该方法在真实超大规模场景下的有效性。团队从中提炼出若干实用经验,例如:优先关注数值稳定性和内存安全相关的缺陷模式;将模糊测试与生产迹结合可以更快暴露高影响问题;AI 代理在生成多样化测试方面表现突出,但仍需人工监督以确保测试质量。
这些经验对于其他领域特定编译器(如针对 GPU 或其他加速器的编译器)的验证工作同样具有参考价值。随着基础模型规模持续增长,编译器正确性验证将不再是附属任务,而是保障训练与推理可靠性的关键环节。
对行业的影响与启示
XLA 正确性验证的实践揭示了一个趋势:编译器测试正在从手写用例转向自动化、智能化的压力测试。AI 代理的引入不仅提升了测试覆盖率,还改变了缺陷修复的工作流。对于依赖 TPU 进行大规模训练的企业而言,投资于编译器正确性验证工具链,可能比单纯追求峰值性能更有长期价值。毕竟,一次悄无声息的数值错误足以让昂贵的训练成果付诸东流。
论文的方法论也提示我们,正确性验证需要与性能优化同步进行,而不是事后补救。在编译器开发的早期阶段融入模糊测试和差分测试,可以帮助尽早发现那些在后期难以定位的深层缺陷。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。