选AI推理服务商,开发者最看重什么?
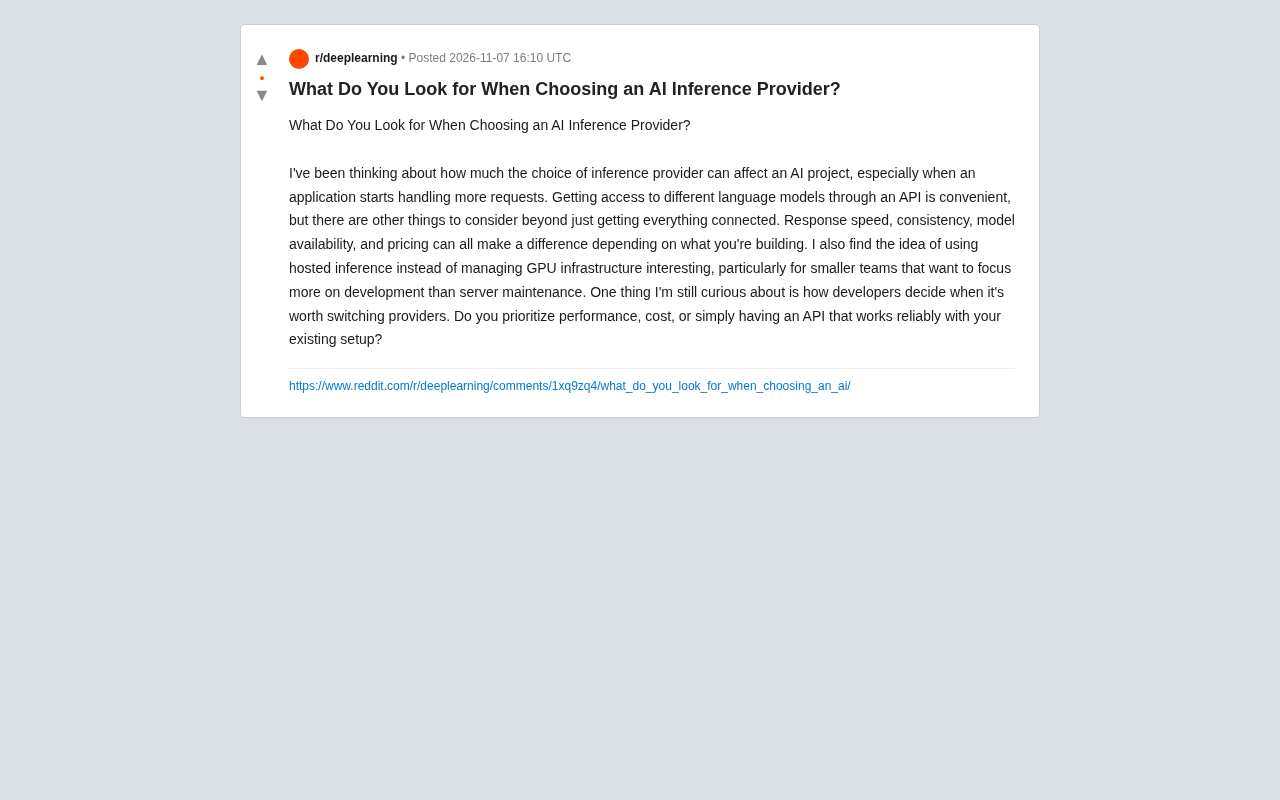
Reddit讨论引出AI推理服务商选择的多维权衡:性能、成本、集成与运维。
文章从一条Reddit提问出发,探讨开发者选择AI推理服务商时的核心考量。作者指出,性能不只是响应速度,还涉及首token延迟、吞吐量、长期稳定性和输出一致性;定价不能只看每token价格,集成摩擦和工程时间是隐性成本;托管推理让小团队免于GPU运维,但请求量大或有数据驻留要求时自建仍有优势。切换服务商的务实信号包括延迟超标、错误率上升、成本结构失衡和供应商锁定风险。文章结论是这一领域尚无通用最佳实践,开发者需结合自身场景摸索优先级。
从一条Reddit提问说起
最近Reddit上有个讨论挺有意思:一位开发者发帖问,大家在选择AI推理服务商时到底看重哪些因素?他提到,当应用开始处理更多请求时,推理服务商的选择会显著影响项目表现。通过API接入不同语言模型很方便,但响应速度、稳定性、模型可用性和定价都会因项目类型而异。他还特别提到,对小型团队来说,用托管推理替代自建GPU基础设施很有吸引力,这样可以把精力更多放在开发上而不是服务器维护上。
这个提问触及了AI应用落地时一个很实际的问题:模型能力之外,推理层的基础设施决策同样关键。
性能不只是“快”
发帖人把响应速度放在第一位,但实际选择中,“性能”是个多维概念。首token延迟影响交互体验,吞吐量决定并发能力,而长时间运行下的稳定性则关系到服务可用性。不同服务商在这些指标上的表现可能差异很大,开发者往往需要根据自己的场景做取舍。比如聊天应用对首token延迟敏感,批量处理任务则更看重吞吐和成本。
另一个容易被忽视的点是一致性。同一个模型在不同服务商那里,输出质量可能因为量化策略、推理优化或版本更新而出现波动。对于依赖模型输出稳定性的产品,这种差异需要纳入评估。
首token延迟(TTFT)与吞吐量(TPS) 是衡量推理服务性能的两个关键但常被混淆的指标。首token延迟指从发送请求到收到第一个输出token的时间,它直接决定用户感知的“响应速度”,对聊天、实时助手等交互式场景至关重要。吞吐量则指单位时间内服务能处理的请求数或生成的token总数,影响并发能力和单位成本。两者往往存在权衡:激进的批处理(batching)可提升吞吐,但可能增加单个请求的排队时间,从而拉高首token延迟。此外,量化(将模型权重从FP16压缩至INT8/INT4等低精度)能显著降低显存占用和推理成本,但可能引入输出质量波动;不同服务商的量化策略和推理引擎优化程度不同,这正是同一模型在不同平台表现不一致的重要原因。
成本结构与隐性开销
定价是绕不开的因素,但单纯比较每token价格并不够。发帖人提到“定价会有影响”,实际决策中还要看计费粒度、免费额度、阶梯定价以及突发流量时的成本弹性。托管推理省去了GPU采购和运维人力,这对小团队是实打实的成本转移。
不过隐性开销也值得注意:如果服务商的API与现有技术栈集成成本高,或者需要额外做适配层,工程时间就会转化为隐性成本。发帖人特意提到“API能否可靠地与现有设置配合工作”,这其实是在问集成摩擦有多大。
托管推理 vs 自建GPU:小团队的权衡
发帖人对托管推理的兴趣集中在“让团队专注开发而非服务器维护”。这确实是托管方案的核心卖点:无需管理GPU集群、驱动、扩缩容和故障恢复。对于没有专职基础设施人员的小团队,这能显著降低起步门槛。
但自建也不是没有理由。当请求量足够大、或者对数据驻留和定制化有硬性要求时,自建GPU在长期成本和可控性上可能更有优势。发帖人没有给出具体阈值,但点出了一个关键判断:什么时候值得切换服务商?这个问题没有标准答案,取决于团队规模、增长预期和对运维复杂度的容忍度。
托管推理指由服务商负责GPU资源调度、模型部署、扩缩容和故障恢复,开发者仅通过API调用;自建GPU则需团队自行采购或租用GPU实例,并管理推理框架(如vLLM、TGI)、驱动、监控和容灾。托管方案将固定资本支出和运维人力转化为按用量计费的变动成本,适合请求量波动大或缺乏基础设施专员的团队。自建的优势在于对数据驻留、模型定制和底层优化的完全控制,且当请求量持续高位时,单位token的边际成本可能更低。数据驻留(data residency)要求数据存储在特定地理区域,金融、医疗等行业常因此排除部分托管服务商。决策的关键在于评估“运维复杂度”与“成本可控性”的平衡点。
切换服务商的决策信号
发帖人最后的好奇是:开发者如何决定何时换服务商?从讨论语境看,优先级排序因人而异。有人把性能和可靠性放在成本之前,有人则把“API能稳定配合现有系统”作为底线。比较务实的做法是设定几个可观测的触发条件:延迟持续超出可接受范围、错误率上升影响用户体验、成本结构随用量增长变得不合理,或者模型可用性无法满足产品路线图。
另一个信号是供应商锁定风险。如果API抽象层做得足够薄,切换成本就低,团队可以更灵活地根据性价比调整;反之,深度绑定特定服务商的特性会让迁移变得昂贵。发帖人没有深入这一点,但“与现有设置可靠配合”的表述暗示了集成深度会影响切换意愿。
供应商锁定(vendor lock-in)指应用深度依赖某服务商的专有API、SDK或特性后,迁移到其他平台需要付出高昂的改造代价。降低锁定风险的常见做法是在应用与推理服务之间加一层薄抽象层(如统一封装多家API的网关),使切换只需修改配置而非重写业务代码。评估锁定风险时,可关注:API是否遵循OpenAI兼容等通用标准、是否依赖服务商独有的微调或缓存机制、以及数据导出和迁移的便利性。抽象层越薄,团队越能根据性价比灵活调整,但过度抽象也可能损失服务商提供的性能优化特性。
没有唯一答案的选择题
这条Reddit提问没有给出结论,但它把推理服务商选择的几个核心维度摆了出来:性能、一致性、模型可用性、定价、集成成本和运维负担。对小型团队而言,托管推理降低了基础设施门槛,但选择哪家服务商仍然需要结合自身场景做权衡。发帖人的问题本身也说明,这个领域还没有形成通用最佳实践,开发者更多是在实际项目中摸索自己的优先级排序。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today