学习非精确交替最小化:神经网络加速凸优化求解

用神经网络近似交替最小化的子问题,理论保证下实现5-30倍加速。
本文针对变量块间具有二次耦合的凸优化问题,提出学习式非精确交替最小化:用神经网络在每次迭代中直接近似内层子问题的解,以一次前向传播替代昂贵的迭代求解。作者推导了最优性间隙的最坏情况上界,将其分解为随迭代衰减项与网络近似误差项,从而指明每个网络应以贪心方式最小化当前迭代误差;结合PAC-Bayes论证,进一步得到实例分布上期望间隙的固定时域高概率界。在鲁棒矩阵补全与带字典正则化的低剂量CT重建中,匹配精度下比非精确一阶基线加速5至13倍,端到端微调后加速比达30倍并优于其他学习式方案。代码已开源。
交替最小化是求解两个耦合变量块优化问题的标准工具,但其计算成本主要受限于内层子问题求解器,而这些子问题往往没有闭式解。本文提出学习一种非精确交替方案,用神经网络在每个迭代中近似子问题的解。针对变量块之间具有二次耦合且满足二次增长条件的凸问题,作者推导了最优性间隙的最坏情况界,该界揭示了每个网络以贪心方式训练时应最小化的每次迭代误差。结合该界与PAC-Bayes论证,得到了在问题实例分布上期望最优性间隙的固定时域、高概率界。作者将学习到的方案应用于鲁棒矩阵补全和带字典正则化的低剂量CT重建,在匹配精度下比非精确一阶基线实现了5倍至13倍的加速。一个简短的端到端微调阶段可将加速比提升至30倍,并优于其他学习方案。代码已在GitHub上开源。
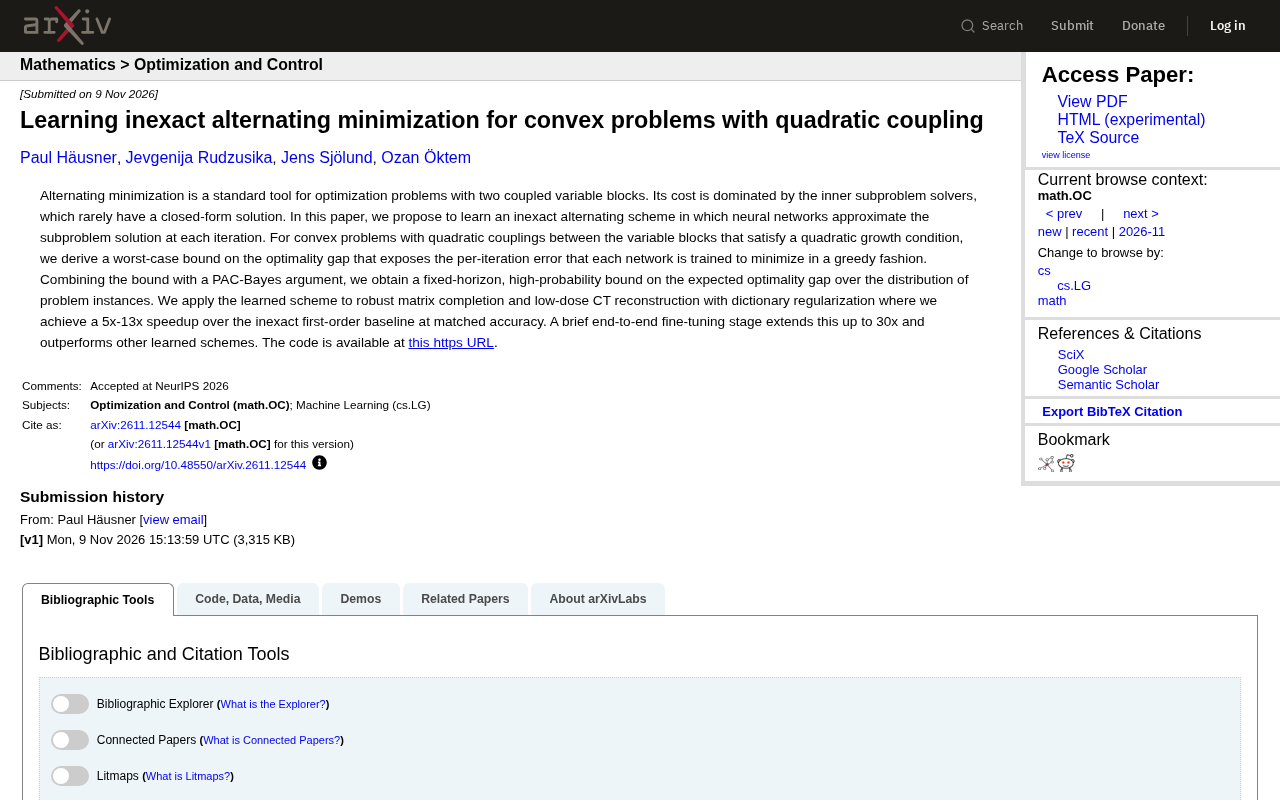
交替最小化的瓶颈与学习式方案
交替最小化(Alternating Minimization)是处理双变量块耦合凸优化问题的经典方法,在矩阵补全、图像重建等领域应用广泛。其每次迭代需分别固定一个变量块,求解关于另一个变量块的子问题。然而,这些子问题通常没有闭式解,需借助迭代算法(如梯度下降)近似求解,构成了整体计算的主要开销。
本文的核心思路是用神经网络替代传统的子问题求解器,直接学习从当前迭代状态到子问题近似解的映射。这种“学习式非精确交替方案”在保持交替框架的同时,将内层迭代替换为一次网络前向传播,从而大幅降低单次迭代成本。
二次耦合指目标函数中两个变量块之间存在形如 (\frac{\rho}{2}|Ax - By|^2) 或 (x^\top C y) 的交叉项,使得固定一个块后关于另一个块的子问题仍是一个(通常带线性项的)二次规划。这种结构在矩阵补全(低秩因子分解)和字典学习等模型中极为常见。二次耦合的特殊性在于:子问题的海森矩阵不依赖于待求变量,因此最优性间隙可以显式地用耦合算子与子问题残差表达,这正是本文能推导出最坏情况界的关键前提。相比之下,一般非线性耦合下子问题的条件数随迭代变化,难以得到紧的误差传播界。
二次增长条件(quadratic growth)是优化中比强凸更弱的假设:目标函数在最优解附近满足 (f(x) - f^\star \ge \mu \cdot \mathrm{dist}(x, X^\star)^2),即函数值以二次速率控制到最优解集的距离。它允许目标函数在远离最优解处非凸或平坦,只要求局部有二次下界。该条件广泛用于分析非凸问题的收敛速率,本文借助它把每次迭代的网络近似误差转化为最优性间隙的衰减,从而避免了对全局强凸性的依赖。
理论保障:最优性间隙界与PAC-Bayes分析
学习式方案的有效性需要理论支撑。作者针对变量块间具有二次耦合的凸问题,在满足二次增长条件的前提下,推导了最优性间隙的最坏情况上界。该界清晰地分解为两部分:一部分随迭代衰减,另一部分则与每次迭代中网络近似误差相关。这一分解直接指明了每个网络的训练目标——以贪心方式最小化当前迭代的近似误差,从而保证整体收敛性。
进一步,作者将上述确定性的界与PAC-Bayes理论结合,得到了在问题实例分布上期望最优性间隙的固定时域、高概率界。这意味着,学习到的方案不仅在单个实例上有保证,在未见过的实例分布上也有泛化能力。这一分析为学习式优化算法提供了严谨的统计学习视角。
PAC-Bayes 是一种基于后验分布的泛化界框架:给定先验 (P) 和数据相关的后验 (Q),它以高概率界定期望风险与经验风险之差,界的形式为 (\mathbb{E}{Q}[\text{risk}] \le \mathbb{E}{Q}[\text{empirical risk}] + \sqrt{(\mathrm{KL}(Q|P) + \ln(1/\delta))/(2n)})。与VC维等组合界不同,PAC-Bayes 对神经网络这类过参数化模型仍能给出非平凡界,且界显式依赖训练所用分布。本文把每个学习到的子问题求解器视为随机网络(权重服从后验分布),用 PAC-Bayes 控制其在实例分布上的平均近似误差,再与确定性的误差传播界复合,得到端到端的最优性间隙泛化界。
固定时域界(fixed-horizon bound)指迭代次数 (K) 事先固定、不随数据变化时的界。它与“任意时间”界相对:后者需对全部迭代取并集界,导致对数因子;固定时域则只需控制 (K) 个误差项的和,界更紧。本文的界对每个 (K) 成立且概率一致,因而可直接用于指导训练轮数与网络容量的权衡。
实验验证:矩阵补全与低剂量CT重建
作者将学习式交替最小化应用于两个实际问题:鲁棒矩阵补全和带字典正则化的低剂量CT重建。在匹配精度下,学习式方案相比非精确一阶基线方法实现了5倍至13倍的加速。这一提升主要来源于神经网络避免了内层迭代的重复计算。
此外,作者引入了一个简短的端到端微调阶段,将所有网络联合优化,进一步将加速比提升至30倍,并超越了其他学习式方案。这表明,贪心逐网络训练与端到端微调的结合能充分释放学习式交替方案的潜力。
开源与展望
总体而言,这项研究在理论分析与实际加速之间取得了良好平衡,展示了学习式方法在经典优化算法中的巨大潜力。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。