AI论文同行评审之痛:截止日期后的模型凭什么成扣分理由?

一条Reddit吐槽,戳中了多少研究者的痛处
在AI研究者聚集的Reddit社区,一条关于ACL Rolling Review(ARR)同行评审的帖子引发了广泛共鸣。发帖者分享了自己论文遭遇的评审经历:一位审稿人给出最低的1分,而首条批评意见竟然是——"应该尝试模型X",然而这个模型X,是在论文投稿截止日期之后才发布的。
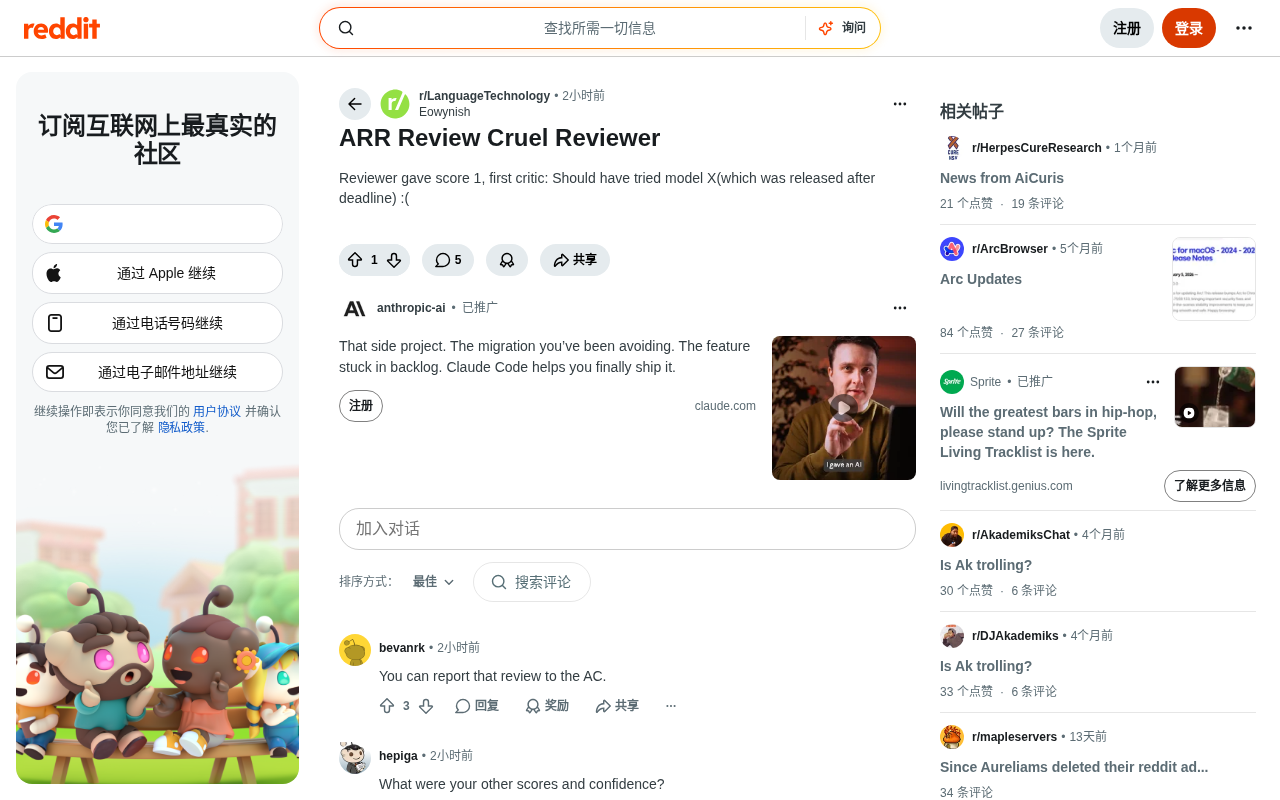
这条看似简单的吐槽背后,折射出当前AI学术界一个日益尖锐的结构性问题:在技术迭代速度以"周"甚至"天"为单位的今天,传统同行评审机制正面临严峻挑战。要求研究者对比投稿之后才出现的新模型,不仅违背学术评价的基本逻辑,更是对研究者劳动的一种漠视。
为什么这是一个真实的痛点
AI技术迭代速度已远超评审周期
ARR(ACL Rolling Review)是自然语言处理领域于2021年推出的集中式评审系统。值得深入了解的是,ARR的诞生本身就是对传统评审模式低效问题的一次制度性回应。在ARR之前,ACL、EMNLP、NAACL、EACL等旗舰会议各自独立运营评审流程,同一篇论文被拒后需重新提交至另一会议、从零开始评审,审稿人资源被反复消耗,作者也需承受多轮漫长等待。ARR通过统一的OpenReview平台实现评审结果的跨会议复用——论文在ARR完成评审后,作者可将带有评审意见的稿件提交至多个会议的选文委员会(Commitment),理论上一次评审即可覆盖多个投稿机会。
ARR依托OpenReview平台运行,这一平台是MIT媒体实验室与麻省大学阿默斯特分校联合开发的开源学术评审基础设施。OpenReview的设计理念是通过程序化API管理论文提交、评审分配、意见存储与跨会议数据共享,其核心技术优势在于支持评审结果的结构化复用——审稿人评分、意见文本及作者rebuttal均以标准化JSON格式存储,可被不同会议的选文委员会直接调阅,无需重复录入。ARR每两个月开放一次投稿窗口(即Cycle),形成滚动式评审节奏,区别于传统会议单一截止日期的"突击式"模式。然而这种滚动机制也带来了时间信息的模糊化:论文可能在某一Cycle完成评审后等待数月才被提交至具体会议,评审基准时间点因此难以被清晰界定,为"要求对比新模型"的争议埋下了制度性隐患。整个流程从投稿到最终决定可能长达4-6个月,反而放大了"技术被追赶"的风险。
作为计算语言学和自然语言处理领域的核心评审系统,ARR的完整评审周期通常需要数周乃至数月。而在生成式AI爆发的当下,新模型、新方法几乎每周都在涌现——GPT系列、Llama系列及各类开源模型的更新节奏,使任何一篇论文在评审期间都可能面临"被追赶"的困境。
然而核心问题在于:研究者只能基于投稿时可获得的技术开展实验。若审稿人以"未对比某个更新模型"为由压低评分,本质上是在用一个投稿者根本无法满足的标准来裁量工作,既不公平,更打击研究积极性。
评审标准的根本错位
一篇论文的核心价值,在于方法论创新、实验设计的严谨性以及所解决问题的重要性,而非是否囊括了所有最新出现的对比基线。将"是否使用最新模型"作为主要评判依据,折射出部分评审者对研究本质的误读——把"跑赢SOTA榜单"等同于"具有科研价值"。
SOTA(State-of-the-Art,当前最优性能)文化是深度学习时代特有的学术现象,其形成与深度学习革命的兴起密不可分。2012年AlexNet在ImageNet图像识别竞赛上的突破性表现,开创了以标准化基准评估模型性能的研究范式,证明了"可量化比较"在推动领域进步方面的价值。此后NLP领域的GLUE(2018)、SuperGLUE(2019)等综合性基准进一步强化了这一趋势,研究者发现,在权威排行榜上占据前列位置能够显著提升论文录用率和引用量,由此形成了以"刷榜"为核心的发表激励结构。随着这些标准化基准的普及,研究者形成了一种以"刷榜"为核心的竞争惯例——论文若不能在某个基准上超越前人,往往难以被顶会接收。这一文化有其合理性:标准化评测使不同方法可横向比较。然而其负面效应同样显著:研究者被迫将大量计算资源用于边际性能提升,真正具有方法论原创性但暂时性能落后的工作遭到系统性压制;"未能超越最新SOTA"成为部分审稿人拒稿的默认理由,即便该SOTA在投稿后才出现。这种风气本质上是将工程优化与科学发现混为一谈。
事实上,许多具有长远影响力的研究,其贡献恰恰在于提出新视角或新框架,而非在某个基准上刷出最高分数。《Attention Is All You Need》(Vaswani等,2017)的案例在学术评审改革讨论中具有标志性意义。该论文最初在NeurIPS 2017投稿时,部分评审者对其在机器翻译之外的泛化能力持保留态度,认为其未能在所有任务上全面超越当时的循环神经网络(RNN)基线。然而Transformer架构随后成为BERT(2018)、GPT系列、T5等几乎所有现代大语言模型的核心基础,其被引次数超过10万次,成为深度学习史上影响力最深远的论文之一。这一历史案例反复被研究者援引,用以说明"能否碾压当前SOTA"是一个极为短视的评价维度——真正的架构创新往往需要数年才能显现其全部价值,而过于强调即时性能比较的评审文化,可能系统性地压制了具有范式转换潜力的基础性工作。
同行评审机制的深层困境
评审质量参差不齐
AI顶会投稿量近年呈指数级增长,NeurIPS、ACL、EMNLP等会议的年投稿量动辄上万篇——NeurIPS 2024收到超过15,000篇投稿,ACL系列会议年均投稿总量亦突破万篇。这一数字背后是深刻的结构性矛盾:AI领域的研究者群体正在以前所未有的速度扩张,但具备高质量评审能力的资深研究者数量增长远为缓慢。
面对万级别的投稿量,顶会通常采用基于关键词匹配、TPMS(Toronto Paper Matching System)语义相似度计算或双向偏好申报的混合算法进行评审分配。TPMS通过分析审稿人历史发表论文与待评稿件的文本相似度,自动推荐领域匹配的审稿人,是目前NeurIPS、ACL等主要会议广泛采用的自动化分配工具。然而算法匹配并不能解决总量不足的根本矛盾:以NeurIPS 2024为例,15,000篇投稿若按每篇三位审稿人计算,需要45,000人次评审工作量,而实际活跃评审者池规模远低于此。部分会议已尝试引入大语言模型辅助评审(如AI-assisted review),用于初步筛查明显不符合投稿要求的稿件,但这一做法在学术伦理层面引发了关于"机器评价科学工作"的深层争议,尚未形成行业共识。
评审本身属于无薪志愿性工作,在学术晋升体系中几乎不计入考核,资深研究者参与评审的动力因此受到明显抑制。为填补缺口,会议不得不大规模引入博士生甚至低年级研究者担任审稿人,大量缺乏经验的评审者被纳入评审池。这直接导致评审质量的高度不均衡,"随意打分"、"不读全文"、"提出不合理要求"等现象,早已成为社区公开讨论的议题。
给出1分却只提出一条站不住脚的批评意见,正是评审不负责任的典型表现。合格的同行评审应当全面阅读论文、评估贡献与不足,并给出建设性意见,而非以一个时间上根本不成立的理由"一票否决"。
申诉与制衡机制不完善
大多数评审系统提供rebuttal(作者反驳)环节,但实际效力相当有限。Rebuttal机制最早由计算机视觉顶会CVPR等引入,旨在给予作者就误解或不实批评进行澄清的机会,这一设计理念值得肯定。然而,多项针对NeurIPS、ACL等会议的实证研究揭示了令人警惕的现实:提交rebuttal的论文与未提交的录用率差异在统计上并不显著;研究表明,超过80%的审稿人在rebuttal后不会实质性更改评分。这背后存在多重原因:审稿人未必重新认真阅读作者回复;领域主席(Area Chair,AC)工作负荷过重,难以对每一起争议进行深入仲裁;评审系统也缺乏强制要求审稿人回应rebuttal的机制。部分会议已尝试引入"审稿人必须确认已阅读rebuttal"的强制步骤,但执行效果仍有争议。
申诉能否真正撼动不合理评分,很大程度上取决于领域主席的介入意愿。当评审意见明显失当——例如要求对比截止日期后才发布的模型——作者理应有清晰、有效的渠道让此类意见被认定为无效,而非只能默默接受。然而现行机制对作者的实质保护仍然薄弱,这正是社区呼吁改革的核心诉求之一。
改进同行评审的可行方向
明确评审时间基准
评审指南应当清楚规定:评价论文时,对比基线和相关工作的范围以投稿截止日期为界。审稿人不得要求作者对比截止后才出现的方法。这一原则看似常识,却需要被写入正式规范并严格执行,才能真正产生约束力。部分领域已开始探索"快照式"评审标准——即在投稿系统中自动记录截止日期,并将该时间戳作为评审参照基准的法定节点,为规范的制度化落地提供技术支撑。
引入评审质量反馈机制
越来越多的会议开始尝试元评审(meta-review)和评审者评级。给出低质量、不负责任评审的审稿人,应被记录并影响其未来评审资格。只有让评审者承担相应责任,才能从根本上改善评审生态。ICLR的开放评审模式(Open Review)是这一方向的重要实践:评审意见和作者回复均公开可见,社区监督机制在一定程度上对评审质量形成了外部约束,为其他会议提供了可借鉴的参照路径。值得注意的是,ICLR的开放评审制度自2013年创立以来积累了大量公开评审数据,研究者已利用这些数据开展了多项关于评审偏见、评分一致性与录用决策模式的系统性分析,为评审机制的循证改革提供了宝贵的实证基础。这些数据还揭示了一个值得关注的现象:审稿人初始评分与最终录用结果之间的相关性往往高于rebuttal后修改评分与最终结果的相关性,进一步印证了改善"第一印象"质量的重要性。
社区共识与文化建设
类似的Reddit讨论本身,也是一种健康的社区自我纠偏。当研究者公开分享不合理的评审经历,实际上是在推动整个社区形成更理性的评审文化——研究的价值,不应被"军备竞赛式"的模型对比所绑架。ACL、NeurIPS等主要会议已陆续在官方评审指南中加入关于"公平评价研究贡献"的表述,但从规范文本到实际执行之间,仍需要持续的社区文化建设来填补落差。
结语
这条简短的吐槽之所以引发广泛共鸣,是因为它触及了AI学术界一个普遍存在却常被忽视的痛点。在技术狂飙突进的时代,学术评价体系需要在严谨与公平之间找到平衡。要求研究者预知并对比"未来才出现的模型",无异于缘木求鱼。
完善评审规范、提升评审质量、建立有效的制衡机制,是AI学术共同体必须直面的课题。唯有如此,才能让真正有价值的研究得到应有认可,让研究者的心血不被一个失职的评分随意埋没。
核心要点
核心要点
核心要点
核心要点
相关推荐

如何打造个人AI评测基准:5步选对适合你的大模型
新模型平均11天就发布一个,公开跑分却越来越不可信。本文详解AI Daily Brief研讨会提出的个人AI评测基准5步法:选任务、定候选、盲测、AI裁判、做决定,教你判断哪个大模型真正适合自己的工作流。

LTT时隔七年完成2004旗舰PC改造:老硬件遇上现代水冷
LTT时隔七年完成2004年旗舰PC改造,用EK定制水冷打造Intel 875平台老机器。涵盖Northwood CPU、AGP显卡、IDE接口等经典硬件知识与现代兼容性挑战,是一次PC硬件文化的致敬。
实测Jev:只做决策不写文字的AI模型,比GPT便宜65倍
深度实测AI决策模型Jev:它不生成文本,只返回带概率的结构化决策,运行成本比GPT-5.5低65倍。通过工单路由、命令守卫、千条真实消息四项测试,解析其优势、局限与模型级联省钱策略。