亚马逊AGI实验室开源感知智能体:让AI看懂屏幕

亚马逊AGI实验室开源视觉标注与验证原语,让Agent看懂屏幕并闭环改代码。
亚马逊AGI实验室在AI Engineer大会上阐述了感知智能体的设计哲学:让Agent像人类一样理解屏幕内容,而非仅做坐标点击,从而解锁大量有屏幕但无API的知识工作场景。团队开源了两个核心原语——浏览器扩展形式的视觉标注工具,以及可装入编码Agent的视觉验证技能,二者均不依赖模型推理、输出确定性结果。配合Nova Act与编码Agent,可将前端设计反馈到代码合并的周期从数周压缩到数小时。Bee可穿戴设备进一步展示了语音对话直接触发界面修改的新交互。团队强调可靠性是一等公民,50%可用的Agent等于不可用。
亚马逊AGI实验室开源感知智能体:让AI看懂屏幕
当大多数AI Agent还在依赖API接口完成任务时,亚马逊AGI实验室(Amazon AGI Lab)选择了一条更接近人类工作方式的路——让智能体直接「看懂」屏幕。在AI Engineer大会上,该团队不仅系统阐述了感知智能体(Perception Agents)的设计哲学,还开源了两个核心工具,并现场演示了从语音指令到代码变更的完整闭环。
感知智能体:超越「盲点点击」的计算机使用
亚马逊AGI实验室负责人Emil Bazel将团队定位为「结合初创速度与亚马逊规模的前沿研究与产品团队」,专注于构建能够在多种环境中感知、推理和行动的知识工作智能体。
传统计算机使用(Computer Use)能力让Agent能够点击屏幕上的按钮、填写表单,本质上是将视觉界面当作可操作的坐标平面。但Emil指出,这只是故事的一半:「我们希望Agent理解屏幕上看到的内容,就像人类一样。」他举了一个生动的例子:给任何人一个90年代末的Hotmail或Yahoo邮箱界面,即便从未使用过,也能凭直觉找到发送邮件的方法——这种跨越具体产品的界面理解能力,正是感知智能体追求的目标。
这一能力的价值在于解锁大量「有屏幕但无API」的工作场景。大量知识工作至今仍由人类通过浏览器和桌面软件完成,感知智能体让自动化得以延伸到这些领域。
Nova Act与两个开源原语:标注与验证
据Emil介绍,团队此前发布的Amazon Nova Act是构建在AWS上的第一方服务,开发者可用自然语言驱动浏览器工作流——填表、搜索、提取数据、购物比价,并支持人工介入(human-in-the-loop)与工具调用。控制台可回放Agent的完整轨迹,包括它关注的屏幕元素边界框。
本次工作坊的重点是两个已开源的感知智能体原语(primitives):
视觉标注(Visual Annotation)
这是一个Chrome扩展,允许用户直接在网页上圈选、点击或放置图钉来标注修改意见。完成标注后点击导出,会生成包含所有变更描述的JSON文件及一段提示词,可直接交给编码Agent执行。Emil特别强调,该工具与模型推理无关,输出完全确定性,不绑定任何模型。
视觉验证(Visual Verification)
这是一个可安装于Claude或Kiro等编码Agent的「技能」(skill)。团队将设计规范和用户流程写成Gherkin文件,验证技能会驱动浏览器逐项检查网站是否符合设计稿的颜色、字号与交互流程,并生成报告。首次运行时,工具会对网站做一层浅爬取,自动生成用户流程作为后续验证的基准。
Gherkin 是一种用于行为驱动开发(BDD)的领域特定语言,以自然语言风格的 Given/When/Then 结构描述软件行为。例如「Given 用户位于登录页,When 输入正确凭据,Then 应跳转到首页」。它的价值在于让非技术人员也能读懂和编写测试场景,同时可被 Cucumber 等工具自动执行。亚马逊团队将其用于视觉验证,实质是把「设计规范与用户流程」转译成机器可读的断言集合,使验证技能有了明确的判定基准,而非依赖模型主观判断页面是否「看起来对」。
MCP(Model Context Protocol) 是 Anthropic 提出的开放协议,用于让 AI 应用以标准化方式连接外部工具与数据源,常被类比为「AI 应用的 USB-C 接口」。文中提到的 Jam MCP 即遵循该协议,把浏览器控制台日志、网络请求等调试信息封装为可被代理调用的工具,再转发给 Nova。理解 MCP 有助于把握这套工作流的扩展逻辑:感知智能体本身处理「看屏幕」,而 MCP 负责把屏幕之外的可观测数据接入模型,两者互补。
从反馈到合并:一条被压缩到数小时的工作流
工作坊主讲人Shruti Arora用一个前端工程师的角色扮演串联起整套工具的价值。传统流程中,设计评审、Slack反馈收集、逐条修改代码往往耗时数周;接入编码Agent后缩短到数天。而如果反馈可以被Agent直接消费——标注完成后自动触发代码修改、再自动跑视觉验证——这个周期可以压缩到「去喝杯咖啡回来就完成了」。
据现场演示,完整链路需要打通Chrome扩展与编码Agent之间的「Agent Bridge」,并修改扩展的manifest与content脚本以支持本地请求和「应用更改」按钮。演示中,主讲人将发布日期改为当天日期,点击应用后,编码Agent自动接管修改;随后Nova Act的日志实时展示了模型的思考过程与屏幕决策点,最终输出验证报告。
工作坊设置了两条路径:简单模式按步骤跑通两个原语,中等模式则要求参与者自行将两个原语串联成完整闭环。
当可穿戴设备加入:语音即代码变更
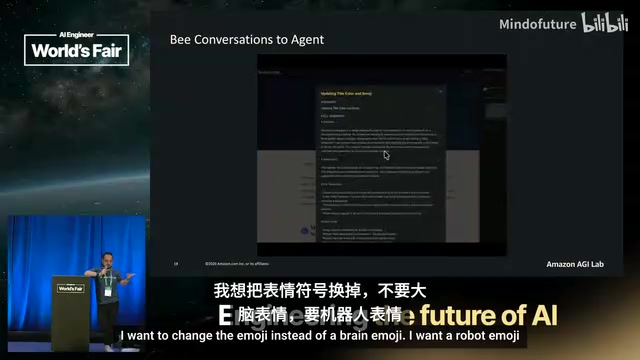
亚马逊的Bee可穿戴设备为这套工作流提供了另一种输入方式。团队成员Giovanni演示了将Bee的对话摘要接入感知智能体:在模拟设计讨论中说出「把标题改成红色」「把大脑emoji换成机器人」,对话转录与要点会出现在侧边面板,点击应用后即触发网站修改与自动验证。
现场参与者还展示了其他扩展思路:一位Wharton学生将Bee与自建的GTD(Getting Things Done)项目管理工具Sidekick结合,希望把会议中的想法自动归入对应项目;另一位金融公司从业者则尝试用Jam MCP捕获控制台日志与网络请求,经代理转发给Nova,让非技术同事用自然语言描述界面修改需求。
可靠性:50%可用的Agent等于不可用
Emil在开场引用了一位客户的评价:「如果你的Agent只有50%的时候能工作,那它就等于完全不工作。」原因很直接——用户要么不敢运行它,要么把时间全花在调试上,收益被抵消殆尽。
为此,团队大量投入在模拟环境中进行强化学习训练,且训练场景来源于外部客户与亚马逊内部团队的真实知识工作用例。这也解释了实验室的双重职责:一方面帮助早期采用者将早期模型落地生产,另一方面将客户反馈转化为评测集,反哺研究团队训练模型。
Human-in-the-loop(人工介入) 指在 Agent 执行流程的关键节点保留人类确认、修正或接管的能力。在感知智能体场景中尤为重要:由于 Agent 直接操作真实界面,一次误点击可能造成不可逆后果。Nova Act 对人工介入与工具调用的支持,实质上是在自动化收益与操作风险之间设置安全阀。这也是团队强调可靠性的一个具体落地机制——不是追求全自动,而是让人类在必要的环节补位,从而提升整体任务的成功率与可信任度。
人机协作的新界面
工作坊结尾的即兴创意环节评选出多个应用构想,包括「像素裁判」、产品端到端测试Agent,以及让人类与感知智能体在Canvas上实时协作设计UI的工具。
Shruti在总结中给出的核心判断是:人与Agent的协作方式正在改变,而视觉层面的协作工具是缺失的一环。感知智能体开源的这两个原语,正是补上这一环的起点——代码已在GitHub开放,配套的Nova Act SDK与团队关于感知智能体的博客文章也已发布。
对于希望将AI引入前端工作流的团队而言,这套工具组合提供了一个值得关注的范式:不让Agent猜测界面,而是让它与人类共享同一个视觉理解层。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。