亚马逊开源Strands Decider 2B决策模型,本地部署成新趋势
AI正从炫技走向落地:轻量开源模型、自我迭代、滥用治理与基础设施风险同步浮现
本文梳理了AI领域的多条近期动态,共同指向同一趋势:规模竞赛让位于实用落地。亚马逊推出仅20亿参数的开源决策模型Strands Decider 2B,主打本地部署与数据安全;大模型一体机的竞争逻辑也从堆参数转向硬件、推理框架与业务适配的综合能力。与此同时,GPT-5.3 Codex据称已用AI辅助自身后续版本的训练与调试,预示模型开发闭环中出现自我迭代苗头。然而技术红利的反面是滥用风险急剧放大——AI驱动的"杀猪盘"实现批量化,边际诈骗成本趋近于零;深度伪造技术击穿视频图灵测试,真假边界加速模糊。基础设施层面同样暗流涌动,AI数据中心的高杠杆融资结构被研究者点名存在系统性风险。效率与安全之间的平衡,正成为下一阶段的核心命题。
亚马逊入局开源决策模型
亚马逊近期推出了一款名为 Strands Decider 2B 的开源决策模型,核心卖点是支持本地部署。据简报介绍,这款 20 亿参数规模的模型在 JetBench 公开数据集上展现出不错的准确率与效率表现。
相比动辄数百亿、上千亿参数的通用大模型,2B 级别的轻量化模型更契合企业对数据安全、推理成本和延迟的现实需求。决策类任务往往不需要庞大的世界知识,而是需要在特定场景下稳定、可控地给出判断,这正是小参数专用模型的优势所在。开源与本地部署的组合,也意味着企业可以在自有算力环境中完成全链路私有化,不必把敏感业务数据交给云端。
这一动向与近期整个行业的降本思路一脉相承。模型不再一味追求参数规模,而是向场景适配、可落地的方向收敛。
大模型一体机不再比拼参数量
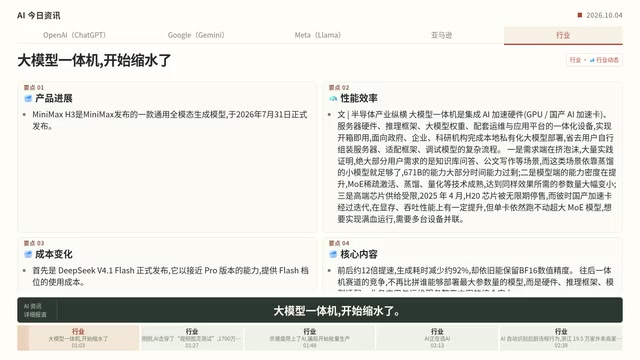
与开源决策模型相呼应的,是硬件侧的变化。简报指出,大模型一体机开始"缩水"——这里的缩水并非贬义,而是行业竞争逻辑的转变。
以 MiniMax H3 这类通用生成模型为例,往后一体机赛道的竞争不再比拼谁能部署最大参数量的模型,而是转向硬件、推理框架、模型适配、业务应用与运维服务整套方案的综合实力。换句话说,单纯堆参数的时代正在过去,谁能把模型高效地跑在合适的硬件上、并真正嵌入业务流程,谁才能胜出。
这与亚马逊 Strands Decider 2B 走的是同一条路:轻量、可部署、强适配。小模型配合优化过的推理框架,在边缘和私有环境中能发挥出远超参数规模预期的实用价值。
AI开始自己造AI
简报里另一个值得关注的信号来自 OpenAI。据称 GPT-5.3 Codex 的发布说明中提到,早期版本的模型已被团队用来制作后续版本——AI 能够调试自己的训练过程、管理自己的部署、诊断测试结果和评估。
这意味着 AI 的角色正在从"写代码的助手"升级为能独立完成发现、定位、修复、验证全流程的 Agent。如果属实,这标志着模型开发闭环中开始出现自我迭代的能力,长期看会显著改变 AI 研发的效率曲线。当然,这类来自发布说明的表述仍需谨慎看待,实际的自主程度和边界尚不清晰。
"AI自我迭代"在技术上通常指模型参与自身的训练数据生成、超参数调优或评估流程,形成部分闭环。这与传统软件的"自动化测试"不同——后者依赖人工预设的规则和测试用例,而AI Agent介入开发闭环后,可以在无明确规则的情况下通过观察模型行为、生成反例、定位失败模式来推动迭代。学术界将这一方向称为"自动化机器学习"(AutoML)或"元学习"(Meta-Learning),但大型语言模型作为工程Agent参与自身后续版本开发,是近年才出现的实践形态。值得注意的是,这类系统仍依赖人类工程师设定目标函数和安全边界,模型无法在完全无监督的情况下自主决定"我需要变得更好",当前更接近"高度自动化的工具链"而非真正意义上的自主进化。
AI造假与治理的两难
技术进步的另一面是滥用风险在快速放大。
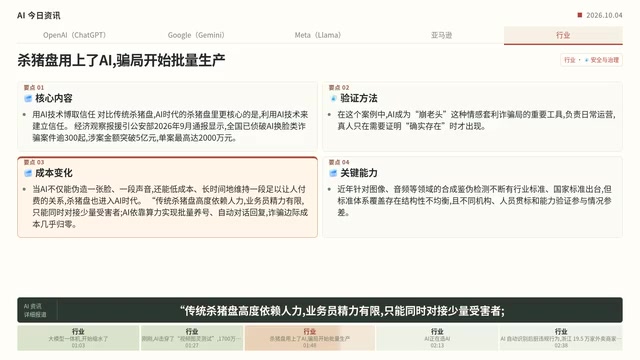
简报提到,所谓"杀猪盘"骗局开始用上 AI 实现批量生产。传统骗局高度依赖人力,业务员精力有限,只能同时对接少量受害者;而 AI 依靠算力实现批量养号、自动对话回复,诈骗的边际成本几乎归零。核心变化在于,骗子利用 AI 技术来批量建立信任。
同时,AI 还击穿了"视频图灵测试",吸引了约 1736 万网友在线围观。作为对照,上一代系统在相同实验流程下,41 人中仅有 1 人被误认为真人,比例为 2.4%。真假边界的模糊也带来现实纠纷——有 Airbnb 房东利用 AI 伪造图片向房客勒索维修费,后者借助水印检测器成功识破。这提醒普通人:网络上的照片很可能已被 AI 处理,并不代表实际情况。
"视频图灵测试"是对经典图灵测试的延伸——原始图灵测试通过纯文字对话判断交互对象是否为人类,而视频版本要求AI生成或操控实时视频流,接受人类评判者的视觉与行为判断。由于人类对面部微表情、眼神同步和唇音匹配非常敏感,视频图灵测试长期被视为比文字测试难得多的挑战。本文提到的实验中,上一代系统仅2.4%的通过率印证了这一难度;而新系统能够显著提升"以假乱真"的比率,说明实时深度伪造(Deepfake)技术已跨越关键阈值。这对身份核验场景(如视频面试、远程公证、视频客服)的安全机制构成直接挑战,单纯依赖"看到才相信"的信任逻辑已不再可靠。
终端与基础设施的调整
终端侧也有变动。华为 Harmony OS 7.0 对"小翼帮帮忙"智能体功能进行调整,将不再支持后续新增的设备。该智能体是 Harmony OS 6.0 上推出的探索性功能,不支持的设备将无法通过数据克隆迁移智能体、个人技能和定时任务。探索性产品的迭代取舍,反映出厂商在智能体落地路径上的持续试错。
基础设施层面则暗流涌动。有研究者在会议论文中指出,AI 基础设施存在大量债务融资、杠杆率较高,一旦需求小幅走弱、项目延期或资产价格下降,都可能造成放大的损失。与此对应,HPE 拿下价值 12 亿美元的 AI 机架订单,Meta 则开源了 MUSE Gadgets,试图让开发者自行打造 AI 外设——MUSE 负责智能能力,开发者负责创造各种硬件载体。
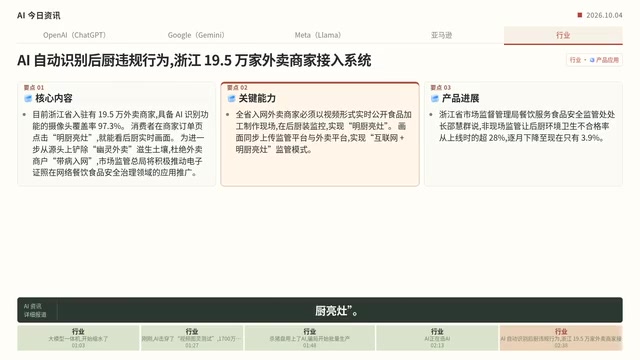
行业监管同样在加码:浙江省已有 19.5 万家外卖商家接入 AI 识别系统,具备 AI 识别功能的摄像头覆盖率达 97.3%,要求商家以视频形式实时公开后厨加工现场。
AI基础设施的债务融资风险是近期金融界开始警惕的话题。当前大量数据中心扩建项目依赖项目融资或杠杆收购结构,其还款现金流高度依赖GPU算力租赁合同的长期稳定执行。一旦模型推理效率大幅提升(如更高效的推理框架降低单次调用成本)、需求增速放缓,或主要云租户缩减订单,底层资产的现金流就可能不足以覆盖债务成本。类似的杠杆风险曾在电信基础设施泡沫(2000年代初)和页岩油繁荣周期中反复出现。HPE拿下12亿美元机架订单,短期看是需求强劲的信号,但在高利率和AI投资回报率仍存争议的背景下,行业整体的资产负债表健康程度值得持续关注。
小结
从亚马逊的开源决策模型,到一体机竞争逻辑的转变,再到 AI 自我迭代与滥用治理,这一轮资讯共同勾勒出一个趋势:AI 正从"炫技"走向"落地",轻量化、可部署、强监管成为关键词。技术红利与风险正同步放大,如何在效率与安全之间找到平衡,将是下一阶段的核心命题。
相关推荐

@ai-sdk/tui 发布补丁更新:依赖项同步升级解析
@ai-sdk/tui 1.0.131 补丁版本发布,核心为依赖项同步升级,底层 ai 包更新至 7.0.130。本文解析该版本更新内容、发布机制及开发者升级建议。

AI辅助编程四阶段演进:从代码补全到智能体协作
深入解析AI辅助编程的本质与四阶段演进:从代码补全、对话式编程,到当前的智能体编程(Claude Code、Cursor等),再到未来的多智能体协作工程时代,为SpringBoot+LangChain4j项目实战打下认知基础。

@ai-sdk/topaz 3.0.3 发布:依赖更新的补丁版本解析
@ai-sdk/topaz 3.0.3 补丁版本发布,同步更新 @ai-sdk/provider 4.0.24 与 provider-utils 5.0.56 依赖。本文解析本次更新内容及对开发者的影响。