压缩即智能:如何把文本压缩到每字符不到1比特

算术编码将语言模型的概率预测转化为逼近香农极限的压缩,揭示压缩与智能的深层等价。
文章从Hutter Prize挑战切入,阐述算术编码如何将语言模型的概率预测转化为近乎最优的压缩。核心原理是将每个字符的概率分布映射到单位区间,模型预测越准,所需比特数越接近香农信息量。工程上通过重新归一化和ANS解决精度问题。文章进一步指出,训练语言模型最小化交叉熵等价于最小化每token编码比特数,压缩与预测在数学上等价。考虑解码器体积后,更小模型可能更优;在线微调可提升压缩率。最终结论是压缩率捕捉了智能的预测能力、简洁性和适应速度,可作为智能的可量化代理指标。
从香农极限到1比特每字符:算术编码如何让预测模型变成压缩器
在信息论领域,一个长期存在的挑战是如何将文本压缩到极致。Hutter Prize 悬赏挑战正是为此设立:谁能将1GB维基百科压缩得最小,谁就能获得奖金。而近期一则技术讲解动画揭示了一个令人惊讶的事实——当前所有获胜方案的核心,都依赖于同一个通用技术:将语言模型与大数算术编码结合,实现接近甚至低于每字符1比特的压缩率。
这套方法不仅适用于文本,图像、音频、视频等任何数据类型都可以用同样思路处理。更耐人寻味的是,它为我们理解“压缩即智能”这一命题提供了具体的数学路径。
核心原理:用概率分布映射到单位区间
从香农信息量说起
1940年代,Claude Shannon 证明:一个消息的最优压缩位数约等于负以2为底的概率对数。概率减半,信息量增加1比特。这意味着一篇高度可预测的文本,理论上只需极少的比特就能表示。然而,传统编码如ASCII或Huffman编码,因为不利用上下文,实际消耗远超理论极限——一段200多字母的文本,ASCII需要超过2500比特,Huffman编码也只能压到约1500比特。
问题出在固定编码上:每个字符无论上下文如何,都对应固定长度的比特串。而Shannon的理论明确指出,可压缩性完全取决于可预测性,而可预测性高度依赖上下文。
香农信息量(Shannon information content)是信息论中最基础的概念之一,用于量化一个随机事件所携带的“意外程度”或“不确定性消除量”。对于离散随机变量X,当观察到某个具体取值x时,其自信息量定义为I(x) = -log₂ P(x),单位是比特。这个定义直观地表达了:越不可能发生的事件(概率越小),一旦发生,所提供的信息量就越大。例如,抛一枚均匀硬币,正面朝上的概率为0.5,信息量为1比特;而抛一枚偏重硬币,正面概率为0.9,信息量仅约0.152比特。香农进一步证明了信源熵H(X) = -Σ P(x)log₂P(x)是平均信息量的下界,也是无损压缩的理论极限。这为后续所有压缩算法提供了衡量标准:任何编码方案的平均码长都不可能低于信源熵。
语言模型作为预测引擎
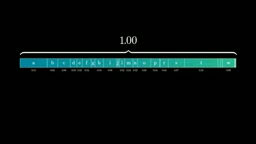
现代语言模型恰好擅长根据上下文预测下一个字符或token的概率分布。算术编码的核心思想是:将每个可能字符的概率分布映射到0到1的单位区间上,概率越高的字符占据越宽的区间。随着字符逐个输入,模型不断更新预测,区间不断缩小,最终整段文本对应一个极窄的实数区间,只需传递该区间内的一个实数即可。
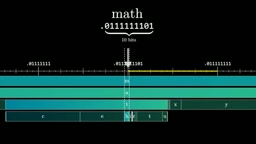
接收方持有完全相同的语言模型,从空上下文开始,逐步解码每个字符:先看实数落在哪个字符的区间,再将该字符作为新上下文,继续解码下一个字符。双方模型必须完全一致,否则解码会偏离。
语言模型(Language Model)是估计文本序列概率分布的统计模型,其核心任务是根据给定的上下文预测下一个词或字符的概率。现代语言模型通常基于神经网络,特别是Transformer架构,通过在海量文本上训练来学习语言的统计规律和语义结构。在压缩语境下,语言模型扮演“概率预言家”的角色:对于任意给定的上下文,它输出词汇表上所有可能下一个token的概率分布。这个分布越准确(即越接近真实数据的生成分布),算术编码器就能用越少的比特表示实际出现的token。值得注意的是,语言模型并不需要“理解”文本,只需要提供足够好的概率估计;但反过来,极佳的压缩性能往往暗示模型捕捉到了数据中的深层规律,这正是“压缩即智能”讨论的起点。
比特数如何逼近理论极限
一个实数区间宽度为p,要保证用k比特能落入其中,需要2^{-k} < p,即 k ≥ -log₂(p)。这正好是Shannon信息量。因此,只要模型预测准确,压缩后的比特数就几乎等于信息量,加上少量消息长度开销。对于极长文本,长度开销可忽略,最终压缩率无限接近香农极限。
以单词“mathematics”为例,模型认为其概率对应的信息量是18比特,但由于区间恰好与一个10比特的二进制数重叠,实际只用10比特就编码成功,平均每字符0.91比特。这种“运气”在长文本中会被平均掉,但整体上仍然高度接近极限。
从理论到实践:算术编码的工程实现
精度问题与重新归一化
直接使用无限精度实数显然不现实。1976年,Jorma Rissanen 和 Richard Pasco 独立提出了算术编码,核心技巧是每一步后将区间重新归一化到长度1,同时输出已确定的比特。这样只需有限精度即可持续编码。
算术编码的重新归一化(renormalization)是解决有限精度问题的关键机制。在标准算术编码中,编码器维护一个当前区间[low, high),初始为[0,1)。每编码一个符号,区间按该符号的概率分布缩窄。但由于计算机只能表示有限位数的整数,区间不能无限缩小。当区间宽度小于某个阈值时,编码器执行归一化:检查low和high的最高有效位是否相同,若相同则输出该比特,并将区间左移一位(即乘以2)并扩展;若出现下溢风险(low接近0.5而high接近1.0),则采用E3条件进行特殊处理。这一过程确保区间始终保持在可用精度范围内,同时将已确定的比特逐步输出。解码器执行完全对称的操作,从码流中读入比特并重建区间。重新归一化使得算术编码能够以O(log n)的精度处理任意长度的消息,是算术编码走向实用的基石。
非对称数字系统(ANS)
2013年,Jarek Duda 提出了另一种方案——非对称数字系统(ANS),用一个不断增长的整数来编码消息,避免了实数精度问题,速度更快。这两种方法都能将任意预测器转换为压缩器,且已广泛应用于现代压缩工具。
非对称数字系统(Asymmetric Numeral Systems, ANS)由波兰学者Jarek Duda于2009年提出,2013年后被广泛采用。与算术编码维护一个实数区间不同,ANS用一个不断增长的整数状态来编码整个消息,通过可逆的“状态转移”将符号映射到新状态。其核心优势在于:编码和解码可以逐符号进行,无需像算术编码那样处理区间下溢和复杂的归一化逻辑,因此速度更快、并行性更好。ANS有多种变体,如rANS(范围ANS)和tANS(表格ANS),分别适用于不同的概率分布和硬件环境。目前,ANS已被集成到Zstandard、LZMA2等现代压缩工具中,并在图像和视频编码标准(如JPEG XL)中得到应用。从理论角度看,ANS同样能将任意预测模型转换为压缩器,其压缩率与算术编码一样逼近香农极限,只是实现路径不同。
语言模型训练的新视角:压缩即目标
交叉熵损失的本质
压缩大小可写成负对数概率,而概率是每个预测概率的乘积取对数后求和。每一项对应模型对真实下一字符的“惊讶程度”。训练时最小化交叉熵,实际上就是最小化每个token的平均编码比特数。
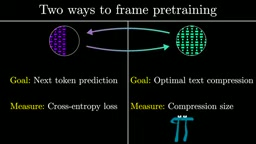
这提供了一个心理上更清晰的框架:预训练的目标不是“预测下一个token”,而是“成为最好的文本压缩器”。交叉熵损失不再是随意选择,而是直接对应比特数。
模型大小与压缩率的权衡
使用小模型(如3.7M参数的NanoGPT)编码一段文本,平均每字符约2比特,是Shannon估计的两倍。而换用5亿参数的开源模型Qwen,平均每字符降到1比特以下。对于高度可预测的文本(如美国宪法序言),后文几乎不增加成本,仅需10比特,相比Huffman编码有两个数量级的提升。
然而,这引发一个合理质疑:模型本身可能已经记住了这些文本,压缩率是否“作弊”?Hutter Prize 的评分规则已经考虑这一点——压缩结果必须包含解码程序的体积。因此,大模型即使预测精准,其参数体积也会被计入总成本。
压缩与智能的深层联系
预测与压缩的等价性
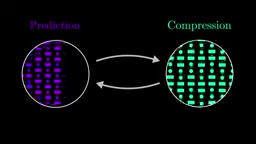
算术编码展示了预测器到压缩器的转换。反过来,任意压缩器也可用来做预测:对候选字符串,比较压缩后长度的增量,增量越小则概率越高。因此,压缩与预测在数学上等价。
小型化与泛化能力
两个预测能力相同的模型,参数更少的那个被认为更“理解”数据,因为它依赖更少记忆。在压缩框架下,考虑解码器体积后,小模型可能获得更优的总压缩率。这与“奥卡姆剃刀”原则一致:更简洁的理论往往更接近本质。
快速学习与在线适应
压缩过程还可以引入在线学习:编码器和解码器同步微调模型参数,使其适应特定文本。只要更新规则确定,双方就能保持同步。这样,压缩率不仅取决于静态预测能力,还取决于模型学习新内容的速度。学习越快,压缩越好。这与智能中“快速适应新领域”的特征相呼应。
结语:压缩作为智能的代理指标
从香农的理论到算术编码,再到语言模型训练,一条清晰的线索浮现:压缩与智能紧密交织。虽然不能简单等同,但压缩率确实捕捉了智能的多个侧面——预测能力、模型简洁性、快速适应。正如牛顿赋予“能量”数学定义,压缩或许能为我们理解智能提供一个可量化的起点。
对于AI从业者,这一视角的实用价值在于:优化语言模型时,可以更直接地将目标锚定在比特数上;设计压缩系统时,可以放心地将最先进预测模型嵌入算术编码框架。两者相互促进,共同逼近信息论极限。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。