眼动追踪如何评估AI视频真实感?新研究提出GazeEval方法

新研究用眼动追踪补充AI视频评估,并提出GazeEval预测感知真实感。
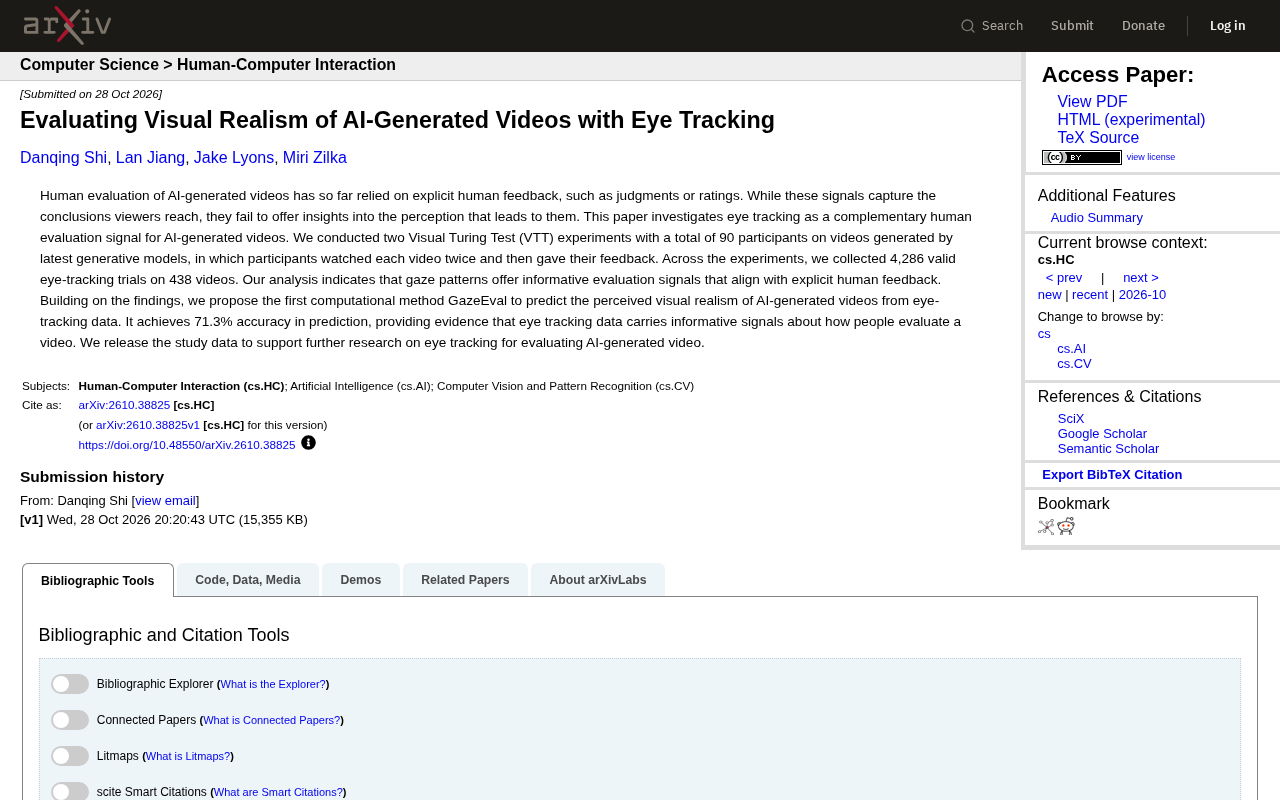
文章介绍了一项用眼动追踪补充AI生成视频评估的研究。现有评估主要依赖人类打分、排序等显式反馈,只能得到判断结论,无法揭示感知过程。研究者设计两组视觉图灵测试,招募90名参与者,在438个视频上收集4,286次有效眼动追踪试次,发现注视模式与显式人类反馈存在对齐关系,眼动数据携带关于视频真实感评估的可捕捉线索。基于此,研究者提出首个从眼动数据预测感知视觉真实感的计算方法GazeEval,预测准确率达71.3%,并公开研究数据。文章指出眼动追踪是显式反馈的补充而非替代,未来可辅助定位引发不真实感的区域、为模型训练提供感知层反馈,但采集设备成本限制其大规模应用。
为什么需要新的AI视频评估方法
当前评估AI生成视频质量的主流方式,仍然依赖人类给出的显式反馈——打分、排序或文字评价。这类信号能告诉我们观众最终做出了什么判断,却无法揭示判断背后的感知过程。换句话说,我们只知道"观众觉得这个视频不够真实",却不清楚他们在观看时的注意力分布如何影响了这一结论。
一篇新论文提出用眼动追踪作为补充评估信号,试图填补这一空白。研究者设计了两组视觉图灵测试(Visual Turing Test, VTT),共招募90名参与者,让他们观看由最新生成模型产出的视频。每位参与者对每个视频观看两次,然后给出反馈。两组实验最终在438个视频上收集到4,286次有效眼动追踪试次。
视觉图灵测试(Visual Turing Test, VTT) 是图灵测试在视觉内容领域的变体:让人类观察者判断一段视频(或图像)究竟由 AI 生成还是真实拍摄,从而衡量生成模型“以假乱真”的程度。与依赖固定指标(如 FID、IS)的传统评估不同,VTT 直接以人类感知作为判据,因而更贴近“真实感”这一主观维度。不过在标准 VTT 中,参与者通常只输出一个二选一的判断结果,实验记录的是“最终答案”,而非判断形成的动态过程。本研究在 VTT 框架上叠加了眼动追踪,正是为了在保留人类判断这一金标准的同时,捕获判断发生时的注意力分配信息。
视线轨迹与主观判断的一致性
研究的核心发现是:注视模式提供的评估信号与显式人类反馈存在对齐关系。这意味着,当观众认为一个视频"像真的"或"一眼假"时,他们的眼动数据中已经包含了可被捕捉的线索。
这一结论的价值在于,它把评估维度从"结论"推进到了"过程"。显式评分是感知链路末端的产物,而眼动数据记录的是感知本身如何展开——观众在哪里停留、哪些区域被反复注视、视线如何在画面中迁移。对于生成视频而言,这些模式可能比最终打分更能揭示模型在哪些细节上露了馅。
需要注意的是,论文强调眼动信号是"补充"而非"替代"。显式反馈依然有效,眼动数据提供的是另一层信息,两者结合才能更完整地刻画人类对视频真实感的感知。
眼动追踪(eye tracking) 通过红外摄像或视频图像分析,实时记录眼球运动,常用指标包括注视点(fixation,视线在某一区域的短暂停留)、扫视路径(saccade,注视点之间的快速跳动)以及回视(regression,视线重新回到已看过的区域)。在视觉感知研究中,注视时长和热点分布被广泛视为注意力与认知负荷的间接测量。将这一手段用于 AI 生成视频评估,其假设是:当观众在某个区域反复停留或来回扫视时,往往意味着该区域存在异常、失真或引起怀疑的细节——例如不自然的手部动作、纹理闪烁或物理不一致。这些过程性信号难以通过打分直接表达,却可能恰好对应生成模型的典型失败模式。
GazeEval:从眼动数据预测感知真实感
基于上述发现,研究者提出了GazeEval——首个从眼动追踪数据预测AI生成视频感知视觉真实感的计算方法。该方法在预测任务上达到71.3%的准确率。
71.3%这个数字本身不算惊艳,但它的意义在于证明了眼动数据确实携带关于人类如何评估视频的信息。作为首个此类方法,它打开了一条新路径:如果眼动信号可以被计算模型利用,那么未来或许能构建更贴近人类感知的视频质量评估流程,而不必每次都依赖大规模人工打分。
论文同时释放了研究数据,以支持后续关于眼动追踪用于AI生成视频评估的进一步研究。
感知视觉真实感(perceived visual realism) 与客观的像素级或物理级真实性不同,指的是观众主观上认为画面“像真的”的程度,属于感知层面的构念。它受内容语义、运动连贯性、光照一致性以及观看者先验知识等多重因素影响,因此难以用单一客观指标刻画。GazeEval 要预测的正是这一主观量:输入为眼动序列(如注视点坐标、时长、扫视路径),输出为对应视频被感知为真实的倾向。71.3% 的准确率需放在此类主观预测任务的背景下理解——由于个体差异和任务本身的噪声,感知类预测的准确率天花板通常低于客观分类任务,因此这一结果的意义更多在于证明眼动信号具有可计算、可利用的预测价值,而非追求绝对精度。
对AI视频评估生态的潜在影响
这项工作触及了生成模型迭代中的一个现实问题:评估瓶颈。视频生成模型的能力在快速提升,但评估手段仍然以人工评分为主,成本高、难以规模化,且只给出结论不给出原因。
眼动追踪提供了一种介于生理信号与主观判断之间的评估层次。它比单纯打分更细粒度,又比纯生理测量更贴近任务目标。如果GazeEval这类方法继续成熟,可能的落地场景包括:辅助定位生成视频中引发"不真实感"的具体区域、为模型训练提供感知层面的反馈信号、以及在人工评估之外增加一道可自动化的质量筛查。
当然,眼动数据的采集本身需要专门设备,这限制了它的大规模应用。但从方法论角度看,这项研究提醒我们:评估AI生成内容时,观众"看了哪里"和"给出了什么评分"同样值得关注。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。