药学人零基础学AI:五大方向与四阶段学习路径

药学人学AI应以药学问题为核心,按专业方向选技术栈,而非盲目死磕算法。
本文整理自一份面向药学背景学习者的AI入门教程,核心观点是:药学人的竞争优势在于对药学问题的深刻理解,AI只是工具。文章将药学+AI细分为AIDD、临床药学/真实世界研究、药剂学、中药、药物警戒五大方向,强调不同专业背景对应完全不同的技术栈,选错方向会大幅增加学习成本。针对零基础学习者,教程给出四阶段路径:先补Python与数据分析能力,再学机器学习基础,然后按具体方向分流学习专项技术,最后通过完整项目验证能力。文章反复强调,真正重要的不是会多少算法,而是能否清晰定义药学问题、解释数据来源、评价模型局限并赋予结果药学意义。
对于药学背景的从业者和学生来说,AI早已不是遥远的概念。药物发现、分子筛选、制剂研发、真实世界研究、药物警戒——越来越多的药学场景正在被AI工具重塑。但一个普遍的误区是:很多药学人一上来就死磕Python、机器学习、深度学习,恨不得把所有算法学一遍。这条路径往往事倍功半。
本文基于B站一份面向药学人的AI学习教程整理,核心观点很明确:药学人学AI真正重要的不是你会多少算法,而是你能不能用AI解决药学问题,是你比计算机专业的人更懂药。
药学+AI到底值不值得学
先回答最关心的问题:值得,但不是网上说的那种「学完工资翻倍、随便跑个模型就能发SCI」。
真正值得关注的原因在于,AI已经切实进入药物发现、分子筛选、制剂研发、真实世界研究、药物警戒等药学环节。对药学人而言,这意味着工具箱扩容了——过去你可能只能做实验、查文献、做统计,现在多了一套能处理更大规模数据、预测结果、筛选候选方案,甚至从海量文献和真实世界数据中寻找规律的方法。
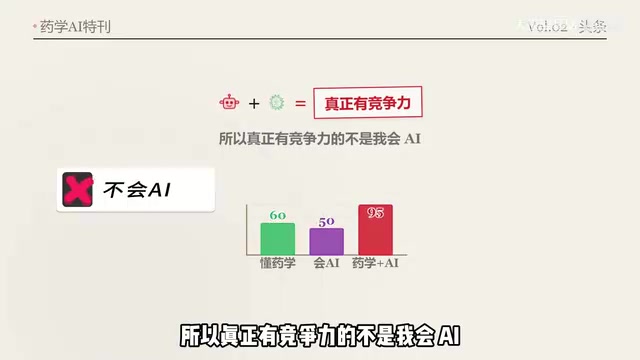
关键在于定位。真正有竞争力的不是「我会AI」,而是「我懂药学,并且知道怎么用AI解决药学问题」。药学知识才是基本盘,AI只是工具。这个判断贯穿整篇教程,也是区别于通用AI课程的核心逻辑。
药学+AI的五个方向
教程建议关注五条主线,不同专业背景对应完全不同的技术栈,选错方向意味着走弯路。
第一条:AI辅助药物研发(AIDD)。 适合药化、药理、生物信息、制药工程背景。重点是靶点发现、虚拟筛选、分子性质预测、活性预测、ADMET预测、分子生成与优化。这个方向对计算能力要求较高,后续会接触RDKit、分子描述符、机器学习、图神经网络等。
第二条:临床药学、真实世界研究+AI。 适合临床药学、医院药师、药物流行病学方向。要解决的不是生成新分子,而是处方数据分析、不良反应研究、患者风险预测、真实世界数据分析以及医学文本信息提取。Python、SQL、统计分析乃至NLP和大模型,比一上来研究分子生成更实用。
第三条:药剂学+机器学习。 涉及制剂处方优化、工艺参数预测、质量属性预测。教程特别提醒:药剂学的同学不必看到AI就去卷复杂的深度学习,很多实际问题用传统机器学习甚至统计模型就能先做出很好的baseline。把药学问题定义清楚,比模型复杂更重要。
第四条:中药+AI。 包括中药成分数据分析、中药质量评价、多组学数据、中药知识挖掘。这里有一句尖锐提醒:不要以为「中药+AI」就等于套一个算法跑一遍网络药理学就有创新,真正重要的是数据质量、研究问题和验证方式。
第五条:药物警戒和药物安全+AI。 从不良反应报告、医学文献、真实世界数据中做信息抽取、风险信号识别和辅助分析,特别适合熟悉药物安全、药事管理、临床数据的人。
这五个方向虽然都叫「药学+AI」,但后面真正要学的东西完全不同。所以零基础的第一步不该是「我该学CNN还是Transformer」,而是「我以后想用AI解决什么药学问题」。方向确定后再补技术。
ADMET是药物发现中的核心评估维度,指吸收(Absorption)、分布(Distribution)、代谢(Metabolism)、排泄(Excretion)和毒性(Toxicity)。一个候选分子无论活性多强,若ADMET性质不佳,在临床开发阶段极易失败。传统ADMET测定依赖大量体外体内实验,耗时耗力;AI模型可基于分子结构直接预测这些属性,大幅提前筛掉"不成药"的候选物。QSAR(定量构效关系)则是通过数学模型建立分子结构特征与生物活性之间的定量关系,是AIDD中最经典的建模范式,也是药学人理解机器学习在化学空间中如何工作的最佳切入点。**图神经网络(GNN)**是一类专为图结构数据设计的深度学习模型,分子天然可以表示为原子-键图,GNN因此成为分子性质预测的主流架构之一,相比传统分子描述符能捕获更丰富的拓扑信息。
零基础的四阶段学习路线
针对完全零基础的学习者,教程给出了一条清晰的四阶段路径。
阶段一:补齐数据分析能力
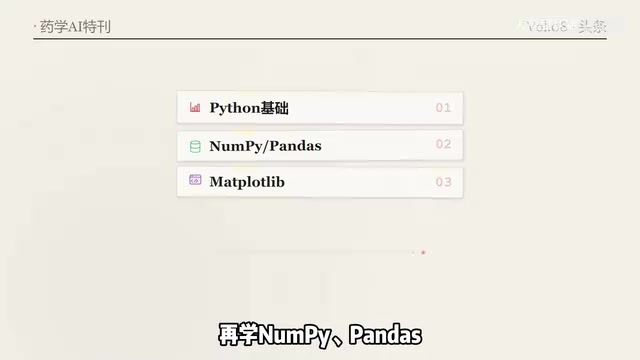
Python不必从底层死磕,先掌握Python基础,再学NumPy、Pandas、Matplotlib和Scikit-learn的基础用法。
这里纠正一个常见误区:不是数学完全不用学。 你确实没必要一开始就去死磕高数证明,但基本的概率统计、线性代数、分类回归、模型评价指标必须理解,否则你只会掉包,既不知道模型为什么对,也不知道为什么错。
阶段二:学习机器学习
重点弄懂分类、回归、交叉验证、特征工程、数据划分、过拟合以及常见的模型评价方法。这个阶段甚至不用急着上深度学习。一个更有价值的建议是:找一个真实的药学数据集,完整跑通一次数据清洗、特征处理、模型训练、模型评估到结果解释,比看20个算法教程有用得多。
**过拟合(Overfitting)**是机器学习中最常见的陷阱之一,指模型在训练集上表现极好、但在新数据上泛化能力差的现象,本质是模型"记住了"训练数据的噪声而非真实规律。在药学数据集中,由于样本量普遍偏小(相比互联网数据),过拟合风险尤为突出。交叉验证是应对过拟合的标准手段,通过将数据集分成若干折轮流作训练/验证集,给出更可靠的性能估计。特征工程在药学场景中尤为关键——分子指纹、分子描述符、临床指标的选取与转化方式,直接决定模型能否捕获药学意义上的规律。理解这些概念的药学含义,比单纯会调API参数更有价值,也是药学背景者相比纯计算背景者真正的优势所在。
阶段三:按专业方向分流
这一阶段根据前面确定的方向补对应技术:
- 做AIDD,去学RDKit的分子指纹、分子描述符、QSAR、分子性质预测,再按项目需要接触图神经网络、Transformer;
- 做临床药学、真实世界研究或药物警戒,重点补SQL、统计分析、临床数据处理、文本挖掘和NLP;
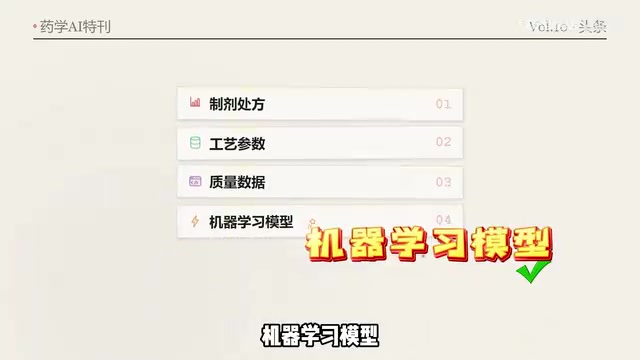
- 做药剂学,围绕制剂处方、工艺参数和质量数据去建立机器学习模型。
核心原则是:不要别人学什么你就跟着学什么。
阶段四:做完整项目
这是最重要的一步。AIDD方向可以做分子性质预测项目,临床药学可以做不良反应或患者风险预测项目,药剂学可以做处方或工艺参数优化项目。
重点不是模型多高级,而是你能否完整回答这几个问题:数据从哪里来?为什么这样处理?为什么选这个模型?Baseline是什么?怎么评价结果?模型哪里会失效?结果有没有真正的药学意义?如果这些都能答出来,你才算真正入门了药学+AI。
**Baseline(基线模型)**是指在引入复杂模型之前,用最简单的方法(如逻辑回归、随机猜测、历史均值等)建立的参考标准。Baseline的意义在于:如果一个深度学习模型的效果连简单逻辑回归都打不过,说明特征工程或数据处理环节存在问题,而非需要更复杂的网络架构。在药学研究场景中,许多论文忽略了Baseline对比,导致AI模型的实际增益难以评估。先跑通Baseline再迭代优化,是工业界和严谨学术研究中的通行做法,也是判断一个AI药学项目质量的重要标准。
给药学人的一句忠告
教程结尾的观点值得所有准备转向AI的药学人反复咀嚼:不要丢掉自己的专业优势,跑去和计算机专业的人硬卷算法。
药学知识是你的基本盘,Python、机器学习、大模型都只是工具。真正稀缺的,是既懂药学问题、又能把AI工具用对的人。这条建议其实适用于所有垂直领域的从业者——AI时代的护城河,往往不在于算法本身,而在于对具体问题的深刻理解。
对药学人来说,与其焦虑地追赶技术更新,不如先想清楚自己所在的细分领域到底有哪些痛点值得用AI去解决。方向对了,工具自然水到渠成。
相关推荐

OpenAI办公室发现录音设备:安全与隐私再引关注
OpenAI在一处办公室发现录音设备,事件细节有限但引发对AI公司物理安全与隐私保护的广泛讨论。本文分析事件背景、行业影响及对AI从业者的安全启示。

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。