异步Q-Learning的命中时间界:样本复杂度新进展

异步Q-Learning单轨迹最后迭代的紧致样本复杂度分析,以命中时间刻画初始化成本并给出无参数步长选择规则。
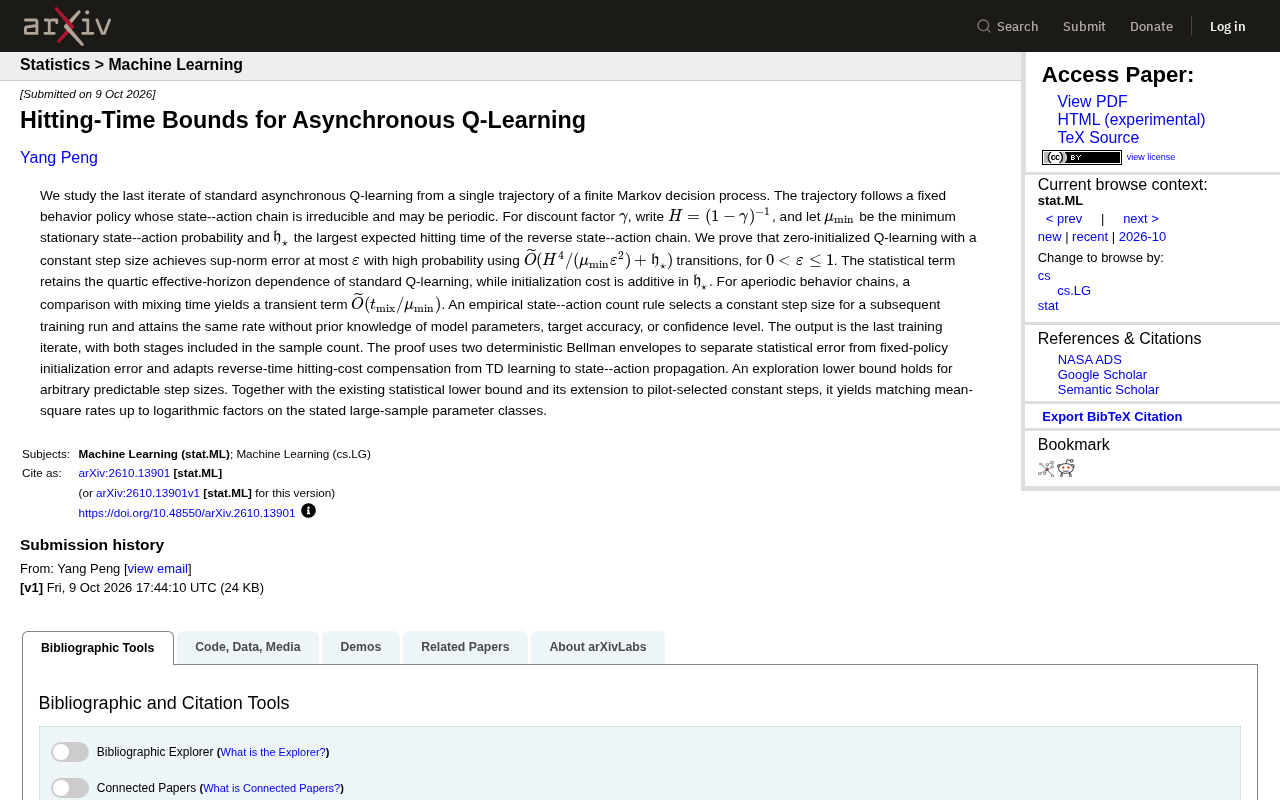
这篇理论论文针对异步Q-Learning在单条轨迹上的最后迭代收敛性给出了精细的样本复杂度分析。核心结论是:零初始化、常数步长的Q-Learning可在 Õ(H⁴/(μ_min·ε²) + ℎ⋆) 次转移内达到ε精度,其中统计项保留了对有效视界H的四次方依赖(与已知下界匹配),而初始化成本以反向链最大期望命中时间 ℎ⋆ 的**可加形式**出现,不随精度要求放大。论文允许行为链存在周期性,突破了传统混合时间框架的限制。在算法层面,提出了基于经验状态-动作计数的步长选择规则,无需任何先验参数即可达到理论最优速率。证明技术上,通过双重确定性Bellman包络将统计误差与初始化误差分离,并迁移TD学习中的反向命中补偿方法,结合探索下界给出精确到对数因子的匹配均方速率。
强化学习理论领域一篇新研究,针对异步Q-Learning算法的最后迭代(last iterate)给出了精细的样本复杂度分析。这项工作把注意力放在从单条轨迹学习的实际场景上,并引入了「命中时间」(hitting time)这一视角来刻画初始化成本,为理解异步Q-Learning的收敛行为提供了更贴近实践的理论工具。
研究背景与问题设定
经典的Q-Learning收敛性分析大多依赖同步更新或对每个状态-动作对的独立采样假设,但真实的在线学习往往只能依赖一条由固定行为策略生成的轨迹。这篇论文正是在这一更现实的约束下展开。
研究对象是有限马尔可夫决策过程(MDP),轨迹由一个固定的行为策略产生,其状态-动作链是不可约的(irreducible),并且允许存在周期性(periodic)。这一点很关键——允许周期性意味着分析不再依赖传统的混合时间(mixing time)框架,而需要更一般的工具来处理采样的时间相关性。
论文采用若干核心量来刻画问题难度:折扣因子 $\gamma$ 对应的有效视界 $H=(1-\gamma)^{-1}$,最小平稳状态-动作概率 $\mu_{\min}$,以及反向状态-动作链的最大期望命中时间 $\mathfrak{h}_\star$。这些量分别对应了折扣带来的难度、采样覆盖的均衡程度,以及链的「可达性」结构。
命中时间(Hitting Time)是马尔可夫链理论中的基本概念,指从某一状态出发,首次到达目标状态(或状态集合)所需步数的期望值。在异步Q-Learning中,不同的状态-动作对被访问的频率取决于行为策略和链的结构——如果某个状态-动作对在链上"难以到达",那么在训练早期它几乎得不到更新,Q值估计就会长期停留在初始化值附近。论文中的 $\mathfrak{h}_\star$ 取的是反向时间链(即将转移方向倒转后的链)上所有状态-动作对的最大期望命中时间,这一量捕捉了"最难被充分覆盖的那个状态-动作对"所带来的初始化代价,比混合时间更精细地刻画了链的局部可达性结构。
核心结果:样本复杂度界
论文的主结论是:采用零初始化和常数步长的Q-Learning,能在高概率意义下,使用 $\widetilde{O}(H^4/(\mu_{\min}\varepsilon^2)+\mathfrak{h}_\star)$ 次状态转移,将 sup-norm 误差控制在 $\varepsilon$ 以内(对 $0<\varepsilon\le1$ 成立)。
这个界的结构值得拆解分析:
- 统计项 $\widetilde{O}(H^4/(\mu_{\min}\varepsilon^2))$ 保留了标准Q-Learning对有效视界的四次方(quartic)依赖。这一依赖关系此前已被证明在最坏情形下难以改进,因此本文结果与已有的统计下界相匹配。
- 初始化成本 $\mathfrak{h}_\star$ 以**可加(additive)**形式出现,而非乘性。这意味着命中时间带来的额外代价只是一次性的「暖机」开销,不会随精度要求 $\varepsilon$ 的提高而放大。
对于**非周期(aperiodic)**行为链的情形,论文还给出了与混合时间的对照,得到一个瞬态项 $\widetilde{O}(t_{\mathrm{mix}}/\mu_{\min})$,把新框架与传统基于混合时间的分析衔接了起来。
**最后迭代(Last Iterate)收敛性与平均迭代(Average Iterate)**收敛性是强化学习理论中两种不同的分析范式。平均迭代取所有历史Q值的均值输出,统计噪声被平均掉,分析相对容易;但实际算法几乎总是直接使用最新的Q值,即最后一次迭代的输出。最后迭代分析在技术上更难,因为它必须控制单次估计的波动,而非均值的偏差。Q-Learning的最后迭代保证在理论上长期落后于平均迭代分析,也落后于策略梯度等方法的同类结果。本文针对最后迭代给出紧致界,正是填补了这一缺口,使理论结论与算法的实际部署方式真正对齐。
无需先验知识的步长选择
理论界虽然漂亮,但实践中常常卡在一个问题上:常数步长的最优取值往往依赖于模型参数、目标精度或置信水平,而这些在实际训练时都是未知的。
论文提出了一个基于经验状态-动作计数(empirical state-action count rule)的规则,用于为后续的训练阶段挑选常数步长。这个规则不需要事先知道任何模型参数、目标精度或置信水平,却能达到与理论最优相同的收敛速率。更重要的是,算法输出的是最后一次训练迭代(last iterate),而不是历史平均,并且两个阶段(步长选择 + 正式训练)的样本都被计入总的样本量——这让样本复杂度的核算更加诚实。
证明技术:双重Bellman包络与反向命中补偿
从方法论角度看,这篇论文的技术贡献同样值得关注。证明的核心是构造两个确定性的Bellman包络(deterministic Bellman envelopes),用来把统计误差与固定策略下的初始化误差分离开来。这种分离正是为什么初始化成本能以可加形式出现的关键。
另一个技术要点是将**反向时间命中成本补偿(reverse-time hitting-cost compensation)**从TD学习的分析中迁移过来,并适配到状态-动作传播的场景。这类技术原本用于处理时序差分学习中的时间相关性,本文将其拓展到Q-Learning的更新结构上。
论文还证明了对任意可预测步长(predictable step sizes)成立的探索下界(exploration lower bound)。结合已有的统计下界及其在导航步长(pilot-selected constant steps)上的推广,这些结果共同给出了在所给大样本参数类上、精确到对数因子的匹配均方速率(matching mean-square rates)。换句话说,上界与下界在量级上吻合,说明该分析在这一类问题上基本是紧的。
**Bellman包络(Bellman Envelope)**的构造思路来源于将Q-Learning更新写成Bellman算子迭代加噪声的形式。确定性包络是指构造两条单调的确定性序列——一条从上方、一条从下方——使得真实的随机Q值轨迹始终被夹在中间。分离统计误差与初始化误差的关键在于:统计误差来源于采样噪声的累积,其大小由步长和采样次数共同决定;而初始化误差则来自Q值起点(零初始化)与真实Q函数之间的距离,其消退速度由Bellman压缩率 $\gamma$ 和各状态-动作对首次被充分访问的时刻决定。双重包络技术将这两部分的演化轨迹在数学上显式分开,从而使命中时间仅出现在刻画初始化消退的项中,自然导出可加结构。
意义与定位
这项工作的价值在于把三个常被割裂处理的要素统一到了一个框架里:单轨迹采样、周期性行为链、以及实用的步长自适应。对于关注强化学习样本效率理论的研究者,它提供了一个在更弱假设下仍然紧致的分析范式;而命中时间作为初始化成本度量的引入,也为理解「从何处开始学习」这一问题提供了新的刻画角度。
需要说明的是,这是一篇偏理论的研究,其结论建立在有限MDP和固定行为策略等假设之上,与深度强化学习的函数逼近场景仍有距离。但作为Q-Learning收敛性理论的一块拼图,它把统计极限与算法可实现性之间的缝隙又收窄了一些。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。