一场协调式LLM压力测试招募:4小时并发实测意味着什么

Reddit上一则招募帖揭示AI产品上线前鲜少曝光的环节:用真人协调并发来验证推理服务的稳定性。
一则Reddit招募帖寻找10至20名志愿者,在同一四小时窗口内高强度使用某匿名LLM服务,接口采用OpenAI兼容格式。文章指出,"同时"与"协调"二字指向并发压力测试而非普通模型评测——真人用户的不规则请求、多样化prompt和agent链式调用,能复现自动化脚本难以模拟的真实流量特征。OpenAI兼容接口的选择则暗示该系统可能是早期模型服务或新推理基础设施,匿名盲测安排也符合产品方收集中立反馈的惯常做法。文章提醒有意参与者注意数据安全,同时将这则帖子定性为AI产品从开发走向生产过程中"真实并发验证"这一被忽视环节的缩影。
一则不寻常的招募帖
在Reddit上,一则简短的招募帖引起了部分AI从业者的注意。发帖人正在寻找10到20名志愿者,参与一场"协调式"的大语言模型(LLM)测试。测试时间定在10月8日(周四)15:00–19:00 UTC,共计四个小时。
按照帖子描述,测试访问是免费的,接口采用OpenAI兼容格式(OpenAI-compatible API)。这意味着参与者可以直接复用现有的OpenAI SDK、工具链和脚本,几乎零迁移成本即可接入待测的模型服务。
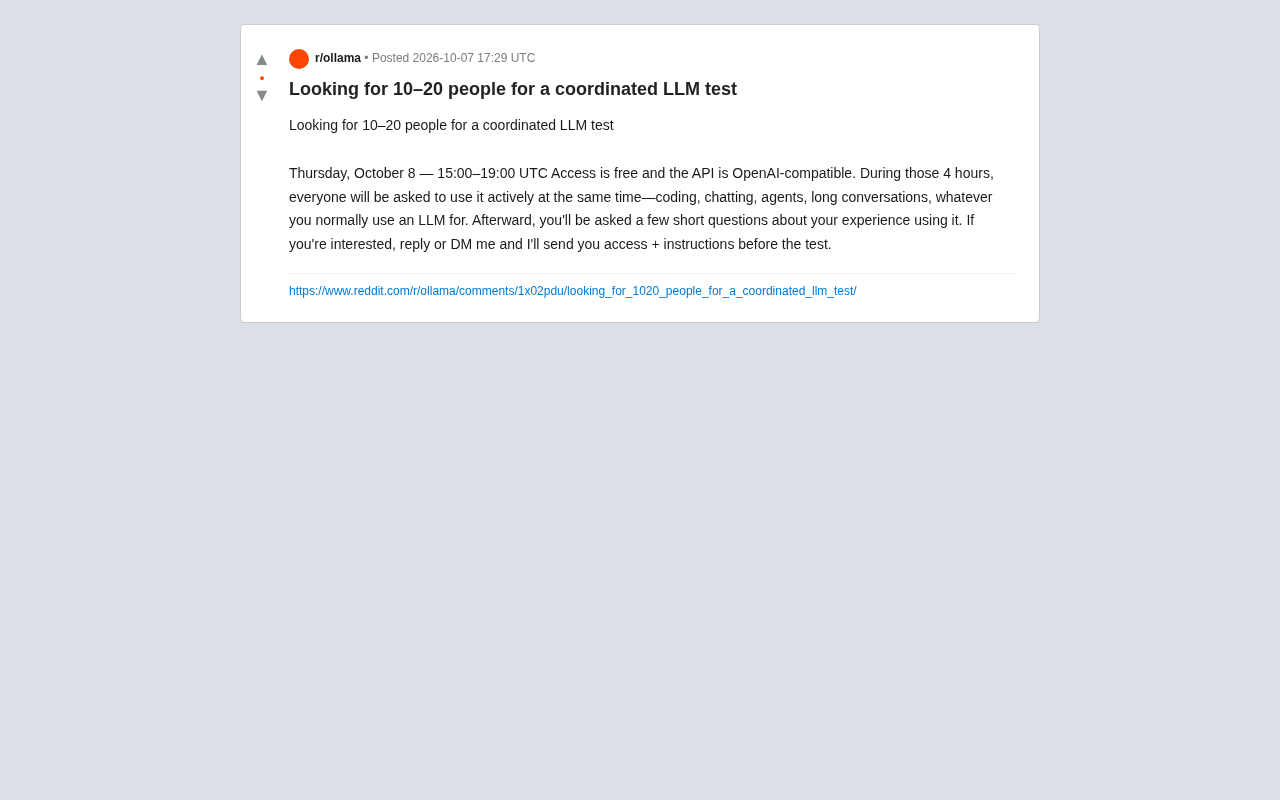
帖子的核心诉求很明确:在这四个小时内,所有人同时高强度使用这套系统——写代码、聊天、跑智能体(agents)、进行长对话,日常怎么用LLM就怎么用。测试结束后,参与者需要回答几个关于使用体验的简短问题。
为什么强调"同时"和"协调"
这则招募帖最值得玩味的词是"coordinated"(协调式)和"at the same time"(同时)。普通的模型评测往往是分散的、异步的——每个人在自己方便的时间试用,反馈的是单用户场景下的质量。而这次明确要求所有人在同一时间窗口内集中发起请求。
这种设计通常指向一个目标:并发压力测试。当10到20名用户同时进行编码、长对话、智能体调用等重负载任务时,系统会面临真实的并发请求洪峰。发帖人想观察的,很可能不只是模型回答得好不好,而是服务在负载下的表现——响应延迟是否稳定、吞吐能否撑住、长上下文会话是否会在高并发时出现降级或超时。
对于一个尚未公开、或处于内测阶段的推理服务来说,这类"小规模集中并发"是上线前验证基础设施稳定性的经济做法。相比动辄模拟上千并发的自动化压测,招募真人用户能带来更贴近实际的流量模式:不规则的请求间隔、多样化的prompt长度、以及agent场景下的多轮链式调用。
智能体(agent)场景对并发压测尤为关键:agent任务通常涉及多轮调用、工具使用(Tool Use)和链式推理(Chain-of-Thought),单次用户会话可能在后端触发数十次模型请求。这与简单的单轮问答在资源占用模式上截然不同——前者会持续占用推理槽位(inference slot)数秒乃至数十秒,对GPU显存和KV Cache的压力远高于短对话。若有多名用户同时发起此类重负载agent任务,服务的队列管理、请求调度和超时熔断机制都会接受严峻考验,这也正是自动化脚本压测难以真实模拟的部分。
OpenAI兼容接口背后的信号
接口采用OpenAI兼容格式,是近两年新兴模型服务的常见选择。无论是开源模型的自托管部署(如vLLM、Ollama、LM Studio等推理框架),还是新兴的推理服务商,几乎都把"OpenAI-compatible"作为降低接入门槛的标配。
这个细节暗示待测系统大概率是以下几种之一:
- 某个新模型或微调模型的早期服务版本
- 一套新的推理/托管基础设施,需要验证在真实负载下的稳定性
- 一个尚未品牌化、处于匿名测试阶段的产品
帖子刻意没有透露模型名称、提供方身份或任何性能指标,这种"盲测"式的匿名安排,也符合早期产品不愿过早暴露、希望收集中立反馈的心态。
OpenAI兼容接口的核心是对齐OpenAI的REST API规范,主要包括/v1/chat/completions、/v1/completions等端点,以及相同的请求/响应JSON结构。vLLM是目前最主流的开源推理框架之一,支持连续批处理(Continuous Batching)技术,能将不同长度的请求动态打包处理,显著提升GPU利用率;Ollama则更侧重本地单机部署的易用性;LM Studio面向桌面用户提供图形界面。这些框架都原生支持OpenAI兼容接口,使得任何基于OpenAI SDK编写的代码几乎无需修改即可切换到自托管或第三方推理服务,极大降低了早期产品获取真实用户测试的门槛。
参与前需要留意什么
对于有兴趣参与的开发者,有几点值得权衡。这类免费、匿名、需要DM获取访问凭证的测试,虽然多数是正当的内测招募,但也应保持基本的安全意识:不要在测试系统中输入敏感数据或私密代码,使用隔离的API密钥环境,并对要求提供额外权限的请求保持警惕。
从正面看,这是一个低成本接触早期AI产品的机会。参与者能提前体验可能尚未公开的模型能力,并通过反馈影响产品迭代方向。对于想了解推理服务在高并发下真实表现的工程师来说,这样的集中测试本身也是难得的观察窗口。
小结
这则看似简单的招募帖,折射出AI产品从开发到上线过程中一个容易被忽视的环节:真实并发下的服务验证。模型能力固然重要,但在生产环境中,并发稳定性、延迟一致性和长会话可靠性,往往才是决定用户体验的关键。通过招募少量真人进行协调式集中测试,开发者能以较小代价捕捉到自动化压测难以复现的真实流量特征。
需要说明的是,由于原帖信息极为有限——没有披露模型、提供方或测试结果,本文的分析更多是基于招募方式和技术细节的合理推断,而非对某个具体产品的确切判断。
相关推荐

Qodo CEO详解AI代码审查:当「智慧」比代码本身更值钱
OpenAI DevDay 2026访谈:Qodo创始人Itamar Friedman详解AI代码审查如何从提示工程演进到群体工程,用wisdom base编码化工程隐性知识,让审查agent与编程agent协作,重新定义「任务」单位。

OpenAI DevDay 2026:Codex 从单人到多人协作的AI工作革命
OpenAI DevDay 2026 上 Codex 团队提出从单人到多人协作的 AI 工作范式:通过 app shot、持续型 agent dot、space 协作空间与可共享插件,让整个团队与 AI agent 在单一事实来源上协同,摆脱个人成为瓶颈的困境。
Databricks上线Workday Data Connect联邦连接器:Unity Catalog打通HR数据
Databricks宣布Workday Data Connect联邦连接器在Unity Catalog进入公开Beta,支持通过查询联邦直接访问Workday的HR与财务数据,实现统一治理与跨域分析,降低ETL工程负担。