一次探索,多次评估:随机线性Bandit的多策略评估新方法

PRISMA算法通过共享采样与正则化信息共享,将K个策略的同时评估成本降至对数级别。
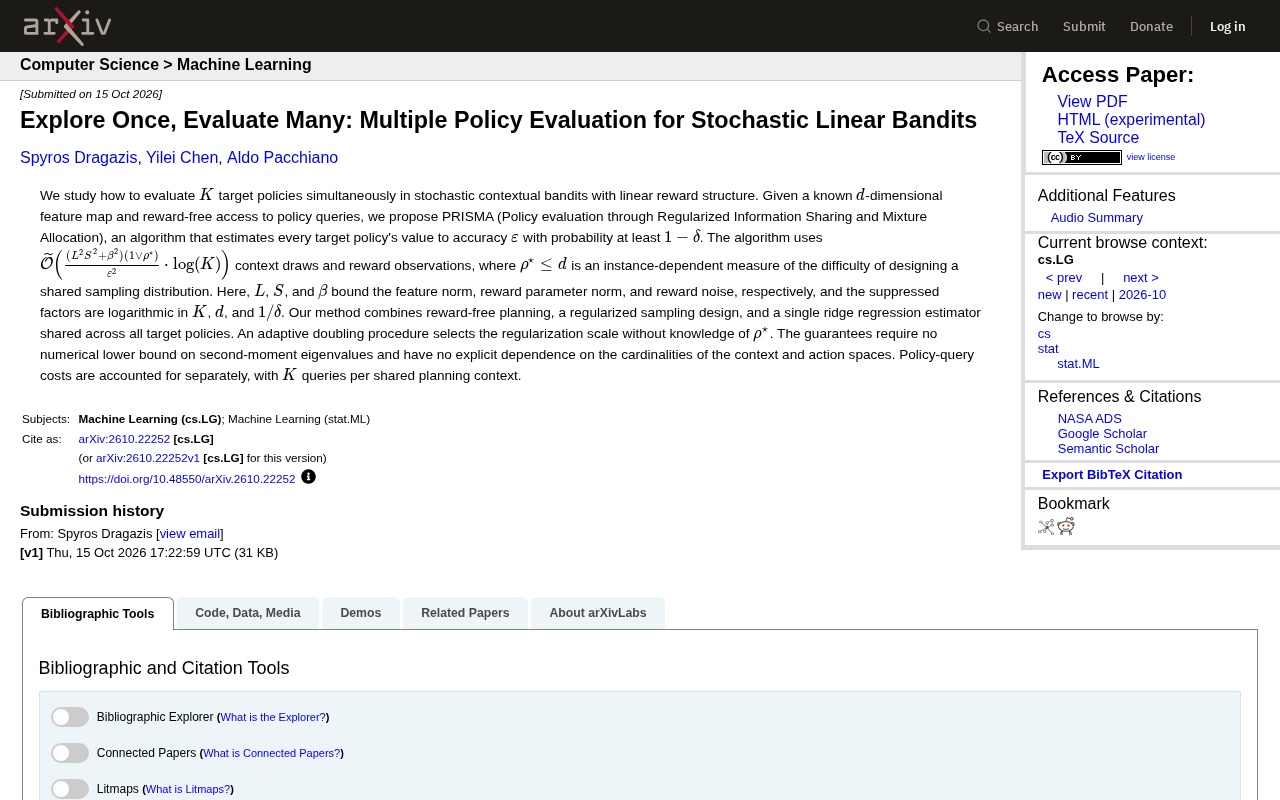
本文介绍了arXiv上提出的PRISMA算法,用于随机上下文Bandit中多个策略的同时价值评估。传统方法为每个策略独立采样,成本随策略数K线性增长;PRISMA通过“一次探索,多次评估”的共享采样设计,将样本复杂度降至O(log K)级别。算法包含无奖励规划、正则化采样设计和共享岭回归估计器三个组件,并引入实例难度度量ρ*来控制共享分布复杂度。理论上,其样本复杂度上界不显式依赖上下文和动作空间基数,也不需要二阶矩特征值下界,且通过自适应倍增过程无需预知ρ*。该方法基于线性奖励结构假设,适用于推荐系统A/B测试等需大量策略比较的场景,非线性扩展是未来方向。
在强化学习和推荐系统等场景中,同时评估多个候选策略的价值是常见需求。传统方法往往为每个策略单独收集数据,成本随策略数量线性增长。最近一篇来自arXiv的研究提出了PRISMA算法,通过共享采样设计,将$K$个策略的评估成本降至对数级别。
问题背景:多策略评估的成本困境
在随机上下文Bandit中,每个策略的价值评估都需要从环境中采样并观察奖励。如果目标是同时评估$K$个策略,最直接的做法是为每个策略独立设计采样方案,但这会导致$K$倍的样本复杂度。
该研究的形式化设定是:给定已知的$d$维特征映射,以及无奖励的策略查询接口(即可以查询策略在任意上下文下的动作,但不消耗奖励观测),算法需要同时估计所有$K$个目标策略的价值,并达到精度$\varepsilon$,置信度至少$1-\delta$。关键挑战在于,不同策略可能偏好不同的上下文区域,如何设计一个共享的采样分布,使得所有策略的价值估计都能高效收敛。
随机上下文Bandit(Stochastic Contextual Bandit) 是强化学习与统计学习交叉领域的一类经典序贯决策模型。在每个时间步,学习器观察到一个由环境生成的上下文(通常是一个特征向量),随后从可行动作集中选择一个动作,并仅能观察到该动作对应的奖励,而无法获知其他未选动作的反事实奖励。奖励通常被假设为上下文与动作的某个未知函数的噪声观测。该模型广泛应用于新闻推荐、广告投放、临床试验等场景。与完整强化学习不同,上下文Bandit不涉及状态转移,因而更易进行理论分析;与监督学习不同,它面临反事实推断的挑战——策略评估的目标正是利用一个行为策略收集的数据,去估计另一个目标策略的价值,这要求对分布偏移进行显式校正。
策略查询接口的无奖励特性:本文设定中,算法可以任意查询一个策略在给定上下文下的动作,而不消耗奖励观测预算。这一设定在推荐系统等场景中很自然:策略本身是一个计算函数(如深度学习模型),调用它只需算力,而获取用户真实反馈(奖励)则需要付出实际成本。将查询成本与奖励观测成本分离,使得算法可以先用查询来规划采样分布,再进行有限次的高效奖励观测。
PRISMA的核心机制:正则化信息共享
PRISMA(Policy evaluation through Regularized Information Sharing and Mixture Allocation)的核心思想是“一次探索,多次评估”。算法包含三个组件:无奖励规划、正则化采样设计、以及一个跨所有目标策略共享的岭回归估计器。
具体来说,PRISMA首先利用无奖励规划阶段,在不观察奖励的情况下探索环境,构建一个覆盖所有策略可能访问区域的上下文分布。这个分布通过混合分配(Mixture Allocation)来平衡不同策略的需求,使得每个策略的价值估计都能获得足够的信息。
正则化项则用于控制共享采样分布的复杂度。算法引入一个实例相关的难度度量$\rho^\star$(不超过特征维度$d$),它刻画了设计共享采样分布的固有难度。当$\rho^\star$较小时,说明策略之间共性较强,共享采样效率高;反之则难度增大。
岭回归估计器及其在Bandit评估中的作用:岭回归(Ridge Regression)是在普通最小二乘基础上加入L2正则项 $\lambda |\theta|_2^2$ 的线性回归方法,其闭式解为 $\hat{\theta} = (\mathbf{X}^\top \mathbf{X} + \lambda \mathbf{I})^{-1} \mathbf{X}^\top \mathbf{y}$。在Bandit策略评估中,岭回归被广泛用于从非均匀采样的数据中估计奖励参数 $\theta$,因为不同上下文被采样的概率不同,需通过重要性加权或直接对设计矩阵加权来校正偏差。正则项 $\lambda$ 不仅防止过拟合,还保证设计矩阵在样本不足时仍可逆,从而避免病态条件。PRISMA的共享估计器正是对所有目标策略共享同一组采样数据,因此其设计矩阵由混合分布决定,而岭回归的偏差-方差权衡直接受到混合分布质量的影响。
混合分配(Mixture Allocation)的含义:混合分配指将若干基础采样分布按一定权重组合成一个全局采样分布。在PRISMA中,每个目标策略对应一个理想的、能最小化其价值估计方差的分布(称为该策略的最优设计),但算法不能为每个策略单独采样,因此需要寻找一个混合分布,使其对所有策略的覆盖都足够好。混合权重的选择由正则化优化问题自动确定,目标是平衡各策略的估计误差。
样本复杂度与理论保证
论文给出的样本复杂度上界为$\widetilde{\mathcal{O}}\left( \frac{(L^2S^2+\beta^2)(1\vee\rho^\star)}{\varepsilon^2} \cdot \log(K) \right)$,其中$L$、$S$、$\beta$分别约束特征范数、奖励参数范数和奖励噪声,$\log(K)$项表明评估$K$个策略的成本仅随策略数量对数增长。
这一结果有几个值得注意的特点。首先,算法不需要关于二阶矩特征值数值下界的先验知识,避免了传统方法中常见的病态条件问题。其次,复杂度没有显式依赖上下文空间和动作空间的基数,这意味着方法可以扩展到大规模甚至连续空间。此外,策略查询成本被单独核算,每个共享规划上下文需要$K$次查询,这与奖励观测成本分离,更符合实际场景中查询和观测代价不同的情况。
样本复杂度中的各项参数解释:公式中的 $L$ 通常表示特征向量的范数上界,即对所有上下文 $x$,有 $|x|_2 \leq L$;$S$ 是真实奖励参数 $\theta^\star$ 的范数上界,即 $|\theta^\star|_2 \leq S$,它控制了价值函数的尺度;$\beta$ 则是奖励噪声(通常假设为亚高斯分布)的尺度参数,控制观测的随机波动幅度。$\rho^\star$ 是一个实例相关的难度量,其定义通常与设计矩阵的“有效秩”或策略间冲突程度有关,取值范围在 $1$ 到 $d$ 之间。$1 \vee \rho^\star$ 表示取 $1$ 与 $\rho^\star$ 的较大者。$\widetilde{\mathcal{O}}$ 记号隐藏了对数因子。整体来看,该上界对 $K$ 仅呈对数依赖,这是通过共享采样实现的,而传统独立采样方法会带来 $K$ 倍的线性增长。
二阶矩特征值下界假设为何重要:在许多线性Bandit分析中,算法需要知道设计矩阵的最小特征值有一个正的下界,才能保证岭回归估计的快速收敛。然而,实际中特征分布可能极度不平衡,最小特征值可能非常小甚至为零(例如某些方向从未被采样),此时经典结果会失效或需要显式探索。PRISMA通过自适应正则化和共享设计规避了这一要求,使其适用于更广泛的实例。
自适应正则化:无需预知难度参数
PRISMA的一个实用亮点是自适应倍增过程(Adaptive Doubling Procedure),它能够在不知道$\rho^\star$的情况下选择合适的正则化尺度。$\rho^\star$本身是实例相关的,实际中难以预先计算,自适应策略通过逐步调整正则化强度,在探索和利用之间取得平衡。
这种设计使得PRISMA在理论保证和实际可行性之间找到了较好的折中。论文的证明技术结合了无奖励规划、正则化最小二乘和统一收敛分析,为多策略评估问题提供了一个较为完整的理论框架。
自适应倍增过程(Adaptive Doubling Procedure) 是一种在未知问题参数时在线调整算法超参数的通用技术。其基本思想是:从某个初始猜测值开始,运行算法并监测某些统计量(例如估计误差或设计矩阵条件数),若发现当前参数过小导致不满足理论条件,则将参数翻倍并重新开始。由于参数的真实值通常在一个有限范围内,翻倍次数至多与参数的对数成正比,因此这种“猜测-验证-翻倍”的策略只会带来对数级别的额外开销。在PRISMA中,自适应倍增用于确定正则化强度 $\lambda$,使其与未知的 $\rho^\star$ 相匹配。这一过程虽然增加了实现复杂度,但避免了需要预先知道实例难度这一不切实际的要求,是理论结果走向实用化的重要一步。
潜在影响与局限
PRISMA的提出为多策略评估问题提供了新的理论工具,其对数级别的$K$依赖尤其适合需要同时比较大量候选策略的场景,如推荐系统A/B测试、医疗决策方案比较等。
不过,该方法目前基于线性奖励结构假设,对于非线性或更复杂的奖励模型,其适用性有待进一步研究。此外,$\rho^\star$虽然不需要预知,但其大小仍会影响实际性能,如何更紧地刻画这一参数也是未来方向。
总体而言,这项工作在随机线性Bandit的多策略评估领域迈出了重要一步,其“一次探索,多次评估”的思路对于降低策略评估成本具有启发意义。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。