一次向ChatGPT、Claude和Gemini提问并对比答案的3种方法

三种方法教你同时向多个AI提问,并通过对比答案发现模型盲点与自信错误。
文章指出,同时向多个AI提同一个问题是发现模型盲点和自信错误的高效方式,尤其适用于合同与提案审查、技术方案权衡、措辞选择和事实核查等没有唯一正确答案的场景,前提是问题必须逐字相同。文章给出三种实操路径:手动复制粘贴,适合两个模型的偶尔对比;LMArena等并排游乐场,适合探索模型差异但独立于个人账户;以及作者开发的Chrome扩展Qarta,可一次发送到多个已登录的AI账户并并排阅读,保留各自历史记录,Pro版每月10美元。文章最后按使用频率和场景给出选择建议,并披露作者与Qarta的利益关系,提醒读者自行评估。
同时问多个AI同一个问题,是发现模型盲点和自信错误的最快方式。本文介绍三种实操方法,从手动复制到工具自动化,并说明各自适用场景。
为什么值得同时问多个AI
ChatGPT、Claude和Gemini各有优势和盲区。当AI回答听起来过于自信时,把多个模型的答案并排对比,能快速发现某个模型遗漏或出错的地方。原文指出,在以下场景中对比尤其有价值:
- 审查合同、提案或计划,查找漏洞
- 技术设计选择及其权衡
- 重要邮件、推销话术或标题的措辞选项
- 事实核查——当一个AI自信地陈述某事时,看其他模型是否同意
关键原则:问题必须逐字相同。如果措辞改变,你就无法判断差异来自模型本身还是你的提问方式。
“模型盲点”与“自信错误”指向大语言模型的一个共性特征:模型的表达流畅度与答案正确性并不强相关,即使内容有误,措辞也可能同样笃定。这类错误有时被称为幻觉(hallucination),尤其在事实性细节、引用来源和数字上更容易出现。不同厂商在训练数据、对齐方式和检索能力上存在差异,因此各自的错误分布并不重合——这正是并行提问的价值所在:单一模型的错误未必会被它自己暴露,但往往会在另一个模型的答案中显出分歧。
方法一:手动复制粘贴
最直接的方式是复制问题,在每个AI的标签页中粘贴发送。对于两个助手来说这完全够用。
但三四个模型时就变得繁琐,答案散落在多个标签页中,交叉阅读本身也很费力。这个方法适合偶尔对比两个模型的场景。
方法二:并排模型游乐场
LMArena等网站提供并排模式,将一个提示发送给两个模型并展示双方回复。这是感受模型差异的好方法。
代价是:它独立于你自己的ChatGPT、Claude或Gemini账户,对话不会进入你常用的历史记录,也无法使用你平时工作的设置和上下文。适合探索性对比,不适合日常工作中的深度对比。
LMArena(前身为Chatbot Arena)是加州大学伯克利分校等机构的研究项目,最初用于以众包方式评估大语言模型的相对能力。用户输入提示后,两个匿名模型同时作答,用户投票选出更好的回复,这些投票会汇总成模型排行榜(Elo评分)。并排(side-by-side)模式正是基于这一机制演化而来,本质上是一个中立的第三方评测环境,因此它不绑定任何特定厂商的订阅账户,也无法调用你个人的系统提示词、文件上下文或自定义指令。
方法三:一次发送到自己的AI账户,再并排阅读
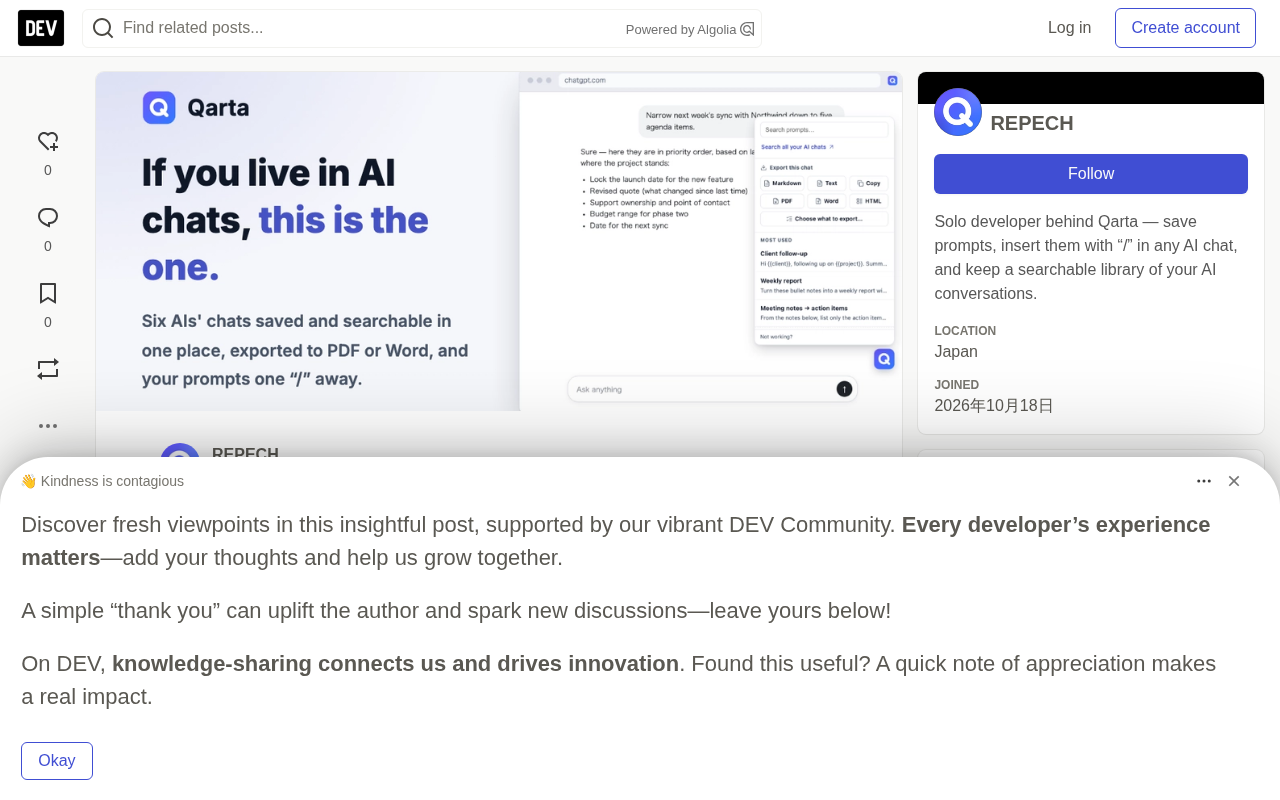
原文作者开发了一款Chrome扩展Qarta(已披露利益关系),可以一次将同一提示发送到多个AI:选择站点、发送,每个AI在独立标签页中打开并显示完全相同的文本。由于使用你正常的账户,每段对话也会保留在对应AI自己的历史记录中。
答案返回后,Qarta的聊天库将它们排列在同一屏幕上,便于一眼看出哪个回复最强。它支持ChatGPT、Claude、Gemini、Copilot(个人版)、Perplexity和Grok。
一次发送到多个AI以及并排视图属于Pro功能(每月10美元)。免费计划下,六个AI上的每段聊天仍会自动保存,最近30天可在一个地方搜索。
浏览器扩展通过内容脚本(content script)读取你当前页面中的输入框,再借助各AI站点自身的Web界面完成提交,因此不需要API密钥,也不会额外消耗API额度。由于提交走的是你已登录的会话,生成的对话会自然落进各平台的历史记录与项目空间。需要注意的是,这类扩展需要读取和修改目标站点的页面内容,安装前应确认其权限范围;同时各AI平台的服务条款对自动化操作可能有不同限制,大规模或高频使用前值得留意。
如何选择
- 两个AI、偶尔对比 → 手动操作,保持问题完全一致
- 探索模型差异 → 使用并排游乐场
- 定期对比自己的AI账户 → 使用Qarta这类工具一次发送、并排阅读
需要说明的是,方法三涉及作者自研工具,存在推广性质。读者可根据自身需求评估是否值得付费使用。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。