一根杆子编码整部百科全书?算术编码的奇妙世界

外星人用一根杆子编码百科全书的荒诞实验,揭示了算术编码将文本压缩为高精度实数的原理。
文章从Martin Gardner的外星人思想实验出发:外星人用一根一米长的杆子上的精确刻度记录整部百科全书,方法是将每个字符映射为数字对并拼成0到1之间的高精度实数。这个看似荒诞的设想,实际上正是现代压缩算法——算术编码的核心思想。算术编码按符号概率将单位区间不断细分,为任意长文本关联一个极小区间内的实数,使压缩精度接近信息熵而非字符数乘以固定位宽。文章进一步指出,压缩效率取决于对数据规律与概率分布的建模能力,因此压缩与智能之间存在深层联系,而算术编码正是这一理论的工程基石。
一个荒诞的思想实验
Martin Gardner 曾在一篇专栏中讲过一个故事:外星人造访地球,想带一件最能代表人类知识的物品回去。教授递上一整套百科全书,外星人却连连摇头——他的飞船对重量极其敏感,哪怕增加一纳克都会危及返程。随后他抽出一根一米长的细杆,说只要在杆上做一个位置精确的标记,就能把整部百科全书的内容记录下来。
教授自然大为震惊。外星人的解释是:你们的百科全书里不同字母和符号不到一百种,那就给每个符号分配一对数字,把每个字母替换成对应的数字对,再把这些数字对依次排开,前面加上「零点」,就得到一个位于 0 与 1 之间、精度极高的实数。他只要按这个比例在杆上刻下记号,回到母星后,同伴测量标记到起点的距离与杆长的比值,再展开成全部小数位,就能还原整部百科全书。
这个设想显然荒谬——据讲述者估算,大约五个字母之后,所需精度就已经细到原子尺度。但正是这个荒诞的设定,指向了一种真实存在且极为优雅的压缩技术。(截图来自视频,建议保留原字幕风格)
从杆子到硬盘:压缩的本质问题
真正值得追问的是:如果换成更现实的场景,比如教授交给外星人一块硬盘,那么把整部百科全书编码进去,最紧凑的方式是什么?如何用尽量少的比特表示它?
此时,外星人那套「用一个小数表示全部内容」的思路,反而比直觉中更接近正确答案。讲者指出,我们手上最好的压缩算法之一——算术编码(Arithmetic Coding)——基本上就是通过给任意长的文本序列关联 0 到 1 之间一个非常具体、精度极高的实数来工作的。
听起来有些奇怪,但背后的逻辑并不神秘。可以把每个符号的出现概率映射到单位区间的一个子区间,随着符号逐个读入,区间不断收窄,最终任意一段文本都对应一个极小区间内的实数。区间的收窄过程,本质上就是精度不断累积的过程,也解释了为什么「杆上刻度」与「压缩后的比特流」在这个思想实验里会走到一起。
单位区间是实数轴上从0到1的闭区间,长度为1。在算术编码中,它被当作整个概率空间:每个符号根据其出现概率被分配到该区间内的一个子区间,所有符号的子区间互不重叠且长度之和为1。编码开始时,当前区间就是整个单位区间;每读入一个符号,就把当前区间替换为该符号对应的子区间,区间长度按概率比例缩小。由于区间不断收窄,最终任意一段文本都对应一个极小的子区间,其中任意一个实数都能唯一标识这段文本。这种“区间嵌套”的几何视角,正是理解算术编码如何用一个小数表示任意长序列的关键。
算术编码为什么重要
要理解算术编码的价值,需要先放下「每个符号固定用几位表示」的直觉。传统定长编码给每个字符分配相同长度的码字,而算术编码按概率分配区间宽度:高频符号占据更宽的区间,低频符号只占很窄的一段。这样一来,整段文本被压缩成一个实数,其精度大致等于信息量,而不是字符数量乘以固定位宽。
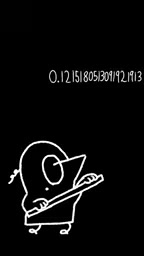
这也解释了为什么视频把算术编码与「智能」联系在一起。压缩效率的上限,取决于对数据规律与概率分布的建模能力;模型越理解数据,就越能逼近理论上的信息熵。从这个角度看,压缩不只是存储技巧,也是衡量理解深度的一把尺子。
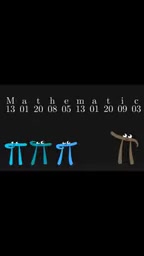
当然,工程实现上还有精度限制、有限状态和计算复杂度等现实约束,算术编码并非没有代价。它真正的启示在于:一个看似不可能的思想实验,经过合理改造后,可以成为现代数据压缩的理论基石。下次再看到「把整本书压缩成一个数」这类说法,不妨想想那根一米长的杆子——它离现实,也许只差一块硬盘的距离。
信息熵(Information Entropy)是香农信息论中的核心概念,用于衡量一个随机变量或数据源的不确定性。对于由符号组成的文本,熵给出了每个符号平均所需的最少比特数,是任何无损压缩算法理论上无法突破的下限。算术编码之所以被视为高效,正是因为它能渐进地逼近这一熵极限:当符号的概率模型与真实分布一致时,编码结果的平均长度可以任意接近信息熵。反之,如果模型对数据分布估计不准,编码效率就会下降。因此,压缩算法的性能不仅取决于编码机制本身,更取决于对数据统计特性的建模精度,这也是现代压缩系统常将算术编码与上下文建模、混合模型等技术结合使用的原因。
定长编码与变长编码是数据压缩中的两种基本策略。定长编码为每个符号分配相同长度的码字,例如ASCII用7位或8位表示一个字符,实现简单但无法利用符号出现频率的差异。变长编码则根据符号概率分配不同长度的码字,高频符号用短码、低频符号用长码,从而降低平均码长,霍夫曼编码是典型代表。算术编码属于变长编码的极端形式,它不再为单个符号分配整数位码字,而是将整段消息映射为一个实数,从而突破“每个符号至少1比特”的整数位限制,在概率分布不均匀时尤其高效。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。