医疗大模型不可验证推理之困:神经符号方法能否破局?

临床大模型评估需从答案正确性转向推理可验证性,架构决定安全。
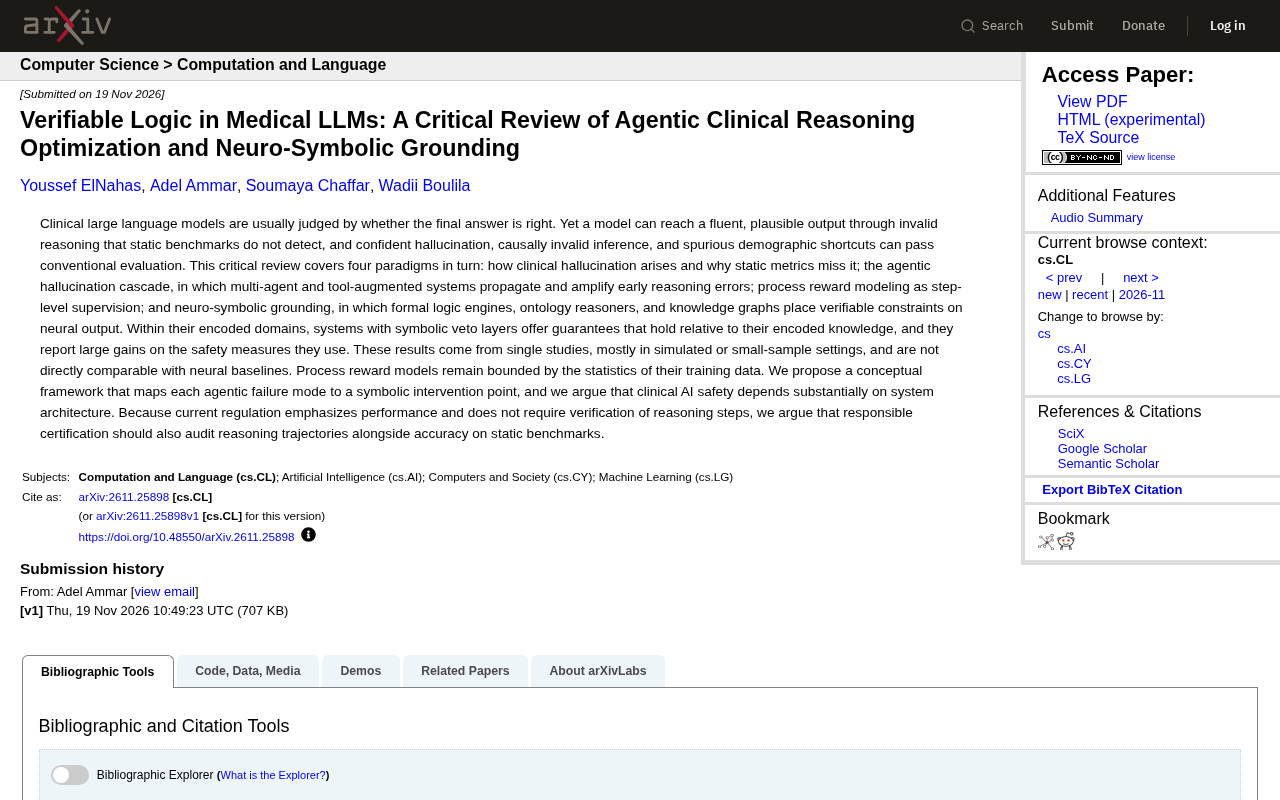
本文批判性综述了临床大语言模型评估的深层缺陷:静态基准仅关注最终答案正确性,无法检测通过无效推理得出的流畅输出,自信幻觉、因果无效推断和虚假人口统计学捷径均可蒙混过关。文章依次探讨四种范式:临床幻觉的根源与静态评估盲区;多智能体和工具增强系统中的“智能体幻觉级联”,即早期错误被传播放大;过程奖励建模实现步骤级监督,但受限于训练数据覆盖与标注成本;神经符号接地通过逻辑引擎、本体和知识图谱施加可验证约束,在其编码知识范围内提供保证,但证据多来自单一研究和小样本模拟。核心论点是临床AI安全在很大程度上取决于系统架构,监管认证应同时审计推理轨迹与静态准确性。
临床大语言模型通常以最终答案的正确性来评判。但一个模型可能通过无效推理得出流畅、看似合理的输出,而静态基准测试无法检测到这一点。自信的幻觉、因果无效的推断以及虚假的人口统计学捷径,都可能通过常规评估。这篇批判性综述依次探讨了四种范式:临床幻觉如何产生以及为何静态指标会遗漏它;智能体幻觉级联,即多智能体和工具增强系统会传播并放大早期推理错误;过程奖励建模作为步骤级监督;以及神经符号接地,其中形式逻辑引擎、本体推理器和知识图谱对神经输出施加可验证的约束。
临床幻觉的根源与静态评估的盲区
临床大语言模型的评估长期聚焦于最终答案的准确性,但这一范式存在根本性缺陷。模型可能通过无效推理路径得出正确结论,也可能以流畅但错误的逻辑误导使用者。原文指出,自信的幻觉、因果无效的推断以及虚假的人口统计学捷径,都能轻易通过传统静态基准测试。这意味着,仅凭答案正确性无法保证推理过程的可靠性,而临床决策恰恰依赖可追溯、可验证的推理链条。
静态指标之所以失效,是因为它们只捕捉输入与输出之间的表面关联,而忽略了中间推理步骤的合理性。在医疗场景中,一个基于错误因果假设的答案可能恰好与正确答案一致,但这种“幸运的正确”在真实临床环境中极其危险。
幻觉(Hallucination) 在临床大语言模型语境下,指模型生成看似合理、流畅但与事实不符或缺乏依据的内容。与一般领域不同,临床幻觉可能表现为虚构不存在的指南条目、错误关联药物与适应症、或编造实验室参考范围。其根源包括训练数据中的噪声与偏差、模型对长尾知识的覆盖不足,以及自回归生成机制对流畅性的偏好压倒事实性。静态基准通常只比对最终答案与金标准,无法捕捉推理链中悄然引入的错误前提,因此“自信的幻觉”得以蒙混过关。理解幻觉的生成机制,是设计步骤级检测与符号约束的前提。
智能体幻觉级联:多智能体系统的放大效应
随着多智能体系统和工具增强架构的兴起,幻觉问题呈现出新的传播特征。原文提出“智能体幻觉级联”概念:在多智能体协作中,早期推理错误会通过智能体间的交互被传播和放大。一个智能体的错误输出可能成为另一个智能体的输入前提,从而在系统层面形成连锁反应。工具调用虽然扩展了模型能力,但也引入了新的错误注入点——工具返回的噪声结果可能被模型错误解读并进一步传播。
这种级联效应意味着,单智能体场景下的幻觉检测方法无法直接迁移到多智能体系统。系统架构本身成为影响安全性的关键变量,而非仅仅是模型参数或训练数据。
智能体(Agent) 指能够自主感知环境、调用工具并采取行动以完成目标的大模型驱动系统。在医疗场景中,智能体可拆分为分诊、检索、推理、审核等角色,通过多轮交互协作。工具增强则赋予智能体调用外部资源(如电子病历查询、医学计算器、文献检索)的能力。然而,每个智能体的输出都可能成为下游智能体的输入前提,一旦早期环节产生幻觉,错误便沿调用链传播并被后续环节“合理化”,形成级联放大。工具返回的噪声或格式异常也可能被误读为有效证据。因此,多智能体系统的安全性不仅取决于单个模型,更取决于编排架构与错误隔离机制。
过程奖励建模:步骤级监督的进展与边界
过程奖励建模(Process Reward Modeling)代表了从结果监督向步骤级监督的转变。通过对推理链的每一步进行奖励建模,系统可以识别并惩罚无效的中间推理,而不仅仅是最终答案。这一方法在理论上能够捕捉静态基准遗漏的推理缺陷。
然而,原文也明确指出其局限性:过程奖励模型仍然受限于其训练数据的统计特性。如果训练数据中缺乏对特定推理错误模式的覆盖,模型就难以在新的错误类型上做出准确判断。此外,过程奖励建模的计算开销和标注成本也限制了其在大规模临床场景中的直接应用。
过程奖励建模(Process Reward Modeling, PRM) 与传统的结果奖励建模(Outcome Reward Modeling, ORM) 相对:后者只对最终答案给奖励,前者对推理链的每一步中间状态打分。PRM 通常需要步骤级标注数据,或通过蒙特卡洛树搜索、自动验证等方式生成步级标签。在数学与代码推理中,PRM 已被证明能有效识别无效中间步骤并引导模型自我纠错。迁移到临床领域时,挑战在于医学推理步骤的“正确性”往往依赖上下文与指南版本,标注成本高且存在专家分歧;同时,PRM 的奖励模型本身可能继承训练数据的偏差,对罕见错误模式缺乏判别力。
神经符号接地:可验证约束的承诺
神经符号接地是四种范式中最具结构性的方案。形式逻辑引擎、本体推理器和知识图谱为神经输出施加可验证的约束,使系统能够在编码知识范围内提供保证。原文指出,带有符号否决层的系统在其编码领域内能够提供相对于编码知识成立的保证,并且在其采用的安全度量上报告了大幅提升。
这种方法的吸引力在于,它将推理验证从统计层面提升到逻辑层面。符号系统可以明确拒绝违反逻辑规则或本体约束的输出,从而在架构层面阻断部分幻觉路径。但原文也审慎地指出,这些结果来自单一研究,且大多在模拟或小样本设置下获得,不能直接与神经基线进行比较。符号否决层的保证仅相对于其编码知识成立——编码知识本身的不完备性或错误仍是潜在风险源。
神经符号接地(Neuro-symbolic Grounding) 指将神经网络(擅长感知与语言生成)与符号系统(擅长逻辑推理与知识表示)结合,使神经输出受到形式化知识的约束与验证。本体(Ontology) 是对某一领域概念、属性及关系的显式形式化规范,如 SNOMED CT、ICD 等医学本体;知识图谱则以图结构存储实体与关系,支持多跳查询。符号否决层在神经模型输出后施加逻辑规则或本体约束,若输出违反规则则拒绝或修正。该方法的核心优势是可解释、可审计,但其保证是“条件性”的:仅当编码知识完备且正确时,否决才可靠;知识库的覆盖盲区与更新滞后仍是风险来源。
架构决定安全:一个概念框架与监管启示
原文的核心论点是:临床AI安全在很大程度上取决于系统架构。作者提出了一个概念框架,将每种智能体失败模式映射到相应的符号干预点。这一框架的实践意义在于,它指导系统设计者根据失败模式选择验证机制,而非依赖单一的事后评估。
从监管角度看,当前法规强调性能指标,并不要求对推理步骤进行验证。原文因此主张,负责任的认证应当同时审计推理轨迹和静态基准上的准确性。这意味着认证标准需要从“答案是否正确”扩展到“推理是否可验证”,而神经符号架构为此提供了技术基础。
综合来看,这篇综述揭示了医疗大模型评估的一个深层矛盾:答案正确性与推理可靠性之间的鸿沟。过程奖励建模和神经符号接地分别从统计学习和逻辑约束两个方向尝试弥合这一鸿沟,但前者受限于数据分布,后者受限于编码知识的完备性。多智能体系统的幻觉级联则提醒我们,安全问题的层次正在从单模型向系统架构迁移。在监管层面,将推理轨迹纳入认证审计,或许是推动临床AI从“表现良好”走向“可信赖”的关键一步。
相关推荐
Yung Pueblo谈自我觉察:一本365天的心灵变革指南
Yung Pueblo在Talks at Google访谈中分享新书《Journey》的365天自我觉察结构,探讨冥想、直觉、关系共同领导与感恩实践,提出与改变做朋友的日常行动建议。
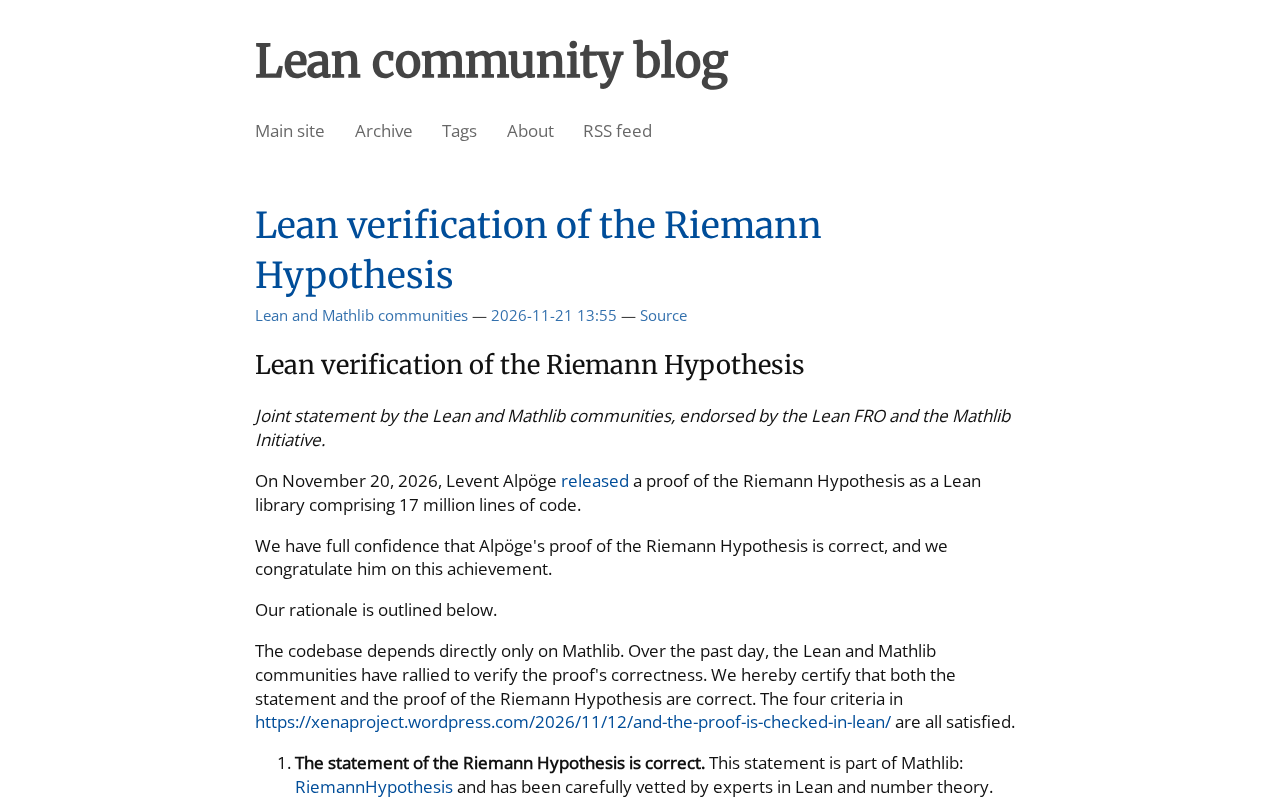
黎曼猜想被Lean形式化验证?联合声明引发热议
Lean社区博客发布黎曼猜想形式化验证联合声明,在Hacker News引发359分、263条评论的热议。本文解析Lean与mathlib的形式化验证背景、社区两极反应,以及为何在读到原文前不宜断言黎曼猜想已被证明。

FBI与USDA遭黑客攻击:关键基础设施安全再响警报
FBI与USDA据报遭黑客攻击,FBI近几个月内第二次被入侵,本次目标为国家犯罪信息中心(NCIC)。本文分析事件细节、NCIC的战略价值及政府机构面临的共性安全挑战。