一条命令搭建本地AI服务器:ODS开源部署LLM/RAG/绘图全攻略
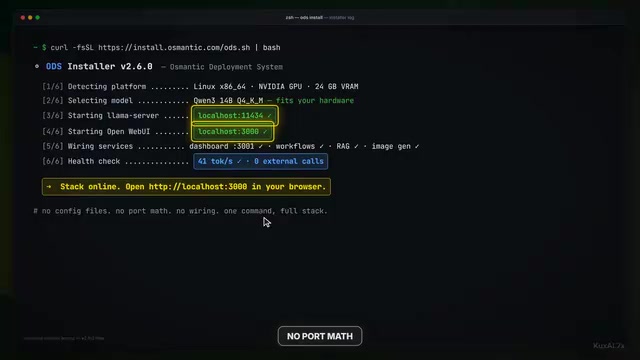
ODS用一条命令搭建覆盖LLM、RAG、图像生成的完整本地AI环境,彻底消除自托管的配置摩擦。
ODS(Osmatic Deployment System)是一个开源本地AI全家桶,目标是用单条命令完成LLM推理、网页聊天界面、RAG、语音智能体、工作流和图像生成的完整部署与互联。它支持Linux(NVIDIA/AMD/Intel Arc)、Windows(WSL2)和macOS(Apple Silicon),并通过预设端口约定(如OpenWebUI固定在localhost:3000)消除多服务并行时的端口冲突问题。项目采用Apache 2.0许可,GitHub约6300星,由Osmatic公司主导,当前稳定版为V6.0。文章同时指出本地部署的真实代价:云端订阅费被替换为电费、硬件和时间成本,GPU显存是关键瓶颈,隐私承诺需通过监控自身网络流量来验证而非凭信任接受。
周六早上端着咖啡坐下来,想在自己的机器上跑个本地AI,四小时后却开了七个浏览器标签页,终端在狂报端口冲突,三个装了一半的工具互相不认,配置文件像用某种人类不该读懂的语言写的——如果这个场景让你似曾相识,那么一个叫 ODS(Osmatic Deployment System)的开源项目或许值得你关注。它的目标很直接:用一条命令,把自托管AI环境搭起来的摩擦彻底抹平。
ODS 是什么:一条命令的本地AI全家桶
ODS 是一个完全本地化的 AI 技术栈,覆盖了 LLM 推理、ChatGPT 风格的网页聊天界面、语音智能体、工作流、RAG(检索增强生成)、图像生成以及隐私工具。核心卖点是:你只需要运行一条命令,它就会在你自己的硬件上安装并把这些组件全部串联起来。
平台支持相当具体,而非含糊其辞:
- Linux:支持 NVIDIA、AMD 以及 Intel Arc GPU
- Windows:通过 WSL2,支持 NVIDIA 和 AMD
- macOS:原生支持 Apple Silicon(走 Metal)
传统玩法里,你要自己装模型、把 OpenWebUI 硬塞进 Docker 容器、再拼上文档搜索、单独的语音组件、工作流引擎、图像生成器,最后手动把它们接起来让彼此能对话——这正是大多数人在周六下午崩溃退出的原因。ODS 则把这一整套环境、模型挑选、服务启动和底层配置一次性搭好。
其中几个核心组件值得单独说明。RAG(检索增强生成) 是一种让语言模型在回答问题时实时检索外部文档库的技术——它解决的问题是:纯语言模型的知识截止于训练时间点,而RAG让模型能"查阅"你自己的私有文档或知识库,生成更准确、有来源依据的回答,且无需重新训练模型。OpenWebUI 则是一个开源的ChatGPT风格网页聊天界面,可以连接Ollama等本地推理后端,是目前本地AI部署中最流行的前端之一。语音智能体组件通常涵盖语音转文字(STT)和文字转语音(TTS)两个方向,使整套系统可以通过语音交互,而非仅限于文字输入。这些组件在传统手动部署中各有独立的依赖环境和配置格式,彼此之间缺乏标准化接口,ODS的价值正在于把这些异构服务的对接层统一处理掉。
它如何终结“Docker端口地狱”
真正让人头疼的,往往不是跑模型本身,而是搞清楚“哪个服务在抢哪个端口”。ODS 在这方面做了预设约定,这也是它最实用的细节之一。
在 Linux 上,Docker 默认把 Llama 服务器装在 localhost:11434,容器在内部与之通信;macOS 使用原生 Metal;Windows 路径使用 8080 端口(除非手动覆盖);而 OpenWebUI 统一保持在 localhost:3000。换句话说,那些你曾经花一下午去排查的端口冲突,ODS 直接替你规划好了——这一个细节本身就足够省心。
从流程上看,操作被压缩到了极致:选择你的系统 → 复制命令 → 在普通终端运行 → ODS 安装整套环境、按硬件挑选合适模型、启动各项服务,最后把本地网页界面交到你手上。
可信度:谁在做,热度如何
面对“陌生人的脚本”,谨慎是对的。ODS 背后是美国公司 Osmatic,其 Odyssey 仓库能把 PC、Mac 或 Linux 机器变成一台 AI 服务器。
项目采用 Apache 2.0 许可,GitHub 约有 6300 颗星,最近一次活跃更新在 9 月 10 日(2026)。相比星标数,持续的活跃更新更值得关注——一个只有漂亮 README 却已废弃的仓库,才是真正会毁掉你周末的陷阱。
主导者的背景也颇有分量:曾管理超过 6500 万美元的年度运营,后转向 AI 基础设施与本地部署领域,是 AMD Lemonade SDK 挑战赛获胜者、SDK 贡献者。这不是业余玩具,而是一次让自托管 AI 变得“无聊”(以最好的意义)的严肃尝试。
稳定版 vs 主分支:一句难得的坦诚提醒
一个值得记住的版本细节:V6.0 是当前稳定版本,而主分支更新很快,适用于活跃开发。
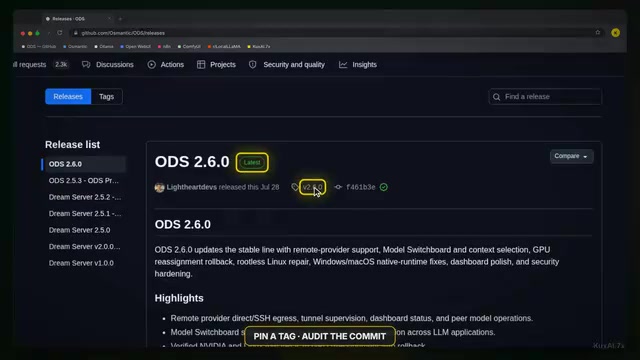
官方明确建议:对于任何类似实验室或接近生产环境的用途,应该锁定一个带标签的发布版或经过审计的提交,并保留你自己的验证记录。这种“别在严肃环境里跑前沿版本”的坦诚,在开源工具的宣传里其实并不常见,也从侧面反映了项目的成熟度。
为什么选择本地优先:成本与锁定的账
本地部署的意义,不只在于技术洁癖。
托管云 AI 的商业模式天然倾向于“收租”:当你把每个提示都通过托管 API 传输,付的不只是 Token 费,还是在为一个永不停转的计费表付费。更隐蔽的是供应商锁定——你的提示、微调、嵌入,乃至团队的操作习惯,都逐渐绑在对方的仪表盘上,等价格悄然上涨时,迁移成本已经很高。
ODS 在 Apache 2.0 下免费开源,意味着可以商用、修改、二次开发,无需担心自动续费。这才是真正意义上的自由。
但本地部署不是“魔法般免费”
必须直说:本地部署并非零成本,你只是把云账单换成了电费、硬件和你自己的时间。没有像样的 GPU,推理只能跑在 CPU 上,速度会很慢。所以在复制任何命令前,先做枯燥的功课:检查 GPU、检查显存、检查可用磁盘空间——全套模型加上图像生成,对存储的胃口不小。
实操建议:聪明地上手
如果你决定尝试,可以参考这套稳妥的操作路径:
- 从稳定版开始,而非主分支。对你在意的任何东西,固定一个带标签的发布版或经过审计的提交。
- 在备用机器或全新环境中运行,让失败的实验不会毁掉你的主力机。
- 启动后用真实工作压力测试。访问
localhost:3000打开 WebUI,在取消任何订阅之前,用实际任务验证它是否真能替代——目标是“可用的替代”,而不是半路陷入困境。 - 把隐私当作要去验证的功能,而不是想当然的承诺。图像生成在本地运行、提示词不发往托管 API——这些都应通过观察你自己的网络流量来确认,而不是听信任何人(包括视频作者本人)的话。
写在最后
便利经济让一代人相信“拥有工具比租用更难”。但真正难的部分,一直只是设置摩擦,而这恰恰是 ODS 这类项目要消除的东西。一旦接线自动化完成,天平就会向你倾斜:你的模型、你的数据、你的机器、你的设置——没有计费表在你睡觉时偷偷转动。
当然,选择权仍在你手里:是乐于每月付费换取零麻烦,还是无法预测的账单会让你彻夜难眠?这个问题没有标准答案,它更多反映的是你对“控制权”的态度。
背景补充
理解为什么端口冲突在本地AI部署中如此普遍,需要了解一点背景。Docker的容器化机制允许每个服务独立运行,但所有容器最终都通过宿主机的网络接口对外暴露端口。当Ollama、LiteLLM、OpenWebUI、Stable Diffusion WebUI等多个服务同时运行时,如果各自使用默认端口(如多个服务都试图占用8080),就会产生绑定冲突导致启动失败。更隐蔽的问题是服务发现:WebUI需要知道推理后端的地址,工作流引擎需要调用RAG服务的API,这些内部依赖关系如果没有统一规划,容器间通信就会断掉。ODS通过预先约定端口分配方案,并生成对应的网络配置,把这个"每次手动部署都要重新解决一遍"的问题变成了一次性的固化结论。
显存(VRAM)是本地LLM推理中最关键的硬件约束,值得具体了解。以目前主流的开源模型为例:一个7B参数模型以4-bit量化运行大约需要4-6GB显存,13B模型约需8-10GB,70B模型即便量化也往往需要40GB以上。如果显存不足,推理会自动降级到CPU或将部分层卸载到内存,速度会从每秒数十个Token骤降到个位数甚至更慢,实际体验差距极大。图像生成(如Stable Diffusion)则通常需要额外4-8GB显存来运行基础模型。因此在运行ODS之前,用nvidia-smi(NVIDIA)或对应的AMD工具确认可用显存,再对照目标模型的量化规格,是避免"安装成功但用不了"的必要前置步骤。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。