一行代码,让AI Agent学会看YouTube
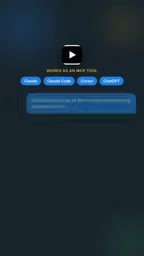
YouTube Transcripts MCP 工具让 AI Agent 一次调用获取结构化视频字幕 JSON。
本文介绍了一款名为 YouTube Transcripts 的 MCP 工具,它通过标准化协议让 Claude、Cursor、ChatGPT 等 AI Agent 只需一次工具调用,即可将任意 YouTube 视频、Shorts 或整个频道的字幕转换为干净的结构化 JSON 数据。输出包含完整文本、带时间戳的片段、语言信息和视频元数据,格式统一,便于下游处理。工具支持批量处理 URL 列表或频道句柄,并集成 Python、Curl、N8n、Make、Zapier 等平台,已运行近五十万次并提供免费试用。文章分析了该工具对 AI Agent 生态的意义,并给出上手建议与适用场景,同时指出转录准确性、语言支持范围等细节尚待确认。
给AI Agent装上“看视频”的眼睛,正在成为现实。一个名为 YouTube Transcripts 的 MCP 工具,号称只需一次调用,就能把任意 YouTube 视频、Shorts 或整个频道的字幕,变成干净整洁的 JSON 数据。从 Claude 到 Cursor 再到 ChatGPT,你只需要给 Agent 一个视频链接,字幕就会作为工具调用的结果返回到对话中,直接等待摘要。这种“即插即用”的体验,正在改变我们构建视频数据处理工作流的方式。
核心理念:把字幕获取变成一次工具调用
这个工具的核心价值在于将复杂的视频字幕抓取流程封装为一个标准化的 MCP 接口。MCP(Model Context Protocol)正在成为连接 AI 代理与外部工具的重要协议,而这个工具正是基于此协议构想的。
它的工作方式非常直观:当你在 Claude、Cursor 或 ChatGPT 中提出“帮我总结一下这个视频”并附上链接时,Agent 会主动调用 YouTube Transcripts 工具。返回的不是需要二次解析的原始文本,而是一行结构化的 JSON 数据。这行 JSON 里包含了完整的字幕文本、带时间戳的片段、语言信息以及视频的元数据。
这意味着开发者不需要再为字幕的格式不统一而烦恼。无论是长视频、短视频还是整个频道的内容,输出格式都是一致的。对于需要处理大量视频内容的 AI 代理来说,这种一致性是简化开发流程的关键。
MCP(Model Context Protocol)是由 Anthropic 于 2024 年底提出的开放协议,旨在为 AI 应用提供一种标准化的方式来连接外部数据源和工具。它采用客户端-服务器架构:AI 应用(如 Claude Desktop、Cursor)作为客户端,通过统一的 JSON-RPC 接口调用实现了 MCP 协议的服务器,从而访问文件系统、数据库、API 等资源。MCP 的核心价值在于解耦:开发者无需为每个 AI 平台单独编写集成代码,只需实现一次 MCP 服务器,即可被所有支持该协议的客户端使用。这与传统的插件或函数调用机制相比,大大降低了工具生态的碎片化程度,正逐渐成为 AI Agent 工具集成的事实标准之一。
数据结构:干净、完整、可追溯
工具的输出设计强调“每个视频就是一行干净的 JSON 数据”。这听起来简单,但对于后续的数据处理来说至关重要。
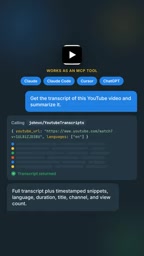
一行 JSON 包含了完整字幕文本、带时间戳的片段、语言以及视频元数据。这种结构化设计让下游任务变得简单。例如,当你需要按时间段搜索特定内容时,时间戳片段就派上了用场;当你需要区分多语言视频时,语言字段可以直接用于筛选。元数据则帮助 Agent 理解视频的来源、标题等信息,为更复杂的推理提供上下文。
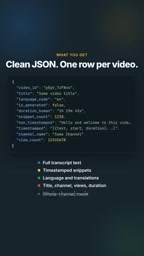
这种设计理念背后是对“训练数据”和“视频搜索”场景的深刻理解。对于训练数据准备来说,结构化的字幕可以直接作为语料输入;对于视频搜索来说,时间戳和文本的对应关系是构建索引的基础。工具方将这些需求直接内化到了输出格式中。
时间戳片段(timestamped snippets)通常指字幕被切分为若干短句或短语,每个片段附带起始和结束时间(如 "start": 12.5, "end": 15.2, "text": "...")。这种结构对于视频内容检索至关重要:当用户搜索某个关键词时,系统可以快速定位到视频中出现该词的具体时间点,并生成可点击的跳转链接。此外,时间戳片段还便于按时间窗口提取内容(如“总结第 5 到 10 分钟的内容”),或与视频帧对齐进行多模态分析。在训练数据准备中,时间戳信息可以帮助构建更精细的监督信号,例如将文本片段与对应的视觉场景关联起来。
批量处理与多平台集成
除了单次调用,这个工具还支持批量处理。你可以给 Agent 发送一个 URL 列表或一个频道句柄,让它一次性转录多个视频。更重要的是,它明确列出了 Python、Curl、N8n、Make 和 Zapier 等集成方式。
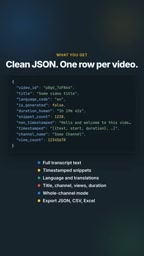
这种多平台覆盖表明,工具的设计者希望它能够无缝嵌入到各种自动化工作流中。无论是代码驱动的 Python 脚本、命令行工具 Curl,还是低代码自动化平台 N8n、Make 和 Zapier,都可以成为触发转录的入口。对于内容再利用和视频搜索这类需要大规模处理视频的场景,批量能力是必不可少的。
素材中提到,该工具已经运行了近五十万次(Nearly half a million runs)。这个数字虽然无法独立验证,但暗示了它在实际使用中具备一定的可靠性。工具方也提供了免费试用的入口,地址为 apify.com/johnvc/youtubetranscripts。
低代码自动化平台(如 N8n、Make、Zapier)通过可视化的工作流编辑器,让用户以拖拽方式连接各种应用和服务。它们通常提供 Webhook、定时触发、条件分支等节点,而 MCP 工具可以作为其中的一个“动作”节点被调用。以 N8n 为例,用户可以在工作流中设置一个 HTTP Request 节点指向 MCP 服务器的端点,或将 MCP 工具封装为自定义节点,从而实现“当频道更新时自动转录新视频并存入数据库”的自动化流程。这种集成方式显著降低了非开发者使用 AI 能力的门槛,也使得视频字幕数据能够无缝流入现有的内容管理系统、数据分析管道或营销自动化工具中。
对AI Agent生态的意义
这个工具的出现,反映了 AI Agent 生态的一个趋势:将特定能力封装为标准化接口,让 Agent 通过工具调用组合出复杂功能。字幕获取看似是一个小功能,但它解决了 Agent “理解视频内容”的第一步。
对于构建“看视频的 Agent”的开发者来说,这意味着不需要从零开始处理 YouTube 的页面解析、反爬策略和格式转换。工具调用返回的干净数据,可以直接进入后续的摘要、问答或检索流程。从内容再利用的角度看,一键获取结构化字幕,也让视频转文章、视频转笔记等应用的门槛大幅降低。
当然,这种依赖第三方工具的方案也有其边界。工具的稳定性、对 YouTube 平台变化的适应能力,以及大规模使用时的成本,都是开发者需要评估的因素。但至少从目前的信息来看,它提供了一个值得尝试的起点。
上手建议与适用场景
如果你正在构建需要处理视频内容的 AI 代理,可以按以下思路评估这个工具:
- 快速验证:利用免费试用额度,在 Claude 或 Cursor 中测试单视频转录的准确性和格式是否符合预期。
- 工作流集成:如果已有 N8n 或 Make 的自动化流程,可以尝试将频道转录接入,用于内容监控或素材收集。
- 数据准备:对于需要构建视频搜索或训练数据集的团队,批量转录功能可以显著减少数据清洗的工作量。
需要留意的是,素材中并未提供关于转录准确性、支持的语言范围、对私有视频或地区限制视频的处理能力等细节。这些都是在实际采用前需要进一步确认的关键信息。
相关推荐

阿尔茨海默病可防可控:神经科医生的五大护脑法则
神经科医生指出阿尔茨海默病主要是大脑代谢性疾病,显著可预防。本文解析五大可控风险因素:摆脱药物依赖心态、拒绝久坐、优化饮食选择,并探讨基因与生活方式如何共同决定痴呆风险。

循环Transformer中专家重选机制与单循环税复现
Reddit讨论揭示小型循环Transformer中每轮循环重新选择专家的重要性,并复现了“单循环税”现象,为循环MoE架构设计与评估提供实践参考。

Uber确认数据泄露:数千司机驾照信息经由Fireworks AI被盗
Uber确认数千名司机驾照信息在数据泄露中被盗,数据由AI云公司Fireworks AI存储。本文分析AI供应链安全盲区、企业采购AI服务的风险及应对建议。