一张照片+语音录音,生成身份锁定说话视频的本地工作流

从一张静态照片到会说话的视频
近日,一位开发者在 Reddit 上分享了一套基于 LTX-2.3 的本地化工作流,实现了一个颇具想象力的功能:输入一张静态照片,输出一段身份锁定的说话视频。整个过程无需换脸(face swap),也不需要驱动视频(driving video),仅凭一张参考图和一段文本提示(或用户自己的语音录音)即可完成。
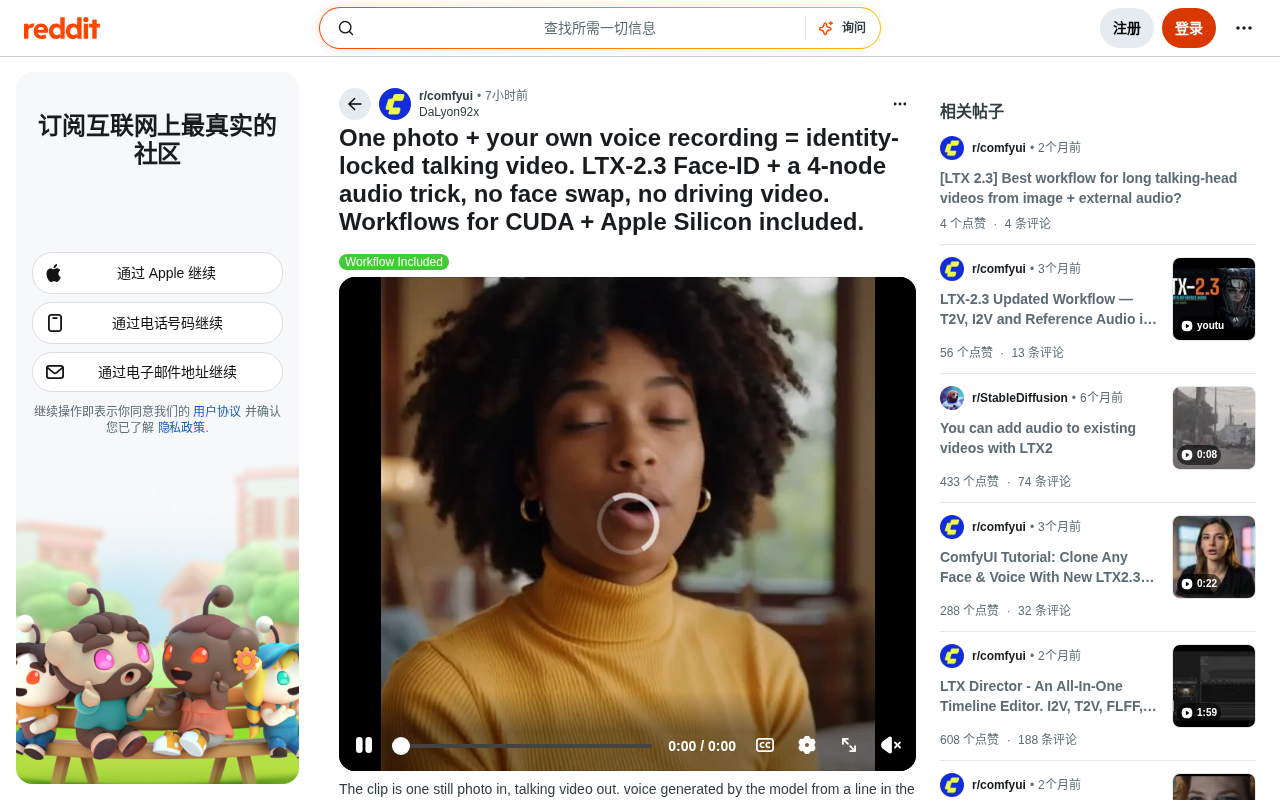
这套方案最引人注目的地方在于它的"身份锁定"(identity-locked)特性——生成的人脸严格对齐参考照片中的人物,且在多次生成中保持一致的外貌和声音。更重要的是,它能够完全在本地运行,作者演示时使用的是一台 M5 Pro 笔记本电脑。
核心技术:Face-ID 与音视频联合去噪
两种语音生成模式
该工作流内置了一个关键开关,提供两种截然不同的语音生成方式:
-
对口型模式(开关 ON):将用户的语音录音"冻结"进音频潜空间(audio latent),再通过音视频联合去噪,让生成的人脸对着这段锁定的音频说话。嘴型精确同步到录音内容,声音在不同生成结果中保持高度一致。
-
模型生成语音模式(开关 OFF):不使用外部录音,由模型根据提示词自动合成语音。只需在提示词中加入
He says: "..."句式,模型便会"发明"一个声音并说出指定台词。
传统口型同步方案(如 Wav2Lip)采用两阶段流程:先生成视频,再通过独立模型进行口型后处理,这种解耦方式容易导致口型与面部动态不自然。音视频联合去噪(joint audio-video denoising)则将音频潜空间与视频潜空间在同一扩散过程中并行处理,音频信号作为条件约束直接参与每一步去噪迭代,使面部运动、头部姿态与语音节奏在生成阶段就形成物理层面的耦合,同步自然度显著提升。这种设计的巧妙之处在于,作者仅用"4 节点音频技巧"就实现了将真实语音注入生成流程,避免了传统换脸或口型迁移方案的复杂管线。
底层开源组件
整套方案建立在以下几个开源组件之上:
- Lightricks LTX-2.3:核心视频生成模型。LTX-2.3 基于扩散变换器(DiT)架构,与早期 U-Net 架构的视频生成模型相比,在时序一致性和细节保留方面表现更优,同时更易于量化压缩,专为高效本地推理设计;
- Alissonerdx 的 Best-Face-ID LoRA:负责人脸身份的锁定与保持。LoRA(Low-Rank Adaptation)是一种参数高效微调技术,通过在原始模型权重矩阵旁注入低秩分解矩阵来实现定向能力增强。Face-ID LoRA 专门针对人脸身份保持任务微调,其原理是在扩散采样过程中持续强化参考图像的面部特征嵌入,使生成结果在不同帧间维持一致的五官结构、肤色和面部比例;
- BFSNodes:提供工作流所需的自定义节点支持。
该方案同样兼容 Eros 模型,具备一定的通用性。
跨平台部署:CUDA 与 Apple Silicon 双支持
对于关注本地部署的用户,这套工作流同时提供了 CUDA(NVIDIA)和 Apple Silicon(Mac)两套工作流,覆盖主流消费级硬件。
实测性能表现如下:
- NVIDIA 显卡:生成一段 4 秒视频片段耗时不到 2 分钟;
- Apple Silicon:通过 GGUF Q4 量化版本运行,M 系列芯片生成同样 4 秒片段约需 10 分钟。
GGUF 是由 llama.cpp 项目引入的模型序列化格式,支持 Q4、Q8 等多种量化精度。Q4 量化将模型权重从 16 位浮点压缩为 4 位整数,显存占用降低约 75%,使原本需要高端显卡的大型视频模型得以在统一内存架构的 Apple Silicon 上运行。M 系列芯片的 CPU 与 GPU 共享内存池的特性,使其在处理量化模型时比传统 NVIDIA 独立显存架构更具灵活性,但受限于 GPU 算力,生成速度仍有数倍差距。虽然 Mac 平台速度明显慢于专业显卡,但能在消费级笔记本上完全本地运行身份锁定的说话视频生成,本身就体现了模型量化与本地推理生态的成熟。对于注重隐私、不希望将个人照片和语音上传云端的用户来说,这是一个务实的选择。
使用要点:参考图与提示词决定成败
作者特别强调了几个影响生成质量的关键因素,对实际操作极具参考价值。
参考图像的选择
参考图片的质量"影响非常大"。作者建议使用:
- 正面、胸部以上的紧凑裁剪(tight frontal chest-up crop);
- 人脸在画面中占比要大。
人脸越清晰、越居中,身份锁定效果就越好。这符合 Face-ID 类方案的一般规律——参考特征越充分,模型对身份的还原就越准确。
提示词驱动身份
另一个容易被忽视的细节是:身份在很大程度上由提示词驱动。作者指出,在 cfg 1 设置下,需要在提示词中使用 ref_t2v: 前缀来描述人物特征。仅有参考图还不够,还需要用文字准确描述目标人物,两者配合才能达到最佳身份一致性。
技术价值与伦理思考
这套工作流展示了当前开源视频生成领域的一个重要趋势:从单纯的文生视频,走向可控、可锁定身份的多模态生成。将真实语音注入生成流程的能力,让内容创作者可以用自己的声音和形象生产口播视频,适用场景涵盖 AI 数字人、教学内容、个性化短视频等。
音视频联合去噪的思路同样值得关注——它不再将口型同步作为后处理步骤,而是让音频与视频在去噪过程中相互约束,从而获得更自然的同步效果。
当然,这类技术的普及也伴随着不容忽视的伦理风险。仅凭一张照片和一段录音就能生成高度逼真的说话视频,无疑降低了深度伪造(deepfake)的制作门槛。如何在推动创作工具发展的同时,建立有效的溯源与防滥用机制,将是整个行业需要持续面对的课题。
对于希望上手体验的读者,作者已将完整工作流、示例和 README 文档发布在 GitHub,CivitAI 上也附带了工作流文件。
核心要点
相关推荐
n8n 实战:用 AI 把 Hacker News 热门故事自动变成视频
一个基于 n8n 的 AI 内容自动化工作流案例:从 Hacker News 抓取热门技术故事,经 AI 分析、Leonardo AI 配图、视频生成到 Google Drive 归档与多平台分发,帮内容创作者大幅节省时间。

GitHub日报·10月08日:Claude Cowork插件生态引爆榜单
Gemini Spark 完全指南:谷歌的 AI 智能体如何自动化你的日常
Gemini Spark 是谷歌深度整合进自家生态的 AI 智能体,支持定时循环任务、跨服务自动化。本文详解它与 Gemini Chat 的区别、使用前提,以及订阅审计、日程同步、旅行管理三个实战案例。