抑制图像反文本反馈:SFG提升扩散模型生成对齐

研究发现MMDiTs中图像到文本的反馈会固化生成偏差,并提出SFG方法通过负向引导抑制该机制以显著提升图像对齐质量。
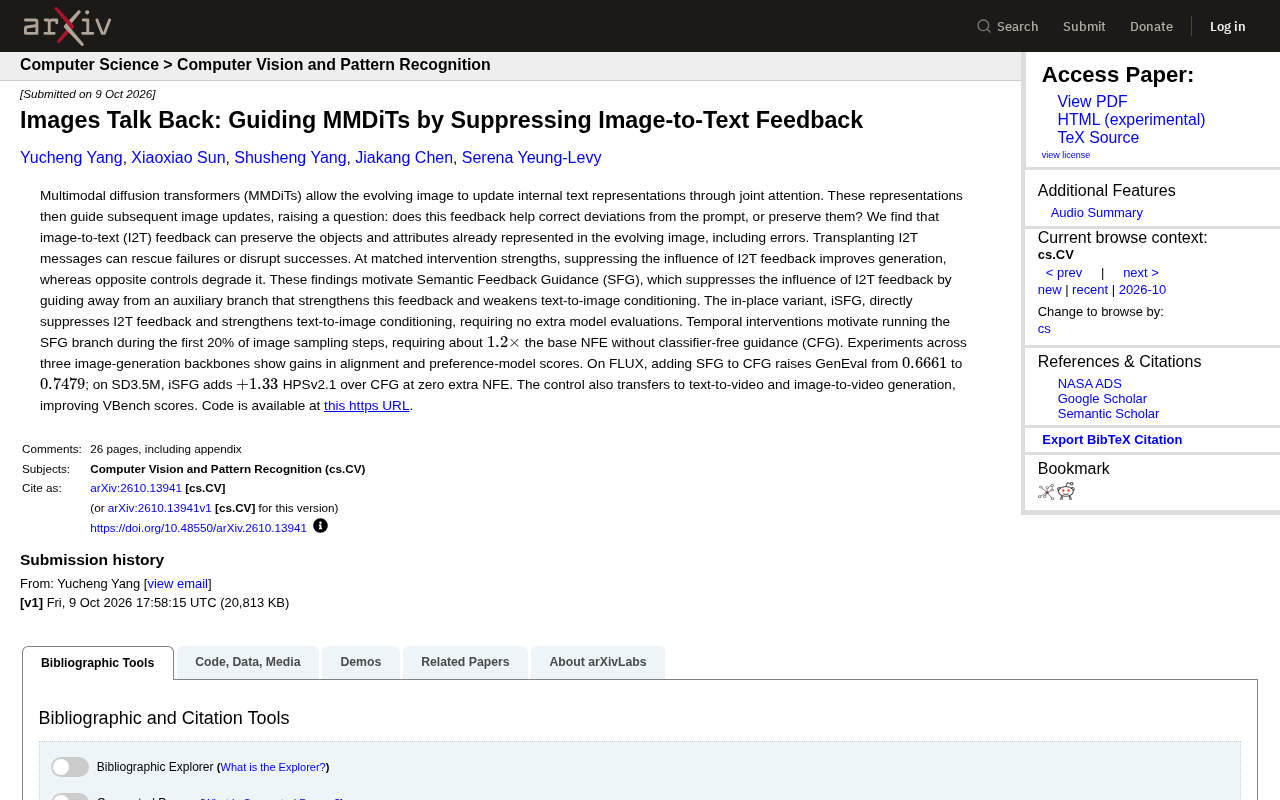
多模态扩散Transformer(MMDiTs)的联合注意力机制允许图像在生成过程中反向更新文本表征(I2T反馈),但最新研究通过干预实验证明,这种反馈往往固化图像中的既有内容——包括错误内容——而非修正与提示词的偏差。基于此,研究者提出了语义反馈引导(SFG):构建一个主动强化I2T反馈的辅助分支,再通过负向引导使生成远离该方向,从而系统性地抑制固化效应。其原地变体iSFG无需额外推理开销。实验表明,SFG在FLUX上将GenEval从0.6661提升至0.7479,iSFG在SD3.5M上零成本提升HPSv2.1达1.33分,且该方法可迁移至视频生成任务并改善VBench评分,代码已开源。
多模态扩散Transformer(MMDiTs)近年成为文本生成图像领域的主流架构。它的一个关键特性是:在图像逐步生成的过程中,演化中的图像可以通过联合注意力机制(joint attention)反过来更新内部的文本表征,而这些被更新的文本表征又会继续引导后续的图像生成。这就带来了一个值得深究的问题——这种图像到文本(Image-to-Text, I2T)的反馈,究竟是在帮助模型修正偏离提示词的内容,还是在固化这些偏差?
一项最新研究给出了明确答案:I2T反馈往往倾向于保留图像中已经形成的物体和属性,哪怕这些内容本身就是错误的。基于这一发现,研究者提出了语义反馈引导(Semantic Feedback Guidance, SFG)方法,并在多个主流图像生成骨干网络上验证了其有效性。
问题的核心:反馈到底在帮倒忙吗
MMDiTs的设计初衷是让图像和文本在生成过程中双向交互,理论上这应当让生成结果更贴合提示词。但研究团队通过干预实验发现,情况比预期复杂。
他们做了一个很直观的实验:把一次生成中的I2T信息「移植」到另一次生成中。结果显示,这种移植既可能挽救原本会失败的生成,也可能破坏原本成功的生成。换句话说,I2T反馈并不总是朝着「更符合提示词」的方向发力,它更像是在强化图像当前的既有状态。
进一步的对照实验更能说明问题:在相同的干预强度下,抑制I2T反馈的影响会提升生成质量,而反向增强它则会让结果变差。这组对称的结果几乎直接证明了I2T反馈在很多情况下是在固化偏差,而非纠正偏差。
为什么会出现这种「固化」
从机制上理解,当图像在早期采样步骤中已经「画出」了某个物体或属性,I2T反馈会把这一信息写回文本表征,使得后续的文本到图像(Text-to-Image, T2I)条件实际上被这个已经成型的图像「反向绑架」。原本应该由提示词主导的生成方向,被演化中的图像自身所主导。错误一旦出现在早期,就容易被这套反馈回路不断加固。
多模态扩散Transformer(MMDiTs)的联合注意力机制与传统的交叉注意力(cross-attention)有本质区别。在早期的扩散模型(如Stable Diffusion 1.x/2.x)中,文本条件通过交叉注意力单向作用于图像特征,文本表征本身不会被图像更新。而在MMDiTs(如SD3、FLUX)中,图像token和文本token被拼接在一起,共同参与同一套自注意力计算,这使得两者可以双向相互修改。这种设计在理论上能让模型捕捉更丰富的图文对应关系,也是MMDiTs在图像质量和语义对齐上整体优于前代架构的重要原因之一。但正是这种双向性,为I2T反馈固化偏差埋下了伏笔:文本表征不再是静态的条件锚点,而是会随图像演化而被动漂移的动态变量。
SFG的解法:引导远离强化反馈的辅助分支
既然问题出在I2T反馈的固化效应上,解决思路自然是削弱它的影响。SFG的做法是构建一个辅助分支,这个分支会强化I2T反馈并削弱T2I条件,然后在引导时让生成过程「远离」这个辅助分支的方向。这种负向引导的逻辑与无分类器引导(CFG)类似,只不过引导的对象变成了反馈机制本身。
研究还提供了一个更高效的原地变体iSFG(in-place SFG)。它直接抑制I2T反馈并强化T2I条件,关键优势在于无需额外的模型评估,也就是说不增加推理成本(NFE,Number of Function Evaluations)。这对实际部署非常重要,因为生成模型的推理开销往往是落地时的核心考量。
只在前20%步骤介入
时间维度上的分析带来了一个实用结论:SFG分支只需要在图像采样的前20%步骤运行即可。这与前面「错误在早期固化」的发现相互印证——既然偏差主要在早期形成,那么干预也应集中在早期。在不使用CFG的情况下,这种时间上的限制让SFG的开销仅约为基础NFE的1.2倍,代价相当可控。
无分类器引导(Classifier-Free Guidance, CFG)是理解SFG设计逻辑的重要参照。CFG的核心思想是同时运行一个有条件分支和一个无条件分支,然后沿「有条件方向减去无条件方向」放大条件信号,从而增强生成结果对提示词的遵循程度。这一机制以额外一倍推理成本换取了显著的质量提升,已成为扩散模型推理的标配。SFG借鉴了这一「负向引导」的范式:它构造的辅助分支扮演的是「更坏的方向」——强化I2T反馈、削弱T2I条件,使生成结果更容易被错误图像内容绑架。主分支在更新时明确远离这个方向,等效于抑制I2T反馈对生成的干扰。与CFG处理「有无文本条件」的对比不同,SFG处理的是「反馈机制是否被放大」的对比,两者可以叠加使用,互不冲突。
实验结果:三个骨干网络的一致提升
研究在三个图像生成骨干网络上进行了验证,结果在对齐度和偏好模型评分上均有提升。
具体数据方面:
- 在FLUX模型上,将SFG叠加到CFG之上,GenEval分数从0.6661提升到0.7479,提升幅度相当可观;
- 在SD3.5M模型上,iSFG在零额外NFE的前提下,相比CFG在HPSv2.1偏好评分上提升了1.33分。
这两组数据分别代表了SFG方法的两个价值点:一是在接受少量额外开销时能带来显著的对齐提升(FLUX),二是在完全不增加推理成本时也能稳定改善生成质量(SD3.5M的iSFG)。
向视频生成的迁移能力
这项控制方法并不局限于静态图像。研究者发现,同样的反馈抑制思路可以迁移到**文本生成视频(text-to-video)和图像生成视频(image-to-video)**任务上,并在VBench评分上取得改善。这意味着I2T反馈固化偏差的现象可能是多模态扩散架构中的一个普遍问题,而非某个特定任务的特例。
VBench是专为文本生成视频模型设计的综合评测基准,涵盖语义一致性、时间连贯性、运动质量、画面清晰度等多个子维度,是当前视频生成领域最常用的标准化评测工具之一。与图像生成中的GenEval(侧重对象计数、属性绑定等组合语义对齐)和HPSv2.1(基于人类偏好模型的审美评分)不同,VBench更关注跨帧的时序稳定性和动态内容的合理性。SFG在VBench上的改善说明,I2T反馈的固化效应不仅影响单帧的语义准确性,也可能通过影响视频生成中的条件信号,导致跨帧内容漂移或语义不一致。这一跨任务的迁移效果为「I2T反馈固化是MMDiTs架构层面的系统性问题」这一论点提供了跨模态的佐证。
对多模态生成研究的启示
这项工作的价值不只在于提出了一个能涨点的方法,更在于它揭示了MMDiTs内部一个被忽视的机制缺陷。联合注意力带来的双向交互,长期被默认为是有益的,但这项研究用严谨的干预实验说明:双向反馈中有一个方向(I2T)在很多情况下反而是生成偏差的来源。
对研究者而言,这提示我们在设计多模态架构时,不应想当然地认为「更多的交互等于更好的结果」。反馈回路的方向性、介入的时机、以及条件信号的主导权,都是值得精细调控的设计维度。SFG通过负向引导远离强化反馈的分支,提供了一个无需重新训练模型、即插即用的改进范式。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。