Yila:科研领域的AI代码助手,能否成为科学家的Copilot?

Yila试图为科研人员打造专用AI代码助手,填补通用编程工具的场景适配缺口。
Yila 是一个在 Hacker News 上亮相的早期项目,定位为“Codex for Scientific Research”,主张科研人员写代码的方式与软件工程师不同——前者侧重探索性分析、可复现性和文档与代码的强耦合,而非构建长期维护的软件产品。文章分析了科研代码的三大特殊性:探索性优于工程性、文档承载实验上下文、数据与结果需要追溯。同时指出 Yila 面临的两大挑战:科研场景对 AI 生成代码的信任门槛更高,以及学科碎片化导致“科研通用”助手难以覆盖所有技术栈。项目目前在 Hacker News 仅获 4 积分 2 评论,成熟度尚待验证。文章认为 Yila 的价值在于提出了正确的问题:AI 编程助手进入科研领域需要重新学习什么。
在AI编程助手席卷开发者社区之后,科研领域是否也需要一个专属的"代码副驾"?Hacker News上最新亮相的Yila项目给出了肯定答案。这个被命名为"Codex for Scientific Research"的工具,试图将AI辅助从通用编程推向更垂直的科研场景。
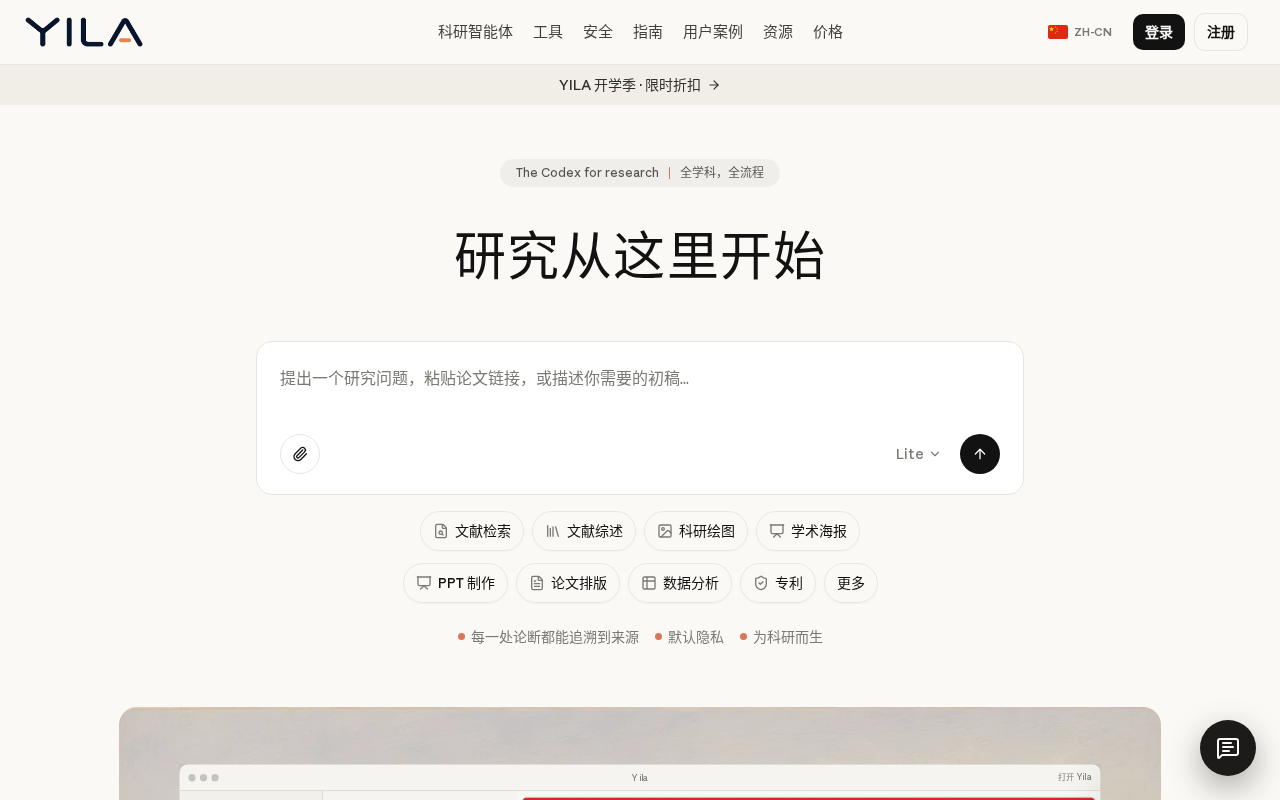
从通用编程到科研专用:Yila的定位逻辑
Yila的核心主张并不复杂:科研人员写代码的方式与软件工程师不同。科学家更多是在做数据分析、数值模拟、可视化验证,而不是构建长期维护的软件产品。这种差异意味着通用编程助手(如GitHub Copilot或Cursor)在科研场景中往往"够用但不顺手"——它们擅长补全函数和类,却未必理解科研工作流中的独特节奏。
Yila选择将自身定位为"Codex for Scientific Research",本质上是在借用"Codex"这一概念所代表的AI代码生成能力,同时将其锚定在科学研究的具体语境中。这个定位的聪明之处在于,它回避了与成熟编程助手的正面竞争,转而强调场景特异性:科研代码的迭代是探索性的、可重复性要求极高、文档与代码常常交织在一起。
不过,Hacker News上的原始发布仅获得4个积分和2条评论,说明该项目目前还处于极早期阶段,社区认知度有限。这意味着Yila的产品成熟度和实际能力尚待验证。
“Codex”一词的双重含义
Yila 使用“Codex for Scientific Research”作为自我描述,其灵感直接来自 OpenAI 的 Codex 模型——一个基于 GPT-3 微调、专门用于将自然语言转为代码的 AI 系统,它曾是 GitHub Copilot 背后的核心引擎。Codex 在开发者社区中已经成为“AI 代码生成”的代名词,因此 Yila 借用这一术语,既是在向潜在用户传递“我也能做代码生成”的信号,又通过后缀“for Scientific Research”进行场景限定。需要注意的是,Codex 本身已于 2023 年被 OpenAI 弃用,其能力被整合进更新的 GPT 模型;Yila 的命名更多是一种类比修辞,而非技术上的继承关系。理解这一点有助于判断 Yila 的实际技术路线:它很可能基于通用大模型进行科研场景的微调或提示工程,而非从零训练专用模型。
科研代码的特殊性:AI助手需要理解什么
要判断Yila这类工具是否有存在价值,需要先看清科研代码与工程代码的本质差异。
探索性优于工程性
科学家写代码往往是为了回答一个问题,而非构建一个系统。脚本可能只运行一次,但必须可复现;依赖可能很复杂,但版本管理常常被忽视。AI助手如果只关注代码语法正确性,而忽略可复现性和环境配置提示,对科研人员的帮助就打了折扣。
可复现性(Reproducibility)为何是科研代码的硬约束
可复现性是指其他研究者使用相同的数据和代码,能够独立得到与原研究一致的结果。它是现代科学方法的基石,也是近年来“可复现性危机”讨论的核心——多项调查显示,大量已发表研究的结果无法被独立复现,其中代码和环境配置的缺失是主要原因之一。与工程代码不同,科研脚本往往依赖特定版本的库、特定的随机种子、特定的硬件环境,甚至特定的操作系统补丁。一个只关注语法正确性的 AI 助手,可能生成在作者机器上运行成功、但换一台机器就报错的代码。因此,科研 AI 助手若要在可复现性上提供价值,需要主动提示依赖版本锁定(如 requirements.txt 或 conda 环境导出)、随机种子设置、以及数据快照的保存,而这些恰恰是通用编程助手默认不覆盖的层面。
文档与代码的强耦合
科研代码中的注释和文档往往承载着实验条件、参数选择和假设前提。Yila如果能在生成代码的同时,自动提取或补全这些科研上下文信息,就能形成差异化优势。
数据与结果的追溯需求
科学研究的核心是可验证性。一个理想的科研AI助手,不仅应该帮助写代码,还应该协助记录数据来源、运行环境和结果版本。这是通用编程助手很少覆盖的领域。
科研工作流管理工具与 AI 的潜在结合点
在 Yila 之前,科研社区已经发展出一批专注于可追溯性的工具生态,例如用于实验记录与参数追踪的 MLflow、Weights & Biases,用于数据版本控制的 DVC,以及用于交互式笔记本环境记录的 Jupyter。这些工具的共同目标是将“数据来源—代码版本—运行环境—结果输出”串联成可审计的链条。Yila 若想真正切入科研场景,一个合理的演进方向是与其生成代码的能力相结合:在写分析脚本时自动插入实验追踪的钩子代码,或在生成可视化时附带数据指纹。这种“生成即记录”的思路,比单纯提升代码补全速度更能体现科研专用助手的差异化价值,也呼应了文章所指出的通用编程助手很少覆盖的领域。
早期项目的现实检验:Yila面临的挑战
Hacker News上的低调亮相,实际上揭示了Yila面临的两个现实问题。
第一,科研AI工具的信任门槛更高。 开发者愿意尝试Copilot,因为代码错误可以快速发现和修正;但科研人员对AI生成的代码会更加审慎,因为错误的分析代码可能导致错误的研究结论。Yila需要在准确性验证和错误提示上投入更多设计。
第二,科研领域的碎片化程度远超软件开发。 生物信息学家用Python和R,物理学家用C++和Julia,社会科学研究者可能用Stata或SPSS。一个"科研通用"的AI助手要在多大程度上覆盖这些差异,是Yila必须回答的产品问题。
目前Yila的公开信息有限,无法判断其具体技术路线和覆盖范围。但从概念层面看,它指向了一个真实存在的需求缺口:科研人员需要的不只是"更快的代码补全",而是"更懂科学工作流的协作工具"。
科研AI工具的未来路径
Yila的出现并非孤例。近年来,面向科研场景的AI工具正在增多,从文献管理到实验设计辅助,再到代码生成,科研工作流正在被逐步拆解和优化。Yila选择从代码切入,是一个务实的起点——代码是科研中可数字化程度最高、也最容易被AI介入的环节。
但真正的考验在于,Yila能否超越"科研版Copilot"的定位,深入到可复现性保障、实验记录整合、结果验证等科研特有环节。如果只是把通用代码补全换个包装,它很难在科研社区建立长期价值;如果能在科研工作流的独特性上做出深度,它就有可能成为科研人员真正愿意日常使用的工具。
对于关注AI在垂直领域落地的人来说,Yila是一个值得持续观察的早期样本。它的价值不在于当前的功能完备度,而在于它提出的问题:当AI编程助手进入科研领域,它需要重新学习的到底是什么。
相关推荐

Claude Code+Codex多智能体系统实测:缓存率98%背后的真问题
开发者公布Claude Code+Codex多智能体系统7天实测:缓存率98%、输入输出比354:1,作者却卡在组织调度与输出比例,并追问行业基准与成本度量方法。

Cursor SDK 新功能:实时操控运行中的 AI 代理
Cursor SDK 新增 run.steer() 功能,允许开发者在 AI 代理运行中实时注入消息,调整执行方向。子代理遇 steer 时自动转入后台继续任务,为 AI 编程工作流带来更灵活的运行时干预能力。

如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。