隐私优先AI安全日志分析器:开源权重模型实战

CyberTools Hub AI用开源权重模型本地推理,为不懂安全的用户提供隐私优先的日志排错起点。
CyberTools Hub AI 是一个隐私优先的开源AI日志分析助手,目标是降低安全日志的解读门槛。它提供解释、总结、识别和建议四项MVP能力,将AI输出定位为调查指引而非权威安全裁定。项目选择Gemma等开源权重模型进行本地推理,以保障数据控制权、成本可预测性、实验自由度和降低供应商依赖。技术栈为React+FastAPI+SQLite,强调日志解析与AI解释分离、合成日志测试、输入验证和人工验证警告。目标用户是网络安全学生、独立开发者、自由职业者和小型IT团队,未来可能探索批量分析和团队功能等付费方向。项目将以实用性和可靠性而非AI回复流畅度来评判成功。
隐私优先AI安全日志分析器:用开源权重模型重新定义日志排错
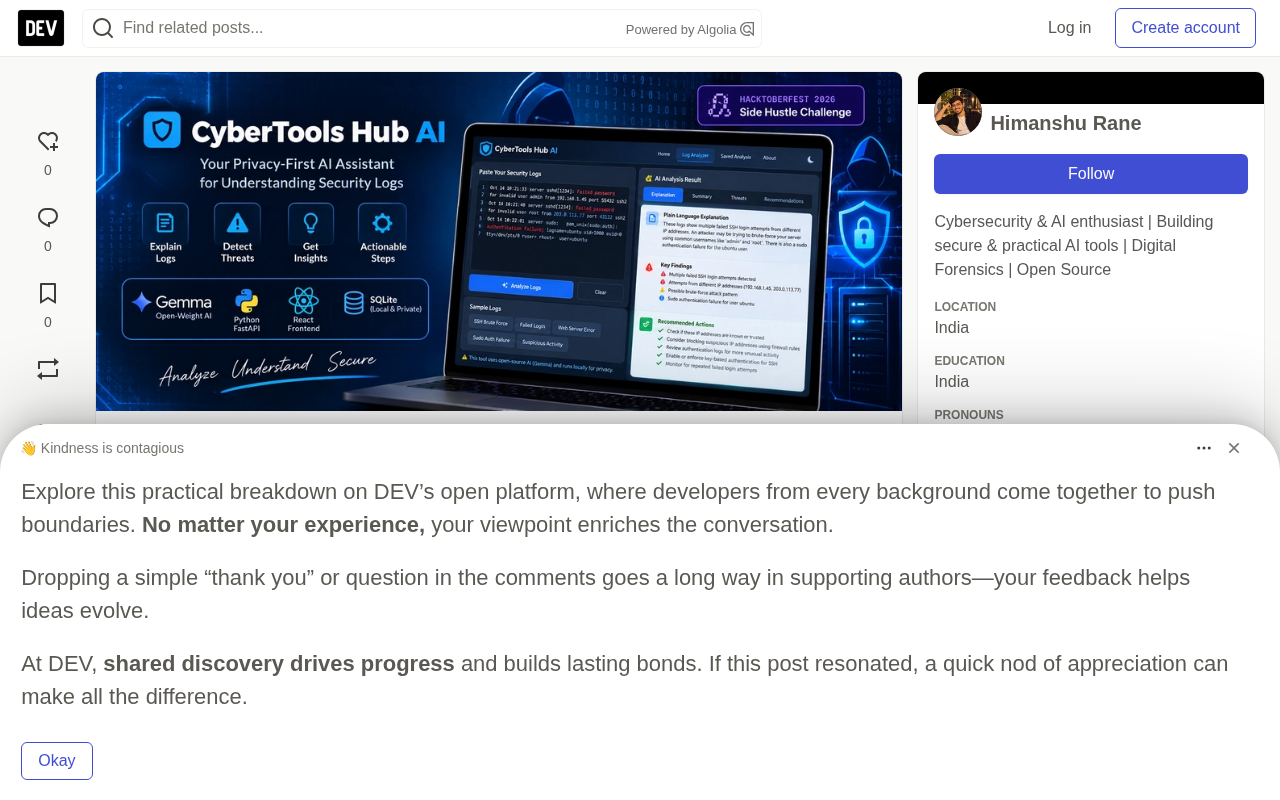
面对一条晦涩的SSH登录失败日志,经验丰富的安全工程师可能三秒就能判断风险等级,但学生、独立开发者或小型IT团队往往需要花费大量时间搜索文档、比对解释。CyberTools Hub AI 试图用开源权重AI模型填平这道认知鸿沟——它的核心理念并非替代安全分析师,而是为不懂安全的人提供一个可信的排错起点。
日志分析的现实困境
服务器和应用程序持续产生日志。这些日志记录着认证失败尝试、应用错误、可疑访问模式,以及大量值得关注的安全事件。问题在于,这些信息对开发者和普通运维人员来说,存在明显的解读门槛。
传统的工作流是:复制错误信息 → 搜索引擎查找 → 比对多种解释 → 猜测下一步该查什么。这个过程耗时且容易遗漏关键线索。尤其对于没有安全背景的独立开发者,一条包含 Failed password for invalid user admin from 192.0.2.45 的日志,可能只是被当作“有人输错了密码”,而忽略了背后可能的暴力破解尝试。
项目作者将其开发动机归结为:让技术排错对初学者和小型团队更友好。
CyberTools Hub AI是什么?
这是一个隐私优先的AI助手,设计目标是帮助用户理解安全与应用日志。计划中的MVP聚焦四项能力:
- 解释:将技术日志消息翻译成平实语言
- 总结:提取反复出现的错误和重要事件
- 识别:标记值得进一步调查的模式
- 建议:给出实用的防御性排错步骤
关键立场在于:这套工具不宣称某条日志“一定是攻击”,而是提供调查指引。所有AI输出被明确定义为“建议”而非“权威安全裁定”。
一个具体示例:SSH认证日志怎么看
假设开发者面对这样一组合成SSH日志:
Oct 13 10:21:33 server sshd[1234]:
Failed password for invalid user admin
from 192.0.2.45 port 55432 ssh2

Oct 13 10:21:41 server sshd[1235]:
Failed password for root
from 192.0.2.45 port 55433 ssh2

Oct 13 10:22:01 server sshd[1236]:
Failed password for invalid user test
from 192.0.2.45 port 55434 ssh2
这些消息显示:来自同一示例IP地址、针对常见用户名的反复SSH登录失败。AI辅助分析可以解释——这个模式与凭证猜测尝试一致,但同时必须明确:仅凭这些日志无法证明攻击已经成功。
随后建议的防御步骤包括:检查同一来源是否存在成功登录、确认该来源是否在预期内、审查SSH配置并考虑强制密钥认证、根据环境考虑限速或防火墙控制、持续监控后续相关事件。
所有示例IP和事件均为合成数据。输出应视为调查指引,而非确认的威胁判决。
SSH(Secure Shell)是Linux服务器远程登录的标准协议,默认监听22端口。日志中的关键字段各有含义:Failed password表示密码认证失败;invalid user admin表示尝试的用户名在系统中并不存在,这通常是自动化扫描工具的典型特征,因为攻击者会批量尝试admin、root、test等常见账户名;from 192.0.2.45 port 55432表示来源IP和源端口,其中192.0.2.0/24是RFC 5737专门保留用于文档示例的地址段,不会出现在真实公网中。同一IP在短时间内对不同用户名连续失败,是凭证猜测(credential guessing)或暴力破解(brute force)的常见信号,但单凭失败记录无法区分是攻击还是配置错误的客户端在反复重试。
为什么选择开源权重模型?
项目选择基于开源权重模型(如Google的Gemma),而非完全依赖专有托管的AI API。这是架构层面的决策,原因有四:
数据控制权
安全日志可能包含用户名、内部主机名、IP地址等敏感信息。本地推理部署有助于将日志内容保留在用户机器上——前提是应用在其他环节不会将日志发送到外部服务。
可预测的运营成本
本地托管模型可以减少按请求计费的API开销,但仍需要合适的硬件、内存、电力和维护投入。选择取决于工作负载和实际运行成本。
实验自由度
开源权重模型允许对比不同规模、试验提示词、用合成测试集评估输出、针对特定场景适配应用。需要注意的是,不同模型的权重和许可证不同,分发前必须确认许可条款。
降低供应商依赖
通过模型抽象层,可以在不重建整个应用的前提下评估或替换推理引擎。
作者对“开放创新”的理解是:对产品如何开发、部署和改进拥有更多控制权。
开源权重模型与开源代码是两个容易混淆的概念。开源权重指模型的参数文件(通常是数十亿个浮点数)以可下载、可本地运行的形式公开发布,任何人都可以在自己的硬件上加载并执行推理,但训练数据、训练代码和完整训练流程未必公开。Gemma、Llama、Mistral 等属于这一类。与之相对,完全开源的模型还会公开训练数据配方和训练脚本,而专有API(如GPT-4、Claude)则只提供服务接口,权重完全不对外。对安全日志分析场景而言,权重可获取意味着日志文本不必离开本地机器即可完成推理,这是"隐私优先"得以成立的技术前提。
拟议的技术架构
MVP的技术栈规划如下:
- 前端:React
- 后端:Python + FastAPI
- AI推理:兼容的开源权重模型(如Gemma),本地部署
- 存储:SQLite,用于可选的本地分析历史
- 测试数据:合成SSH认证日志和应用日志
应用接收日志文本,验证并准备分析输入,发送至配置的推理引擎,返回结构化的解释、发现和建议操作。设计上强调日志解析与AI解释分离——基础模式检测和输入验证可以独立于模型工作。
AI输出必须清晰标注为建议,而非权威安全裁定。
模型抽象层(model abstraction layer)是这里的隐性关键设计。它指的是在应用代码和具体推理引擎之间加一层统一接口,把"如何调用模型"与"调用哪个模型"解耦。典型实现会定义如analyze(log_text) -> structured_result的抽象方法,底层可切换为本地llama.cpp、Ollama、vLLM或远程API,而上层业务逻辑无需改动。这样做的好处是:更换模型时不必重写提示词管理、结果解析和错误处理;可以用同一套评估脚本对比Gemma、Mistral等不同权重的输出质量;在未来某些场景允许用户自行选择推理后端。对隐私敏感的工具而言,抽象层还便于在代码审计时确认"哪些路径会把日志发往外部",从而把隐私承诺落实到可检查的工程结构上。
隐私与负责任使用
隐私必须是实现层面的真实属性,而非营销话术。MVP优先考虑以下措施:
- 部署支持时优先本地推理
- 演示和测试使用合成日志
- 输入验证与合理的日志大小限制
- 不向第三方服务不必要地传输日志内容
- 明确警告AI发现需要人工验证
工具定位为防御性排错和授权系统管理。
潜在用户与商业化可能
目标用户包括:学习事件调查的网络安全学生、调试应用的独立开发者、管理客户基础设施的自由职业者、寻求简化初次分析流程的小型IT团队。
未来付费版本可能探索批量分析、可定制报告、保存调查记录和团队功能。这些是潜在的商业化方向,而非现有功能的承诺。下一步是将MVP放到真实用户面前,了解哪些功能能节省足够的时间从而值得付费。
如何评估项目成功
评估使用一组小型合成日志集,覆盖SSH登录失败、重复认证尝试、应用错误和正常活动。有用的评估标准包括:解释是否匹配日志证据、可疑模式描述是否避免过度断言、建议操作是否相关且安全、在目标硬件上的分析耗时、用户是否觉得结果比原始日志更易理解。
项目应以实用性和可靠性评判,而非仅仅看能否生成流畅的AI回复。
下一步计划
作者的近期优先事项是:完成MVP、用合成样本验证输出、记录设置流程、收集实际使用日志的专业人士反馈。核心关注点是——本地运行的开源权重模型能否在不过度增加硬件或设置复杂度的前提下,提供有用的解释。
如果你处理应用日志、安全事件或开源AI,可以通过项目渠道反馈:什么样的功能会让隐私优先的AI日志分析器对你真正有用?
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。