银行与保险业如何在生产环境部署LLM:合规审计成关键
金融机构部署LLM须先过合规关:审计追踪、PII脱敏、访问控制缺一不可
一家保险公司试点LLM的真实案例揭示了受监管行业AI落地的核心逻辑:合规治理优先于模型效果。合规部门要求任何方案必须满足三项硬性条件——完整的审计追踪、模型接收数据前的PII脱敏、以及按团队划分的访问控制。在选型上,企业面临两难:Azure AI Foundry依托微软现有生态落地阻力小,但存在供应商锁定风险;Orqai等垂直合规方案功能针对性强,但成熟度和长期稳定性有待验证。文章指出,能让合规团队通过的不是单一功能,而是一整套「可演示、可审计、可交代」的治理框架,金融行业LLM落地目前仍是在合规约束下的个案探索,尚无标准答案。
金融机构落地LLM的第一道门槛:合规
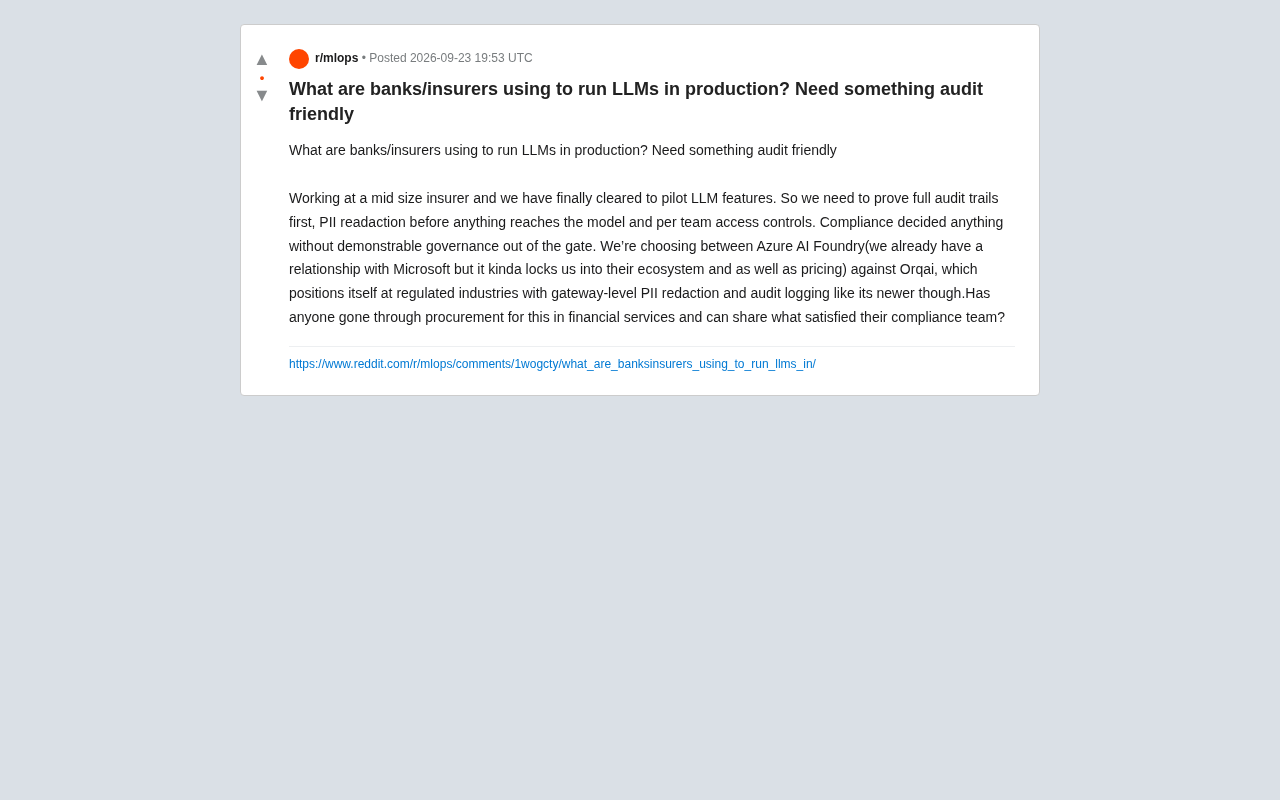
当一家中型保险公司终于获批试点LLM功能时,摆在技术团队面前的第一个问题往往不是模型效果,而是合规。一位来自保险行业的从业者在Reddit上抛出了这个真实困境:合规部门明确要求,任何缺乏「可证明治理能力」的方案,从一开始就不予考虑。
这条要求听起来简单,实则划定了金融行业AI落地的核心边界。与互联网公司「先跑起来再说」的做法不同,银行和保险机构在引入大语言模型时,必须先证明三件事:完整的审计追踪(audit trail)、数据进入模型前的PII脱敏(PII redaction),以及按团队划分的访问控制(per-team access controls)。
换句话说,模型能不能用得好是第二位的,能不能「说清楚它做了什么、看到了什么、谁在用」才是第一位的。这是受监管行业与普通企业在AI采购上最本质的差异。
三项硬性合规要求拆解
完整审计追踪
对银行和保险公司而言,任何自动化决策系统都可能面临监管机构的事后审查。这意味着每一次模型调用、输入了什么、返回了什么、由谁触发,都需要可追溯的日志记录。没有审计日志,就无法向合规团队和外部审计师交代,系统就等于「黑箱」,在受监管场景中几乎不可能通过评审。
审计追踪(Audit Trail)在金融监管语境中有明确的合规依据。以美国为例,SEC Rule 17a-4 要求经纪商对电子记录进行不可篡改的存储;欧盟的MiFID II和GDPR同样对自动化决策系统的可解释性和数据处理记录提出了强制要求。在中国,银保监会对金融机构信息系统的运维日志留存期限通常不低于6个月,部分场景要求更长。对于LLM这类新型系统,监管机构关注的不只是「有没有日志」,还包括日志是否防篡改(immutable logging)、是否包含足够的上下文(如调用者身份、时间戳、输入输出的哈希摘要),以及日志数据本身是否受到访问控制保护——否则审计日志本身也可能成为数据泄露的来源。
模型前的PII脱敏
保险和银行业务天然涉及大量个人身份信息——身份证号、账户信息、健康记录等。这些敏感数据在到达LLM之前必须被识别并脱敏。原帖特别强调「PII redaction before anything reaches the model」,指出脱敏动作要发生在数据流入模型之前,而非事后清理。这也是为什么「网关层脱敏」(gateway-level redaction)成为这类方案的一个关键卖点。
PII(Personally Identifiable Information,个人身份信息)脱敏的技术实现主要分为两类:基于规则的正则匹配(适合身份证号、手机号等格式固定的字段)和基于NLP/NER模型的实体识别(适合姓名、地址等非结构化文本中的敏感信息)。「网关层脱敏」的含义是在请求到达LLM API之前,由一个独立的代理层(proxy)完成识别和替换,例如将「张三,身份证410***」替换为「[NAME],身份证[ID]」,LLM处理的始终是脱敏后的文本。这种方式的优点是与模型解耦,无论后端换成哪家模型,脱敏策略保持一致;缺点是脱敏替换可能影响模型对语义的理解,在某些需要精确匹配客户信息的场景中需要额外的还原(de-tokenization)机制,而还原环节本身又需要严格的权限控制,否则会形成新的安全漏洞。
按团队的访问控制
不同团队、不同角色对模型和数据的访问权限需要精细化管理。核保团队、理赔团队、客服团队所能调用的能力和接触的数据范围各不相同,权限颗粒度直接关系到数据最小化原则的落实。
两条主流路径:生态绑定 vs 垂直合规
原帖作者正在两个方案之间权衡,这恰好代表了金融机构选型时的两种典型思路。
Azure AI Foundry:借力现有生态
第一个选项是微软的 Azure AI Foundry。作者所在公司已经与微软建立了合作关系,走这条路意味着可以复用现有的企业协议、身份体系和采购流程,落地阻力小。但代价也很明确:会更深地绑定在微软生态中,无论是技术栈还是定价,都会受制于单一供应商。这种「生态锁定」(vendor lock-in)在长期成本和议价能力上是需要谨慎评估的风险。
Azure AI Foundry(前身为Azure Machine Learning Studio和Azure OpenAI Service的整合产品)是微软面向企业的AI开发与部署平台,提供模型微调、提示流编排、内容过滤和监控等能力,并与Azure Active Directory(Entra ID)深度集成,支持基于角色的访问控制(RBAC)和条件访问策略。对于已经采购了Microsoft 365或Azure企业协议的金融机构,使用Foundry意味着可以在现有的数据处理协议(DPA)和合规认证框架(如SOC 2、ISO 27001、FedRAMP)下运作,省去重新进行供应商安全评估的成本。供应商锁定(Vendor Lock-in)的风险则体现在:一旦核心业务流程与Azure的特定API深度耦合,未来切换平台的迁移成本极高,同时在合同续约时议价能力也会相应下降。
Orqai:面向受监管行业的定位
第二个选项 Orqai 则明确将自己定位于受监管行业,主打网关层的PII脱敏和审计日志能力。它的优势在于合规特性是「开箱即用」的,正好对应了合规部门的硬性要求。但作者也坦言,这类方案「相对更新」,成熟度和长期可靠性还需要验证——对保守的金融机构来说,供应商的稳定性本身也是评审项之一。
金融行业AI采购的现实考量
这场讨论折射出金融行业在AI采购上的普遍纠结:一边是深度绑定但稳妥可靠的大厂生态,一边是功能贴合但相对年轻的垂直方案。
真正能让合规团队点头的,往往不是某个单一功能,而是一整套「可演示、可审计、可交代」的治理框架。技术选型只是其中一环,供应商能否提供合规文档、能否配合审计、能否在监管问询时提供支撑材料,同样重要。
对于正在经历类似流程的团队,几个值得关注的方向包括:脱敏是在网关层还是应用层实现、审计日志的粒度和留存周期是否满足监管要求、访问控制能否对接现有的企业身份系统,以及供应商是否有金融行业的成功落地案例。
值得一提的是,原帖本身是一个求助帖,作者在寻求同行分享「什么样的方案通过了合规团队的评审」。这也说明,在金融行业LLM落地这件事上,业界尚未形成标准答案,更多是在合规约束下的个案探索。相比模型能力的军备竞赛,如何把治理框架讲清楚、做扎实,才是这类机构眼下更现实的课题。
相关推荐
AI Agent入门详解:为何它是继图形界面后的下一次计算革命
本文系统讲解AI Agent是什么:它是基于大模型、能自主规划与执行任务的智能体。文章解读比尔·盖茨为何称其为继命令行、图形界面后的第三次计算革命,剖析Agent=LLM+规划+记忆+工具的技术架构,并探讨Agent与机器人结合的前景及开发者的机会。
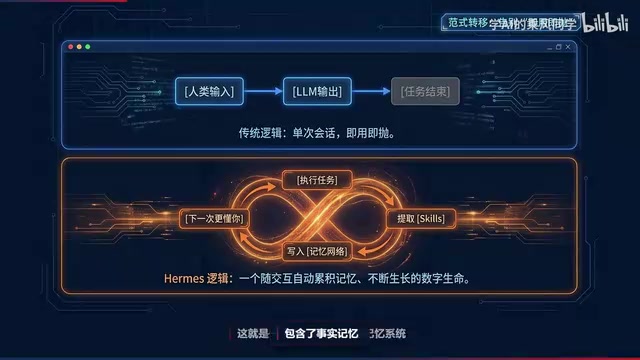
Hermes Agent 实测:告别单次机器人的进化型AI基建
Hermes Agent实测解析:一款GitHub超8万star的开源AI Agent框架,具备三层记忆系统、跨平台部署、技能库与多智能体协作能力。本文梳理其架构、安装与实战能力,帮你判断是否值得从传统聊天机器人迁移。
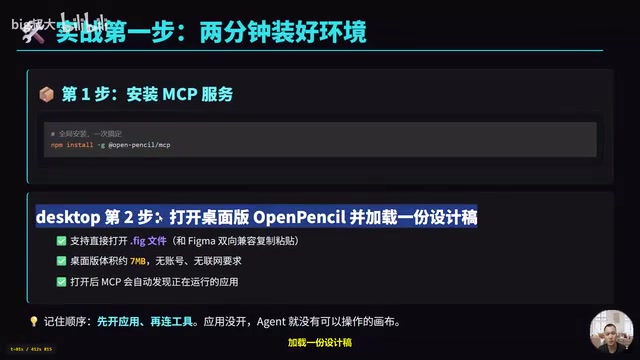
OpenPencil MCP实战:让AI Agent直接读改设计稿
OpenPencil是MIT开源的设计工具,一条命令接入MCP,让AI Agent直接读改本地设计稿。本文详解从安装、接入Claude Code与Cursor到五步工作法的完整实战流程。