硬覆盖约束的代价:在线共形预测效率成本分析

在线共形预测的硬覆盖约束会带来不可避免的效率代价,且代价阶数随评估标准变严而增大。
本文探讨在线共形预测中硬覆盖约束的效率成本。硬覆盖要求累积误覆盖次数始终不超过预算,而非仅平均覆盖达标。研究表明,即使数据独立同分布、评分分布已知且掌握最优预测集,硬约束仍必然导致预测集尺寸增加。最小累积超额预测集尺寸的阶数取决于评估时间设定:固定已知时刻为Θ(log T),所有固定时刻最大值为Θ(T^{1/3}),事后选择最坏时刻为Θ(√T)。这些下界可通过仅利用历史评分的在线算法达到,无需已知分布。评估标准越严格,效率惩罚越大,长期部署中不可忽视。
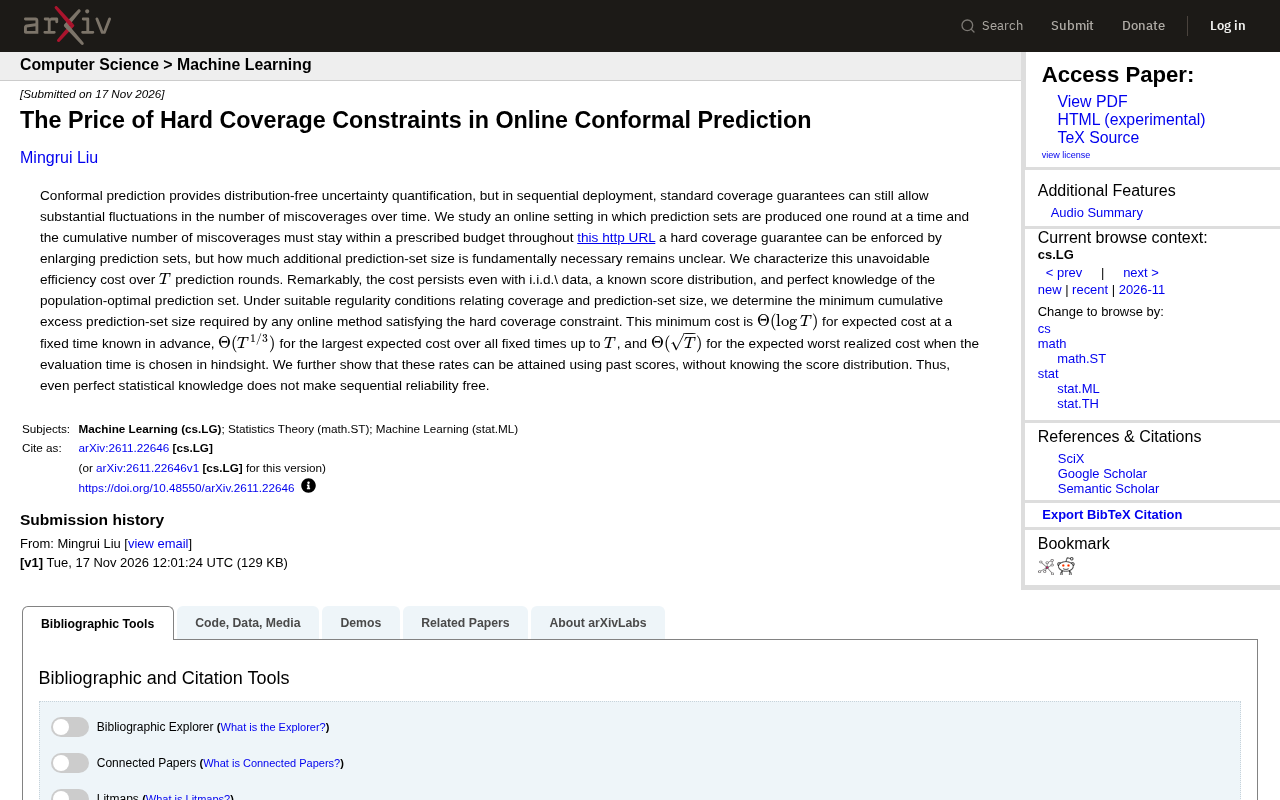
共形预测(Conformal Prediction)作为一种无分布假设的不确定性量化方法,长期以来被视为机器学习模型可靠性部署的重要工具。然而,当预测任务从静态批处理转向在线序列决策时,传统的覆盖保证暴露出一个本质缺陷:即使平均覆盖率达标,误覆盖次数在时间维度上的波动仍可能远超预期。近期一篇研究深入探讨了在线共形预测中硬覆盖约束(Hard Coverage Constraints)所带来的效率代价,揭示了序贯可靠性并非免费午餐的深刻结论。
问题背景:从平均覆盖到硬约束
标准共形预测提供的是边际覆盖保证——在大量预测中,真实标签落入预测集的比例不低于预设水平。这种保证在独立同分布数据上表现良好,但在在线部署场景中,用户关心的往往不是长期平均值,而是任意时刻的累积误覆盖次数是否可控。例如,在医疗监测或自动驾驶等高风险应用中,即使平均误覆盖率合格,短时间内连续多次误覆盖也可能造成严重后果。
为此,研究者提出了硬覆盖约束:要求在整个部署过程中,累积误覆盖次数始终不超过预设预算。直观上,这可以通过扩大预测集来实现——更大的预测集自然更可能包含真实标签。但问题在于,这种扩大需要付出多大的效率代价?是否存在一个根本性的下界,无论算法多聪明都无法突破?
边际覆盖与条件覆盖的区别:边际覆盖(marginal coverage)仅要求预测集在全体样本上的平均包含概率不低于1-α,而条件覆盖(conditional coverage)则要求给定任意特征X=x时,包含概率都不低于1-α。标准共形预测通常只保证边际覆盖,这在异质数据中可能导致某些子群体覆盖不足。硬覆盖约束可视为一种更严格的序贯条件覆盖要求,它关注累积误覆盖次数的时间一致性,而非单点条件概率。理解这一区别有助于把握为何在线场景下硬约束会带来额外成本。
核心发现:不可避免的效率成本
该研究给出了明确的答案:硬覆盖约束必然导致预测集尺寸的增加,且这种成本在理论上不可消除。研究者在T轮预测的框架下,刻画了任何满足硬覆盖约束的在线方法所需的最小累积超额预测集尺寸。
令人惊讶的是,这种成本即使在最理想条件下依然存在:数据独立同分布、评分分布已知、甚至完全掌握总体最优预测集。换言之,完美的统计知识并不能让序贯可靠性变得免费。这一结论打破了“只要知道分布就能消除在线学习代价”的常见直觉。
在覆盖与预测集尺寸满足适当正则条件的假设下,研究者确定了最小累积超额尺寸的精确阶数,根据评估时间的不同设定分为三种情形:
- 固定且预先已知的评估时刻:期望成本为Θ(log T),即对数增长。
- T轮内所有固定时刻的最大期望成本:为Θ(T^{1/3}),增长更快。
- 评估时刻事后选择时的期望最坏实际成本:为Θ(√T),增长最为显著。
这三个阶数揭示了评估标准越严格(从事先固定到事后选择),硬约束带来的效率惩罚越大。尤其是√T阶,意味着在最坏情况下,预测集尺寸的累积超额量随轮数平方根增长,这在长期部署中不可忽视。
Θ记号与阶数含义:文中使用Θ(·)记号描述成本随轮数T的增长速率。Θ(f(T))表示成本与f(T)同阶,即存在常数c1,c2>0使得当T足够大时,c1·f(T)≤成本≤c2·f(T)。例如Θ(log T)表示成本对数增长,远慢于线性;Θ(T^{1/3})表示立方根增长;Θ(√T)表示平方根增长。这些阶数刻画了不同评估标准下效率惩罚的渐进速度,阶数越高意味着长期部署中预测集尺寸的累积超额越严重。
算法可达性:无需已知分布
理论下界只有具备可达性才有实际意义。研究进一步证明,这些速率可以通过仅利用历史评分(past scores)的在线算法达到,而无需事先知道评分分布。这一结果具有重要的实践价值:在实际部署中,数据分布往往是未知或时变的,要求已知分布不切实际。而基于历史信息的自适应方法能够在满足硬覆盖约束的同时,达到理论最优的效率成本阶数。
这体现了在线共形预测的核心张力:硬覆盖约束的代价是固有的,但通过巧妙利用序贯信息,可以在未知分布下逼近这一极限。算法设计的关键在于动态调整预测集尺寸,在覆盖约束与效率之间取得平衡。
在线学习中的历史评分利用:在线共形预测算法通常维护一个历史评分序列,并基于此动态调整预测集阈值。仅利用历史评分意味着算法不假设评分分布的具体形式,而是通过序贯观测自适应地校准。这与在线学习中的“跟随正则化领导者”(Follow-the-Regularized-Leader)或“指数加权平均”等无分布方法思路一致,但针对覆盖约束的特殊结构进行了设计。这种适应性使得算法在分布未知或时变时仍能保持理论保证,是硬覆盖约束下达到最优阶数的关键。
实践启示与开放问题
对于从事不确定性量化研究或部署可靠机器学习系统的从业者,该研究传递了几个关键信号。首先,硬覆盖约束不是没有代价的——如果应用场景要求严格的累积误覆盖控制,就必须接受预测集尺寸的增加,且这种增加随部署时间增长而累积。其次,评估时间的选择策略直接影响成本阶数:如果能在部署前固定评估节点,成本可降至对数级;若允许事后选择最坏时刻,成本将显著上升。
该研究也留下了若干开放问题。例如,在非独立同分布数据或分布漂移环境下,这些阶数是否仍然成立?预测集尺寸的约束形式(如平均尺寸而非累积超额)会如何改变下界?此外,如何将理论结果转化为实际算法中的超参数选择指南,仍需进一步探索。
总结
在线共形预测的硬覆盖约束揭示了一个根本性权衡:序贯可靠性需要付出效率代价,且这一代价在理论上不可消除,即使拥有完美的统计知识。研究给出的Θ(log T)、Θ(T^{1/3})和Θ(√T)三个阶数,为理解在线不确定性量化的极限提供了精确标尺。对于追求可靠部署的机器学习系统而言,这意味着需要在覆盖严格性与预测集效率之间做出明智的取舍。
相关推荐
戈登·拉姆齐对决米其林父子:加利西亚美食寻味记
戈登·拉姆齐深入西班牙加利西亚,与米其林两星主厨佩佩·维埃拉展开美食对决。从死亡海岸的鹅颈藤壶到传统石炉面包,探索加利西亚独特的饮食文化与食材故事。

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。

15年经验程序员失业两年:AI时代的技术人困境
一位15年经验的美国高级软件工程师失业两年,积蓄耗尽,求助Hacker News。本文分析技术人长期失业的结构性原因、简历空窗期的应对策略,以及AI时代经验价值的重新定义。