硬件级控制手机AI Agent:用HDMI+USB HID绕开软件限制

一个跳出软件框架的手机AI Agent方案
手机AI Agent(智能体)近年来备受关注,但绝大多数实现方案都停留在软件层面:要么依赖 ADB 调试接口,要么运行在安卓模拟器里,要么需要在目标手机上安装定制 App 或获取 root 权限。
ADB(Android Debug Bridge)是Google为Android开发者提供的命令行调试工具,通过USB或Wi-Fi连接PC与手机,允许执行shell命令、安装应用、截屏等操作。它是目前手机自动化测试和AI Agent最常用的底层接口之一,Appium、UIAutomator2等主流自动化框架都依赖它。然而ADB需要在开发者选项中手动授权,部分厂商ROM(如MIUI)会对ADB权限作额外限制,且许多金融、支付类应用会主动检测ADB调试状态并拒绝运行,构成明显的可靠性瓶颈。这些方式虽然可行,却各有各的局限——需要开发者模式、面临系统权限限制、难以跨应用操作,甚至可能触发反自动化机制。
近日,一位 Reddit 用户在 r/aiagents 社区分享了一个开源项目 aiden-hardware-demo,它提供了一条截然不同的技术路径:不靠软件 hook,而是从硬件层面「像人一样」操作手机。这个思路虽然还处于开发板原型阶段,但引发了不少关于「外部硬件控制是否是移动 Agent 可行方向」的讨论。
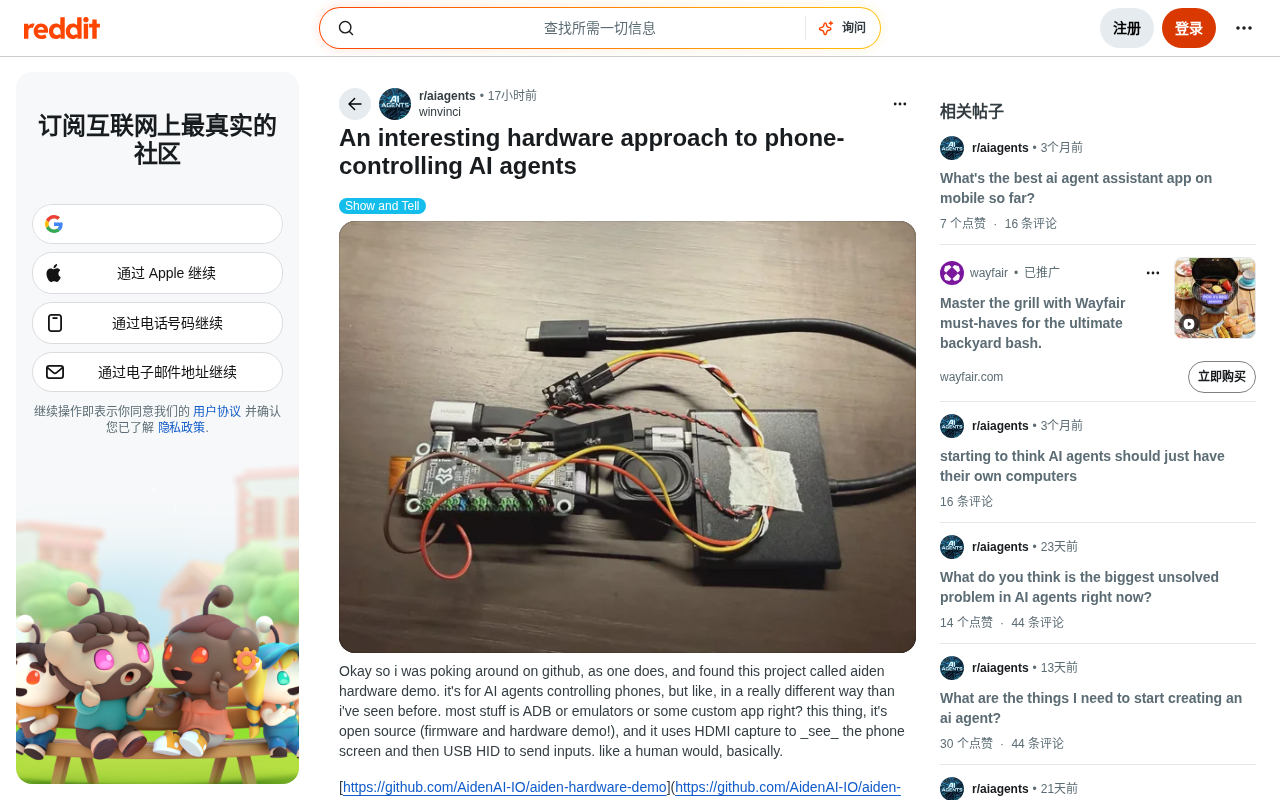
核心原理:用 HDMI 采集看屏幕,用 USB HID 做操作
这个项目最有意思的地方在于它的控制链路。它把手机对 AI Agent 的交互,拆解成两个纯硬件的环节:
视觉输入:HDMI 采集屏幕画面
传统手机 AI 自动化方案要读取手机画面,往往需要截屏 API 或屏幕录制权限。而 aiden 直接通过 HDMI 采集把手机屏幕作为视频信号「看」进来。
HDMI采集卡(Video Capture Card)是一类将HDMI视频信号转换为计算机可读数据流的硬件设备,广泛用于直播、视频录制和工业视觉检测。在手机场景中,现代Android手机通过USB-C的DisplayPort Alt Mode或Type-C转HDMI适配器可将屏幕内容以标准HDMI信号输出,分辨率通常可达1080p甚至4K。采集卡将该信号实时解码为YUV或RGB像素帧,通过UVC(USB Video Class)协议传给主机,主机侧无需额外驱动即可像读摄像头一样读取画面帧。这意味着 Agent 获取的是最原始的画面像素,与人类肉眼看到的完全一致,不依赖任何系统接口。
值得关注的是,这里的视频输出能力依赖于手机硬件对 DisplayPort Alt Mode(DP Alt Mode) 的支持。这是USB-C规范中允许非USB协议复用物理引脚的机制,其底层原理是:USB-C接口共有24个引脚,标准USB 3.x数据传输只占用其中一部分,剩余引脚可通过「Alt Mode」协商重新定义功能。当手机与适配器完成Alt Mode握手后,手机GPU渲染完成的帧缓冲区(Framebuffer)内容会绕过USB数据栈,直接以DisplayPort电气信号从这些引脚输出,再经有源适配器(内含DisplayPort转HDMI芯片)转为标准HDMI信号送入采集卡。整个过程对Android操作系统几乎透明,系统层面感知到的仅是「连接了外部显示器」。然而并非所有Android手机都支持这一机制——高通骁龙旗舰系列(855及以上)、三星Galaxy S/Z系列、索尼Xperia等通常完整支持,许多中端机型因芯片组成本原因裁剪了DP Alt Mode控制器;部分华为机型则使用私有协议,需要特定适配器;联发科Dimensity部分型号对Alt Mode支持情况也参差不齐。这构成了该方案最明确的硬件兼容性边界,使用前需要确认目标设备型号是否在经过验证的兼容列表中。
动作输出:USB HID 模拟触控与键盘输入
在输出端,它使用 USB HID(人机接口设备) 协议模拟触摸和键盘输入。
HID(Human Interface Device)是USB规范中定义的一类设备协议,涵盖键盘、鼠标、游戏手柄、触摸屏等几乎所有人机输入设备。其核心设计是:操作系统内置通用HID驱动,任何符合HID描述符规范的设备无需安装额外驱动即可被识别。通过微控制器(如Raspberry Pi Pico、Arduino Leonardo等支持USB Device模式的芯片)可以伪造HID描述符,让主机把它「认作」键盘或绝对坐标触控板,从而向连接的手机注入精确坐标的触控事件。
这种方案的反检测能力源于其在操作系统架构中的位置:当HID设备发送触控事件时,Linux内核的input子系统(Android基于Linux内核)将其与触摸屏驱动产生的事件合并进同一个输入事件队列(/dev/input/eventX),应用层通过Android Framework的InputDispatcher接收事件时已无法区分来源。相比之下,ADB的uiautomator或Accessibility Service注入的事件在某些系统版本中会携带特殊标志位(如FLAG_IS_ACCESSIBILITY_EVENT),金融App的风控SDK正是通过检测这些标志位识别自动化行为。HID事件从内核层进入,完全规避了应用层可见的标识,这是其反检测能力的根本所在。在手机看来,这些操作和真人手指点击、外接键盘敲字没有任何区别。因此不需要开启无障碍服务,也不需要 ADB 授权。
这套「看画面—做操作」的闭环,本质上是把 AI Agent 变成了一个「机械手 + 摄像头」的组合,完全绕开了操作系统的软件栈。对手机而言,它面对的就是一个普通的外接显示器和外接输入设备。
无需越狱、无需 App、无需后端
项目作者反复强调了几个「不需要」,这些正是它相较于主流手机自动化方案的核心差异:
- 无需越狱或 root:不改动手机系统,也不触碰权限边界;
- 无需 App API 或定制 App:目标手机上不用装任何东西,保持原生状态;
- 无需官方后端:这一点对自托管爱好者尤为友好。
从架构上看,项目开源了固件和硬件 demo,并提供了一个可接入多模态模型的 Agent 运行时(agent runtime)。
多模态大语言模型(Multimodal LLM)是指能够同时处理文本、图像乃至音频输入的AI模型,代表性例子包括GPT-4o、Gemini 1.5和开源的LLaVA、Qwen-VL等。在aiden的架构中,采集卡输出的屏幕帧被送入多模态模型进行「屏幕理解」——识别当前界面元素、文字内容和可交互控件,再由Agent运行时根据任务目标规划下一步动作,最终转化为HID指令输出。
需要指出的是,将原始像素帧送入多模态LLM进行屏幕理解面临不容忽视的延迟挑战:主流云端模型(GPT-4o Vision、Gemini 1.5 Flash等)单次视觉推理延迟通常在500ms至3秒之间,加上视频采集的帧缓冲延迟(通常50-200ms)和HID指令执行时间,完整的感知-决策-执行循环可能超过5秒。这对于需要快速连续操作的任务场景(如刷新闻信息流、实时聊天回复)构成明显瓶颈。为此,业界出现了专门针对GUI理解优化的轻量模型:微软的UFO通过双Agent架构(主控Agent+操作Agent)降低单步推理负担;字节跳动的UI-TARS在大规模移动端GUI数据集上训练,专项优化了界面元素定位精度;SeeClick等模型则专注于屏幕坐标预测任务,将模型规模压缩至7B参数级别以支持本地部署,可将单次推理延迟压缩到200ms以内。这些专用模型是该类硬件方案在推理效率上的重要配套方向,也是整个「视觉感知+物理输入」范式能否在实时性要求高的场景落地的关键变量。
STT(Speech-to-Text,语音转文字)和TTS(Text-to-Speech,文字转语音)端点则让系统支持语音交互,用户可对设备说话下达指令,Agent执行后以语音反馈结果,形成完整的对话式控制闭环。用户可以自行配置模型、STT和TTS的端点,不被绑定在任何厂商的云服务上。对于关心数据隐私、希望避免供应商锁定(vendor lock-in)的开发者来说,这种可自定义、可自托管的设计相当有吸引力。
这条路的价值与局限
潜在优势:通用性强,难以被检测
硬件级控制手机 AI Agent 的最大价值,在于它提供了一条通用且鲁棒的自动化通道。因为它模拟的是人类的物理操作,理论上可以跨任意应用工作,不受某个 App 是否开放 API、是否允许自动化的限制。对于需要跨应用连贯操作的复杂任务(比如从一个 App 复制信息到另一个 App),这种「屏幕即输入、模拟即输出」的方式格外自然。
此外,由于不修改目标设备,手机几乎对此「无感」,也更难被系统或应用识别为自动化行为。
现实局限:成本、延迟与规模化
当然,正如作者自己所言,这目前还是一个「开发板原型」,而非成熟的消费级产品。硬件方案天然面临几个挑战:
- 成本与部署门槛:需要额外的采集卡和 HID 控制器硬件,无法像纯软件那样零成本铺开;
- 性能与延迟:视频采集加多模态模型推理的链路,实时响应速度可能不如直接读取系统事件;
- 规模化困难:与硬件方案形成对比的是云端Android模拟器农场(Device Farm)模式。AWS Device Farm、BrowserStack、Firebase Test Lab等服务可以在云端并行运行数百个Android虚拟机实例,通过ADB或Appium远程控制,每台实例的边际成本极低(通常按分钟计费,折合每小时数美元),且支持一键水平扩展。硬件方案则面临「一套物理设备对应一台真机」的硬约束:采集卡(约50-200美元)、HID控制器(约10-50美元)、手机本身都是实体资产,批量部署意味着线性增长的硬件采购成本、机架空间占用、散热系统设计和人工维护开销,当设备规模超过数十台时,运营复杂度会急剧上升,难以像云端模拟器那样在分钟级内完成大规模并行部署。
- 设备兼容性边界:如前所述,方案依赖手机对DisplayPort Alt Mode的支持,中低端机型及部分国产旗舰存在兼容性风险,在大规模部署前需要逐一验证目标设备型号,这增加了选型和采购的前期验证成本。
外部硬件控制,是趋势还是巧思?
这个项目引出的核心问题是:外部硬件控制究竟是移动 AI Agent 的实用方向,还是仅仅一个聪明的原型?
从技术思路上看,它代表了 Agent 设计的一种「回归本源」——既然要让 AI 像人一样使用手机,那就在物理层面真正「像人一样」操作,而不是走操作系统留给开发者的后门。这种方式绕开了软件生态的种种限制,具备很强的通用性和抗封锁能力。
aiden并非孤例。在硬件级手机控制的商业化探索上,Anthropic在2024年推出的Computer Use API同样采用「截图+坐标点击」范式(面向桌面端),将AI操控计算机的能力以标准API形式开放,标志着这一范式获得了顶级AI实验室的背书;Rabbit的R1设备以Large Action Model驱动手机操作,尝试以独立硬件产品形态推动Agent落地;专注移动测试的公司(如Headspin、Perfecto)也已推出物理机械臂+摄像头的大规模自动化测试设备,本质上与aiden思路一致但工程化程度更高,已在部分车企和金融机构的硬件兼容性测试中规模化应用。这些探索共同指向同一个趋势:随着多模态模型推理成本持续下降(据统计GPT-4V级别的视觉推理成本在2023-2024年间下降超过90%),「视觉感知+物理输入」的通用控制范式正在成为Agent硬件形态的重要分支,其核心价值在于彻底解耦Agent能力与目标系统的软件开放程度——无论目标App是否提供API、是否欢迎自动化,硬件级控制都能以统一的方式处理。
但它能否走向实用,很大程度上取决于成本、延迟和规模化问题能否被解决。在当前阶段,它更可能成为特定场景(如硬件测试、需要绝对隔离的自动化、反检测要求高的任务)下的利器,而非通用消费方案。
无论最终走向如何,这个开源 demo 至少提供了一个宝贵的参考:在人人都用 ADB 和模拟器的时代,有人愿意从硬件层重新思考「AI 如何操作手机」这个问题,本身就值得关注。
相关推荐

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。