英伟达Nemotron 3.5 Super VL上线Ollama:单GPU智能体吞吐提升5倍

英伟达视觉语言模型 Nemotron 3.5 Super VL 上线 Ollama,官方称单 GPU 智能体吞吐提升 5 倍。
英伟达的视觉语言模型 Nemotron 3.5 Super VL 已正式上线 Ollama,开发者可通过 `ollama run nemotron-3.5-super` 一行命令在本地运行。该模型并非单纯的图像识别或纯文本推理模型,而是将视觉理解与多步推理融合进智能体工作流,可处理 GUI 自动化、文档与图表理解、多模态问答等需要感知与决策反复切换的任务。官方给出的核心数据是:单张 GPU 上智能体任务吞吐量最高可达同尺寸开源模型的 5 倍,这将直接放大端到端任务效率。借助 Ollama 分发,本地评估与私有化部署门槛进一步降低,但 5 倍为特定基准下的上限值,实际表现仍需社区在真实负载中验证。
英伟达Nemotron 3.5 Super VL上线Ollama:单GPU智能体吞吐提升5倍
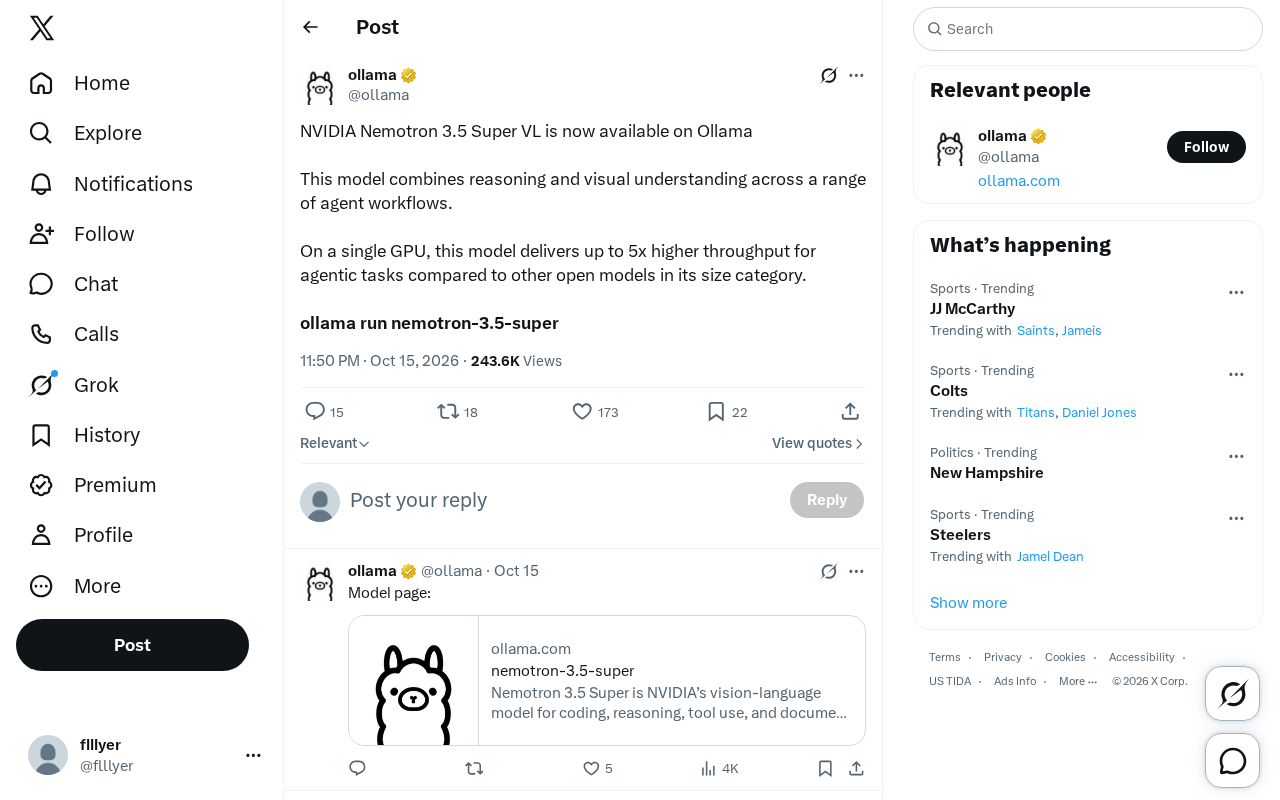
英伟达的视觉语言模型 Nemotron 3.5 Super VL 正式登陆 Ollama,开发者现在可以通过一行命令 ollama run nemotron-3.5-super 在本地运行这个兼具推理与视觉理解能力的模型。官方宣称,在单张 GPU 上,该模型处理智能体任务时的吞吐量可达同尺寸开源模型的 5 倍。
模型定位:为智能体工作流设计的视觉语言模型
Nemotron 3.5 Super VL 并非单纯的图像识别模型,也不是纯文本推理模型,而是将视觉理解与多步推理融合到智能体(agent)工作流中。这意味着它可以接收图像输入,进行场景解析、信息提取,并在此基础上完成规划、工具调用等需要连续推理的任务。
英伟达在推文中强调,该模型面向“a range of agent workflows”,即多种智能体场景。结合视觉能力,典型的应用包括 GUI 自动化操作、文档与图表理解、多模态问答等。这类任务往往需要模型在感知与决策之间反复切换,对推理效率和上下文管理提出更高要求。
视觉语言模型(VLM) 是一类同时接受图像与文本输入、并输出文本的模型架构。典型做法是用视觉编码器(如 ViT)把图像切分成 patch 并编码为向量序列,再通过投影层或 cross-attention 将这些视觉 token 对齐到大语言模型的表示空间,与文本 token 一起送入解码器。因此 VLM 的能力边界不只取决于语言主干,还取决于图文对齐质量与视觉分辨率策略。与单纯的图像分类或 OCR 模型相比,VLM 可以用自然语言指令灵活指定任务;与纯文本 LLM 相比,它多了一条感知通道,适合需要"看图决策"的场景。
智能体(agent)工作流 指模型不只在单轮问答中给出答案,而是循环执行"观察—推理—行动":解析当前状态(如屏幕截图或工具返回结果)、规划下一步、调用工具(点击、检索、读写文件),再根据新观察继续决策,直到任务完成。这种范式对模型的要求与聊天场景明显不同:需要稳定的结构化输出(如工具调用参数)、较长的上下文以保留历史观察、以及较低的單次推理延迟——因为一个任务往往要发起数十次模型调用,端到端体验是单次延迟与调用次数的乘积。
性能亮点:单GPU吞吐量达同类5倍
官方给出的核心数据是:在单张 GPU 上,Nemotron 3.5 Super VL 在智能体任务中的吞吐量最高可达同尺寸其他开源模型的 5 倍。吞吐量对于智能体应用尤为关键——智能体通常需要多次模型调用才能完成一个任务,单次推理速度的提升会直接放大为端到端任务完成效率的提升。
这一指标如果能在真实负载中复现,意味着同样的硬件条件下可以支撑更高并发的智能体服务,或者在同等吞吐下降低单位任务成本。不过需要注意,5 倍是官方在特定基准和配置下测得的上限值,实际表现会因任务类型、批量大小和硬件环境而异。
吞吐量(throughput)与延迟(latency) 是两个容易混淆的指标。延迟指单次请求从发出到返回的耗时,吞吐量指单位时间内系统能完成的请求数或生成的 token 数,通常以 tokens/s 或 requests/s 计量。吞吐量可通过批处理(batching)、KV cache 复用、量化、投机解码等手段提升,但提升批大小往往会牺牲单请求延迟。智能体场景的特殊性在于并发请求多、输入中图像与历史上下文占比高,因此预填充(prefill)阶段的开销占比大,针对这一环节的优化往往比解码加速更能体现吞吐收益。评估 5 倍这类倍数时,需要确认基准的批量大小、序列长度、是否启用并行以及对比的具体模型版本。
Ollama 生态加持:本地部署门槛进一步降低
Ollama 已经成为本地运行开源大模型的事实标准工具之一,其优势在于极简的模型拉取与运行体验。Nemotron 3.5 Super VL 加入 Ollama 模型库,意味着开发者无需自行处理复杂的推理框架配置,就能在本地或私有环境中试用这一视觉语言模型。
对于关注数据隐私或需要在离线环境部署智能体的团队来说,这一渠道的开通降低了评估成本。开发者可以先用少量样本验证模型在自己业务场景中的表现,再决定是否投入更多资源进行规模化部署。
Ollama 是一个开源的本地模型运行时,内部封装了模型权重下载、量化格式(GGUF)加载、GPU/CPU 混合推理与统一的 HTTP API(默认监听 11434 端口),并提供 OpenAI 兼容接口。它把模型权重、提示模板与参数配置打包为 Modelfile,使 ollama run 一条命令即可完成拉取与启动。对多模态模型而言,Ollama 通过 API 的 images 字段接收 Base64 编码图像。需要注意的是,本地运行的实际显存占用与量化等级(如 Q4、Q8)密切相关,量化会带来精度损失,因此社区实测的吞吐与准确率可能与官方 FP16 基准存在差距。
对开发者意味着什么
视觉语言模型与智能体框架的结合正在成为开源社区的热点方向。Nemotron 3.5 Super VL 通过 Ollama 分发,把英伟达在多模态推理上的工程优化带到了个人开发者和小型团队触手可及的范围。
接下来的观察点在于社区实测:5 倍吞吐提升在不同 GPU 型号、不同智能体框架下是否稳定成立,以及模型在 GUI 操作、图表理解等具体任务上的准确率表现。这些数据将决定它能否从“值得一试”变成“生产可用”。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。