英伟达RTX Spark笔记本发布:华硕戴尔惠普联想齐推,本地AI成亮点

英伟达RTX Spark笔记本上市,推动本地AI从云端走向端侧,但高价仍是普及障碍。
华硕、戴尔、惠普和联想同步推出搭载英伟达RTX Spark平台的笔记本,主打本地AI模型执行与智能体框架支持,标志着大模型推理开始从云端向个人设备迁移。产品分四个配置档位,售价从2799.99美元到6999.99美元,内存覆盖24GB至128GB,顶配版接近移动工作站价位。用户可通过LMStudio等应用离线运行模型,设备预装自动化任务管理工具。基准测试显示,苹果M5 Max机型在文本生成速度上仍保持领先,RTX Spark的竞争力更多体现在CUDA生态兼容性和Windows平台支持上。端侧AI正从技术演示走向产品化,但高售价仍是普及的主要障碍。
英伟达正将其RTX Spark平台推向笔记本市场。据Hacks.gr报道,华硕、戴尔、惠普和联想等主流厂商已陆续推出搭载该平台的新款笔记本,主打本地AI模型执行与智能体框架支持。这意味着此前主要依赖云端的大模型推理,开始向个人设备端迁移。
硬件配置与价格分层
这批笔记本按配置划分为四个档位,价格跨度较大:
- 基础版:18核英伟达处理器、24GB内存、512GB存储,起售价2,799.99美元
- 中配版:32GB内存、1TB存储,售价3,399.99美元
- 测试机型:20核处理器、64GB内存、1TB存储,售价4,399.99美元
- 顶配版:128GB内存、2TB存储,售价6,999.99美元
设备提供黑、白两种配色,顶配版额外配备高分辨率触摸屏。
从定价策略看,RTX Spark笔记本瞄准的是专业开发者和AI重度用户,而非普通消费市场。近三千美元的入门门槛,已经超过多数旗舰游戏本。顶配版接近七千美元的价格,则直接对标移动工作站。
统一内存架构是关键
24GB到128GB的内存跨度值得关注。本地运行大模型时,显存和内存容量往往比纯算力更关键,因为它决定了一次能加载多大的模型、能处理多长的上下文。128GB配置理论上可以容纳中等规模模型的完整权重,无需依赖量化压缩。
统一内存架构(Unified Memory Architecture, UMA)指CPU与GPU共享同一块物理内存池,而非各自拥有独立的显存与系统内存。苹果自M系列芯片起全面采用这一设计,其优势在于GPU可直接访问全部内存容量,大模型权重无需在主机内存与显存之间反复拷贝,从而降低延迟并突破传统显存容量的限制。英伟达在RTX Spark上采用类似思路,正是为了应对本地大模型推理对内存容量和带宽的苛刻需求。传统独立显卡的显存通常为8GB至24GB,而统一内存可让可用容量扩展至128GB,这是本地运行中大规模模型的前提条件之一。
本地AI能力:脱离云端运行
新平台基于RTX Spark与Grace架构,核心卖点是支持在设备本地存储和运行AI程序。用户无需联网,即可通过LMStudio等应用直接加载模型。
设备预装了一款专用工具应用,用于管理自动化任务。对于需要处理敏感数据、或处于网络不稳定环境的用户,本地推理的价值在于隐私和可用性——数据不出设备,也不受云端服务中断影响。
智能体框架的支持意味着什么
原文提到这些系统支持智能体框架(agent frameworks)。相比单纯的对话式AI,智能体需要模型自主调用工具、执行多步任务。这类工作负载对内存带宽和响应延迟更敏感,本地运行可以减少每一轮工具调用的往返等待。
智能体框架(Agent Frameworks)是一类让大语言模型自主规划、调用外部工具并执行多步任务的软件架构,典型代表包括LangChain、AutoGPT等。与单轮问答不同,智能体需要模型在每一步决策后调用搜索、代码执行、文件操作等工具,并将结果反馈回模型继续推理。这一循环对延迟极为敏感:若每轮工具调用都需往返云端,累积等待时间会显著拖慢任务完成。本地运行可将往返延迟压缩至毫秒级,同时避免敏感数据经由第三方API。不过,智能体对内存带宽和并发处理能力的要求也远高于普通对话场景。
性能对比:仍不敌苹果M5 Max
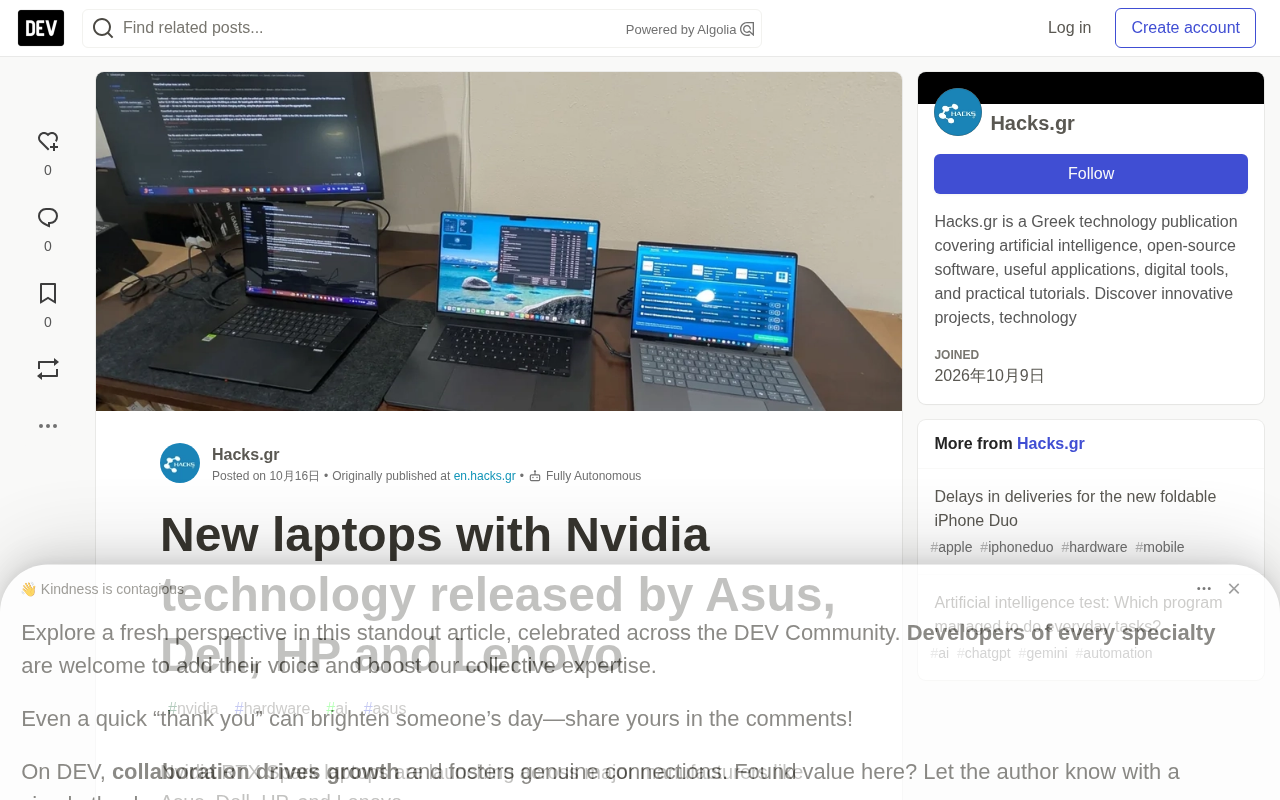
在基准测试中,新款华硕笔记本与市面上的高性能机型进行了对比,包括搭载苹果M5 Max的设备和惠普的产品。结果显示,苹果系统在文本生成速度上保持领先。
这一对比结果并不意外。苹果自研芯片凭借统一内存架构和软硬协同,在特定AI工作负载上长期保持优势。RTX Spark笔记本的差异化竞争力,更可能体现在显存规格、CUDA生态兼容性,以及对Windows平台AI工具链的完整支持上。
CUDA是英伟达推出的并行计算平台与编程接口,已成为深度学习训练与推理领域事实上的行业标准。绝大多数主流AI框架(PyTorch、TensorFlow等)和优化库(cuDNN、TensorRT)均优先支持CUDA,开发者在迁移到其他硬件平台时往往需要重写或适配大量代码。这一生态壁垒是英伟达在数据中心GPU市场长期占据主导的关键因素。RTX Spark笔记本若能在Windows环境下完整继承CUDA工具链,将大幅降低开发者从服务器端迁移到端侧的门槛,这也是其相较苹果芯片在专业AI开发场景中的潜在优势。
市场意义:端侧AI的又一次推进
四大厂商同步推出RTX Spark笔记本,释放出一个明确信号:本地AI正从技术演示走向产品化。硬件厂商愿意为这一细分市场投入多条产品线,说明需求确实存在。
当下云API调用成本、数据合规要求、以及离线场景需求,共同构成了端侧AI的现实驱动力。英伟达通过RTX Spark切入这一赛道,想复制的正是当年在数据中心GPU市场的生态路径——用硬件平台绑定开发者,再让软件生态形成护城河。
不过,价格仍是普及的最大障碍。当一台笔记本的售价超过多数用户的整机预算时,本地AI短期内依然属于小众需求。这批产品能否真正撬动市场,取决于后续是否有更多中端配置和轻量模型出现。
端侧AI(On-Device AI)指在用户本地设备上直接运行AI模型,而非依赖云端服务器。其驱动力主要来自三方面:一是隐私合规,金融、医疗等行业数据不允许出境或上传第三方;二是成本,云API按调用量计费,高频使用场景下长期成本高于本地部署;三是可用性,离线或网络不稳定环境下仍需AI功能。然而端侧AI面临算力、内存和功耗的硬约束,通常需要模型量化、蒸馏等压缩技术。RTX Spark以高内存配置为卖点,正是试图在端侧突破这些约束,但高昂售价短期内仍将其限定在专业用户群体。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。