英伟达Vera Rubin NVL72登顶MLPerf智能体推理榜
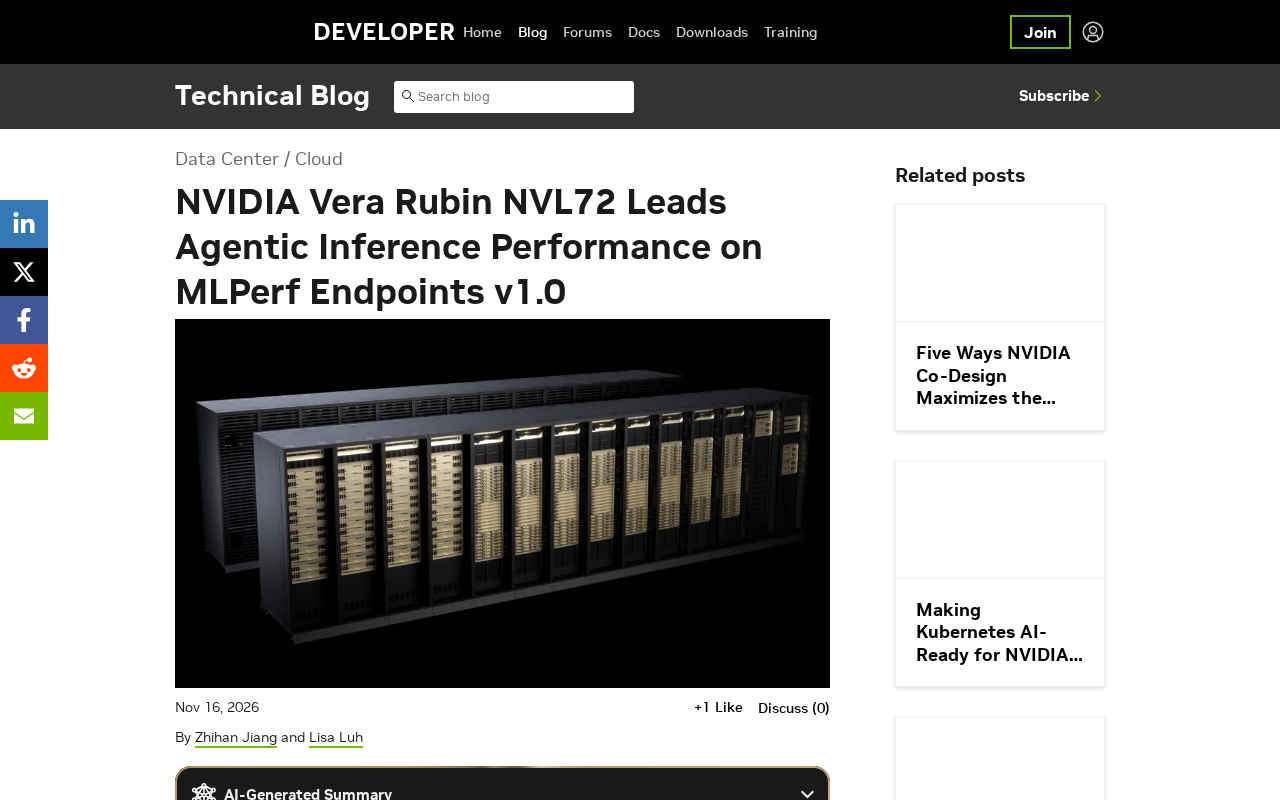
英伟达Vera Rubin NVL72在MLPerf Endpoints v1.0智能体推理基准中领先,凸显系统级设计价值。
英伟达在MLPerf Endpoints v1.0基准测试中,用Vera Rubin NVL72交出了针对智能体推理的成绩。该基准将评测对象从单次问答转向多轮、带工具调用和推理链的智能体负载,衡量端点级系统在长上下文、链式调用下的真实表现。英伟达的领先被归因于机架级系统设计:互联带宽、KV缓存管理和工具调用调度开销的协同优化,恰好匹配了新基准的负载特征。文章指出,智能体推理正在改变硬件选型逻辑,从单轮token吞吐转向端到端任务完成效率,缓存命中率与上下文复用权重上升。同时提醒该基准较新,需结合其他厂商后续提交结果交叉判断。
英伟达在MLPerf Endpoints v1.0基准测试中,用Vera Rubin NVL72交出了一份针对智能体推理的答卷。这个新基准的出现,本身比排名更值得关注:它把评测对象从单次问答转向了多轮、带工具调用和推理链的智能体负载。
MLPerf Endpoints v1.0测的是什么
传统推理基准大多测单轮请求:给定prompt,生成回答,看延迟和吞吐。智能体的工作方式完全不同——它要携带不断增长的对话历史跨轮次运行,并在一次任务中混合生成推理内容、调用工具、读取返回结果再继续推理。
据英伟达技术博客的描述,这类负载对推理系统提出了更高要求:上下文越来越长,请求模式不再是整齐的批量推理,而是带有依赖关系的链式调用。MLPerf Endpoints v1.0正是为这种场景设立的端点级评测,衡量的是系统在真实智能体交互下的表现。
MLPerf 是由 MLCommons 联盟主导的机器学习基准测试系列,早期以训练(Training)和推理(Inference)两大套件闻名,后者长期以单次请求的延迟和吞吐为核心指标。Endpoints 是其较新的分支,定位在“端点级”评测,即把模型服务放在更接近真实应用入口的位置来考察,强调请求到达模式、多轮交互和端到端响应,而非孤立的单次推理。与数据中心套件相比,Endpoints 更关注服务化部署中的调度、缓存和会话状态管理,这也解释了它为何适合承载智能体负载的评测需求。
Vera Rubin NVL72为何在该基准领先
英伟达给出的答案是系统级设计。Vera Rubin NVL72把加速器、网络和软件栈作为一个整体来优化,面向的正是长上下文、多轮交互的推理负载。在智能体场景中,单卡算力不再是唯一瓶颈,机架内的互联带宽、KV缓存的管理效率、以及工具调用往返时的调度开销,都会直接影响端到端体验。
从这个角度看,NVL72的领先并不只是芯片层面的胜利,而是机架级架构与新基准负载特征匹配的结果。基准测试衡量的端点性能,恰好放大了这种系统协同的价值。
KV 缓存是自回归推理中用于存储已生成 token 的键值对(Key/Value)的结构,避免每生成一个新 token 都重新计算整个上下文。在智能体场景下,对话历史跨轮增长、工具返回结果又不断追加,KV 缓存会迅速膨胀,其显存占用和管理策略直接决定能支撑多长的上下文以及多少并发会话。高效的 KV 缓存复用可以让多轮请求共享前缀计算结果,减少重复计算;而缓存淘汰、分页和跨设备迁移的开销,则会影响端到端延迟。因此,KV 缓存管理效率是长会话推理系统中与算力同等关键的瓶颈之一。
智能体推理正在改变硬件选型逻辑
过去选推理硬件,看的是单位时间能跑多少token。智能体负载把这个指标拆解得更细:一次任务可能包含多轮模型调用和多次工具往返,用户感知的是整个任务完成的时间,而不是单次生成的速度。
这意味着缓存命中率、跨轮上下文的复用效率、以及请求排队策略的权重都在上升。英伟达强调Vera Rubin NVL72在智能体推理上的表现,实质是在推销一种面向长会话、工具密集场景的系统设计思路。对打算部署智能体应用的团队来说,基准结果提供了一个参考坐标,但真实收益仍取决于具体负载形态。
工具调用(tool calling)指模型在生成过程中输出结构化指令,请求外部函数、API 或检索系统执行操作,再将返回结果拼回上下文继续推理。它把一次用户任务拆成多轮“模型—工具—模型”的往返,每轮都伴随请求排队、网络往返和上下文拼接。与纯文本生成相比,工具调用的延迟不再只由 token 生成速度决定,还取决于调度器能否在等待工具返回时让出计算资源、并行处理其他会话。这正是端点级基准要衡量的链式依赖开销,也是系统级设计在智能体负载下价值被放大的原因。
怎么看这份成绩
MLPerf Endpoints v1.0还是一个较新的基准,参与厂商和提交结果的多样性有待观察。英伟达作为基准的推动方之一,其硬件在自家主导的评测维度上领先,需要结合后续其他厂商的提交结果来交叉判断。
更实际的启示是:智能体应用落地时,推理基础设施的评估标准应当随之更新。单轮吞吐的数字好看,不代表多轮工具调用场景下体验流畅。Vera Rubin NVL72登上该基准榜首,至少说明系统级优化路线在智能体负载下是被验证有效的方向。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。