用AI Agent和住宅代理自动搜职位,精准匹配不求人

开发者用MCP搭建AI Agent,结合住宅代理抓取数千DevOps岗位,让Claude按简历打分筛选。
文章介绍了一位开发者用MCP协议搭建的求职筛选系统:通过住宅代理抓取Greenhouse、Lever、Ashby等招聘板上的数千个DevOps相关岗位,再让Claude依据profile.md中的目标岗位与偏好逐条打分排序,最终从5200多条职位中挑出最匹配的5条。对照实验显示,无代理时362个请求被识别为机器人而拒绝,改用住宅代理后1000个页面全部成功、零错误。作者明确反对AI自动投递简历,认为AI只应负责信息检索与初筛,决策和投递留给人。代理成本按流量计费,演示抓取5200多条职位仅约0.0004美元。
用AI Agent和住宅代理自动搜职位,精准匹配不求人
求职最耗时的环节往往不是面试,而是从海量招聘信息里筛出真正匹配的那几条。一位开发者用MCP(Model Context Protocol)搭建了一套AI Agent,结合住宅代理抓取数千个DevOps岗位,再让Claude按简历逐条打分排序。整套流程不自动投递,只做"精准筛选",把重复劳动交给机器,把判断权留给自己。
为什么要用住宅代理抓职位?
直接用本机IP抓招聘网站,问题很快暴露。视频演示中,未使用代理的抓取被362个站点拒绝,返回的是"服务器繁忙"或"机器人页面",而非职位数据。很多招聘站点会识别爬虫行为,也有部分站点存在地域限制,只对特定国家开放。
解决方案是住宅代理(Residential Proxy)。与数据中心代理不同,住宅代理的IP来自真实家庭宽带,行为特征与普通用户一致,不容易触发风控。作者选用的DataImpulse按流量计费,1美元/GB、即用即付、无订阅,演示中购买了5GB流量。配置时只需把代理服务的登录名、密码、主机和端口填入项目的.env文件,再运行测试脚本验证连通性。
测试结果显示:直连IP定位在加拿大,走代理后出口IP变为美国纽约,说明代理已生效。项目还配置了轮换IP和粘性IP,覆盖美国、英国、德国、印度等多个国家,为后续跨地区抓取打基础。
住宅代理与数据中心代理的区别:数据中心代理的IP虽然也由服务商批量持有,但网段集中、归属明确,招聘网站的风控系统很容易通过ASN(自治系统编号)或IP信誉库将其标记为机房流量并直接拦截。住宅代理则通过合作网络把终端用户的家庭宽带IP借出来转发请求,这些IP天然绑定真实ISP和地理区域,在目标站点看来与普通访客无异。代价是带宽成本更高、延迟略大,且部分服务商对并发和会话时长有限制。作者选用的按流量计费模式适合抓取这种“请求多、单页体积小”的场景,用多少付多少,不会因订阅周期浪费预算。
对比实验:无代理 vs 有代理
作者做了一组直观的对照实验。无代理抓取时,638个招聘页面中只有部分成功,362个请求被拒绝,最终拿到约4000条职位,其中仅9个明确提供签证担保。同样的抓取任务走住宅代理后,1000个招聘页面全部成功返回,使用37个不同的家庭住宅IP,零错误、零拒绝。最终抓到5200多条职位,所有请求都返回200状态码。
这组数据说明,代理不只是"绕过封锁",更直接影响数据完整度——被拒绝的请求意味着你根本看不到那部分机会。当然,作者强调这是"合乎伦理"的使用方式:只做信息检索,不进行大规模自动投递。
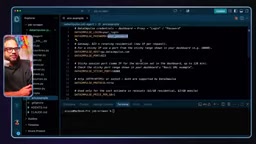
项目结构:从profile.md到MCP服务器
整个项目围绕几个核心文件展开:
- sources:列出要抓取的招聘来源,包括Greenhouse、Lever、Ashby等提供公开API的招聘板,以及Amazon Jobs等大型站点。
- MCP服务器逻辑:定义了通过代理抓取数据时的指令、消息日志级别和可用工具。
- Geo.py:提供货币、IP、URL等地理参考数据。
- profile.md:求职者的"数字简历",写明目标岗位(如DevOps工程师、平台工程师、云工程师、解决方案架构师)、经验年限、所在国家和偏好地点。这份文件是后续AI匹配的唯一依据,写得越具体,筛选越准。
MCP服务器在本地运行,共暴露10个工具,包括sweep_jobs(批量抓取)、get_job(读取单条职位)、track_job(记录跟踪)、proxy等。作者特意说明,MCP不是通用大模型,而是带有你个人上下文的服务器,知道数据从哪里来、按什么规则处理。
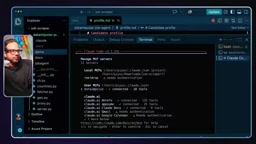
MCP(Model Context Protocol)是什么:它是一套开放协议,用于让大模型客户端(如Claude Desktop、Claude Code)以标准化方式连接外部工具和数据源。MCP服务器把一组“工具”暴露给模型,每个工具有名称、描述和JSON Schema参数定义;模型在对话中根据用户意图决定调用哪个工具、传什么参数,客户端负责实际执行并把结果回传给模型。与直接写死的脚本相比,MCP的好处是工具可复用、可组合,且模型能自主规划调用顺序。文章中的sweep_jobs、get_job、track_job等10个工具就是通过这种方式注册的,Claude在打分时会自行决定先抓取、再逐条读取、最后输出排名。
让Claude按简历打分:从5200条到5条
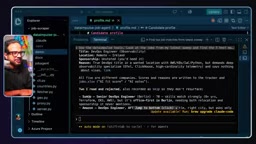
抓取只是第一步。真正体现AI价值的是筛选环节。作者在Claude中通过claude mcp add命令接入本地MCP服务器,确认连接成功后,输入提示词:使用data_impulse工具查看最新一轮抓取结果,从profile.md出发找出最匹配的5个职位(每个公司最多1个),用get_job读取每条职位详情,给出0-100的匹配分,并附一句话理由,最后输出排名表和用量收据。
Claude的执行过程包括加载工具schema、读取项目上下文、按公司去重、逐条读取职位并打分。最终输出的Top 5中,第一名是某公司的Senior Staff Cloud Platform Engineer,得分92,地点为加拿大或美国远程,无需签证担保。更重要的是拒绝逻辑:一个柏林办公室优先、需要搬迁和签证担保的岗位被排除,一个初级/中级要求的岗位也被排除——因为profile.md里明确写了只要远程、且经验要求匹配。
这正是作者反复强调的观点:不要让AI自动投递简历。批量投递只会被市场上的AI筛选工具直接拒绝,毫无意义。AI应该做的是帮你从几千条信息中挑出值得你亲自申请的那几条。
为什么“按公司去重”和“逐条读取详情”是两个独立步骤:抓取阶段拿到的职位列表通常只有标题、公司、地点等摘要字段,不足以判断匹配度;而get_job读取的详情页才包含职级要求、是否提供签证担保、远程政策等关键信息。如果直接让模型对摘要打分,很容易被标题误导。作者在提示词中限定“每个公司最多1个”,是为了避免同一家公司的多个相似岗位挤占Top 5名额,把机会分散到更多雇主。这种“先粗筛去重、再精读打分”的两段式流程,也是AI Agent处理大规模候选集时的常见做法,能显著降低token消耗和误判率。
成本与实用建议
演示中抓取5200多条职位的代理成本约为0.0004美元(按1美元/GB计算),整个演示累计花费0.44美元,账单里可以逐条查看每个站点的请求数、流量和费用,部分请求甚至没有产生费用。对个人求职者来说,这个成本几乎可以忽略。
几条实践建议:profile.md要尽可能具体,明确远程/坐班、经验级别、地点偏好,AI的拒绝理由才会合理;sources文件按需增删,优先使用提供公开API的招聘板,抓取更稳定;最终职位列表会导出为Excel,包含匹配分和原始链接,方便逐条核对后手动投递。
这套方案的价值不在于"全自动",而在于把信息收集和初筛这两个最枯燥的环节交给Agent,把决策和投递留给人。对正在找DevOps、云平台类岗位的工程师来说,是一个值得动手复现的实用项目。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。