用AI Agent加速ROS 2节点:NVIDIA Isaac ROS实践解析
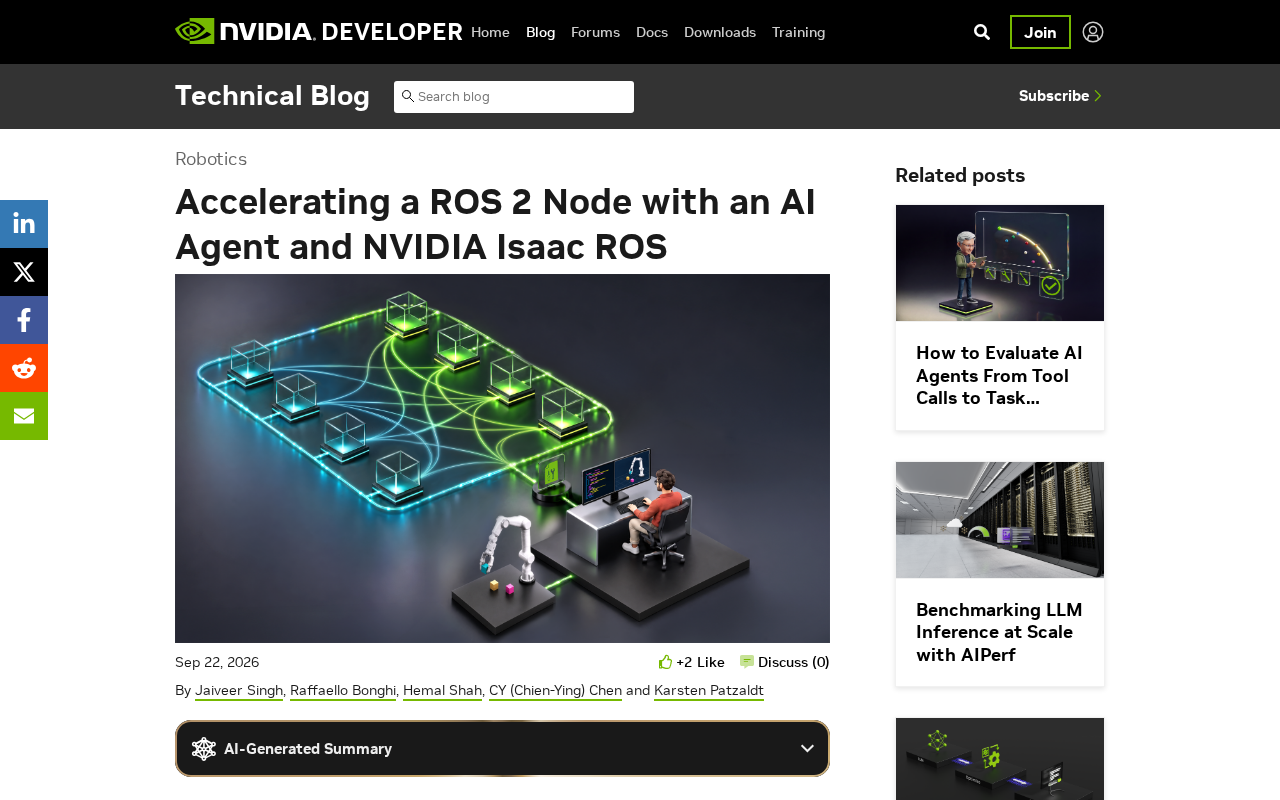
GPU加速单个内核不等于ROS 2整图提速,数据搬运才是真正瓶颈,Isaac ROS用零拷贝从管线全局解决问题。
NVIDIA这篇技术分享揭示了机器人GPU加速中一个常被忽视的盲区:ROS 2系统的性能瓶颈往往不在于CUDA内核的执行速度,而在于节点间消息传递带来的序列化、内存拷贝和CPU-GPU数据搬运开销。Isaac ROS通过零拷贝机制和类型适配让数据尽可能"留在GPU上",从整条计算管线的角度优化吞吐量,而非只优化单个算子。文章还指出,AI Agent可以协助开发者识别可加速的环节并生成符合Isaac ROS规范的代码,降低了高性能机器人开发对CUDA专业知识的门槛要求。对于实践者,文章归纳出三条原则:用全局视角定位真实瓶颈、重视异构计算中数据流转的隐性成本、以及善用成熟工具链缩短开发周期。
在机器人开发中,GPU加速一直被视为提升计算密集型工作负载的利器。但一个残酷的现实是:光有快速的CUDA内核,并不能保证整个ROS 2计算图也随之变快。NVIDIA在这篇技术分享中揭示了机器人系统性能优化的一个关键盲区——数据在节点之间流转的开销,往往才是真正的瓶颈。

GPU加速为何不等于ROS 2图加速
ROS 2作为主流机器人操作系统框架,其架构核心是由多个节点(Node)组成的计算图。传感器数据、感知结果、控制指令都以消息(Message)的形式在这些节点之间传递。
问题恰恰出在这里。当开发者把某个计算密集环节(比如图像处理或点云滤波)迁移到GPU上后,单个内核的执行速度确实大幅提升。但如果消息在CPU与GPU之间频繁拷贝,或者在节点间序列化/反序列化的开销过大,整个数据管线的吞吐量并不会因为单点加速而显著改善。
换句话说,机器人系统的性能是由整条数据链路的最慢环节决定的。一个孤立的高速CUDA内核,在充满内存拷贝和数据搬运的图结构中,反而可能被淹没在通信开销之中。这也是很多团队在引入GPU加速后感到"提速不明显"的根本原因。
从架构层面理解这个问题需要了解ROS 2的底层通信机制。ROS 2默认采用DDS(Data Distribution Service)作为中间件,节点间的消息传递涉及序列化(将内存中的数据结构转换为字节流)、网络传输和反序列化三个步骤。即使在同一台机器的进程间通信中,DDS的零拷贝共享内存优化也并非默认启用,消息往往要经历多次内存复制。对于图像(每帧数MB)或点云(数十万个三维点)这类大体量数据,每次节点间传递的序列化开销可能轻松超过GPU内核本身的执行时间。更糟糕的是,当数据从GPU显存传回CPU主机内存(为了序列化),再在下一个节点的GPU内核运行前重新上传到显存时,PCIe总线带宽就成了整个系统的硬性瓶颈——PCIe 4.0 x16理论带宽约32 GB/s,但实际可用带宽远低于此,而现代GPU的显存带宽可达数TB/s,两者之间存在数量级的差距。
Isaac ROS的加速思路:减少数据搬运
NVIDIA Isaac ROS正是为解决这一痛点而设计的。它的核心理念不是单纯让某个算子跑得更快,而是从整个计算图的角度优化数据流。
关键手段之一是尽可能让数据"留在GPU上"。通过零拷贝(zero-copy)机制和类型适配(type adaptation),Isaac ROS允许GPU上的处理结果在节点间直接传递,避免了反复在主机内存与显存之间搬运数据。当一整条感知管线的多个节点都运行在GPU上时,这种优化带来的收益是成倍放大的。
这种设计思路对机器人开发者有直接的启示:优化不应只盯着单个算法,而要审视整个消息流转路径。哪些数据被不必要地拷贝了?哪些序列化步骤可以省去?这些系统级的问题,往往比算法本身的优化空间更大。
零拷贝(zero-copy)和类型适配(type adaptation)是ROS 2 Humble版本引入的两项关键机制,Isaac ROS深度依赖这两项能力。类型适配(REP-2007提案)允许开发者为ROS消息类型注册一个"适配类型",节点内部直接操作适配类型(例如CUDA设备指针封装的GPU张量),只在真正需要跨进程传输时才进行转换。零拷贝机制则依赖iceoryx或类似的共享内存中间件,让发布者和订阅者直接引用同一块内存区域,消除复制操作。两者结合后,一条全部运行在同一GPU上的Isaac ROS感知管线——例如图像解码→畸变校正→目标检测——可以让原始图像数据从进入显存后就再也不离开,所有中间结果以GPU内存句柄的形式在节点间"传递",实际并不发生任何数据移动。这与传统ROS 2管线相比,可将端到端延迟降低一个数量级。
AI Agent介入开发流程的意义
本文标题中另一个亮点是引入"AI Agent"来加速ROS 2节点的开发。这代表了机器人软件工程的一个新趋势——用AI辅助工具来处理性能优化中繁琐、需要专业知识的部分。
传统上,将一个普通ROS 2节点改造为GPU加速节点,需要开发者深入理解CUDA编程、内存管理、Isaac ROS的类型适配接口等多方面知识。这道门槛把不少机器人工程师挡在了高性能开发的门外。
AI Agent的价值在于,它能够理解现有代码逻辑,识别出可以加速的环节,并协助生成符合Isaac ROS规范的加速代码。这种"AI+专业框架"的组合,本质上是在降低高性能机器人开发的技术门槛,让更多开发者能够享受到GPU加速的红利,而不必成为CUDA专家。
将普通ROS 2节点改造为Isaac ROS加速节点,涉及的工程细节远不止替换几个函数调用。开发者需要正确使用rclcpp::TypeAdapter模板、管理CUDA流(CUDA Stream)的生命周期以确保异步操作的正确同步、处理GPU内存的分配与释放、以及遵循Isaac ROS对节点生命周期和参数接口的特定约定。AI Agent在这一场景下的角色类似于一个掌握完整框架文档和最佳实践的结对程序员:它可以静态分析现有节点代码,识别出数据热路径,判断哪些操作适合迁移到GPU,并生成包含正确CUDA同步原语的样板代码。这种能力对于中小型机器人团队尤为关键——这类团队通常有出色的算法工程师但缺乏专职的系统级性能工程师,AI Agent可以填补这一人才缺口,使团队无需深入学习CUDA编程模型就能获得接近专家级别的优化效果。
对机器人开发者的实践价值
从这篇技术分享中,可以提炼出几条对实际开发有指导意义的原则。
第一,性能优化要有全局视角。在动手加速某个节点之前,先用性能剖析工具找出真正的瓶颈所在,避免把精力浪费在对整体影响不大的局部优化上。
第二,重视数据流转成本。在异构计算(CPU+GPU)的场景下,数据搬运的开销经常被低估。选择支持零拷贝的框架,能从架构层面规避这类隐性损耗。
第三,善用工具链降低门槛。无论是Isaac ROS提供的现成加速组件,还是AI Agent这样的辅助工具,都能显著缩短开发周期。对于资源有限的团队,站在成熟工具的肩膀上远比从零造轮子更明智。
随着具身智能和机器人应用的快速发展,这类聚焦系统级性能优化的工程方法,正变得越来越重要。NVIDIA将GPU加速、专业机器人框架与AI辅助开发结合的路径,也为整个行业提供了一个值得借鉴的范式。
相关推荐
AI玩《我的世界》141小时被苦力怕炸出"抑郁",只肯种土豆
海外机构Wars AI让GPT-6 Atra独立游玩《我的世界》141小时,AI进度超越所有前辈却被苦力怕炸得资源归零,随后陷入只肯种土豆的"抑郁"状态。本文解析这场实验背后AI智能体的能力与局限。
豆包AI漫剧量产教程:从素材到分镜的全流程实操
AI漫剧全流程实操教程:如何用豆包完成正版素材筛选、专家模式爆款剧本改写与Seedance模型分镜设计,帮助新手规避版权与改编两大门槛,稳定量产红果漫剧作品。
LangChain九月更新解析:委托访问与Agent可观测性升级
LangChain九月版本更新详解:为沙箱引入委托式LangSmith访问、支持stop_reason捕获的SDK运行追踪、修复ReDoS安全漏洞,并覆盖LangChain OpenAI、Anthropic及LangGraph CLI等生态包,全面提升agent工作流的可观测性与可靠性。